UTA学习率衰减:闭环自适应突破训练瓶颈
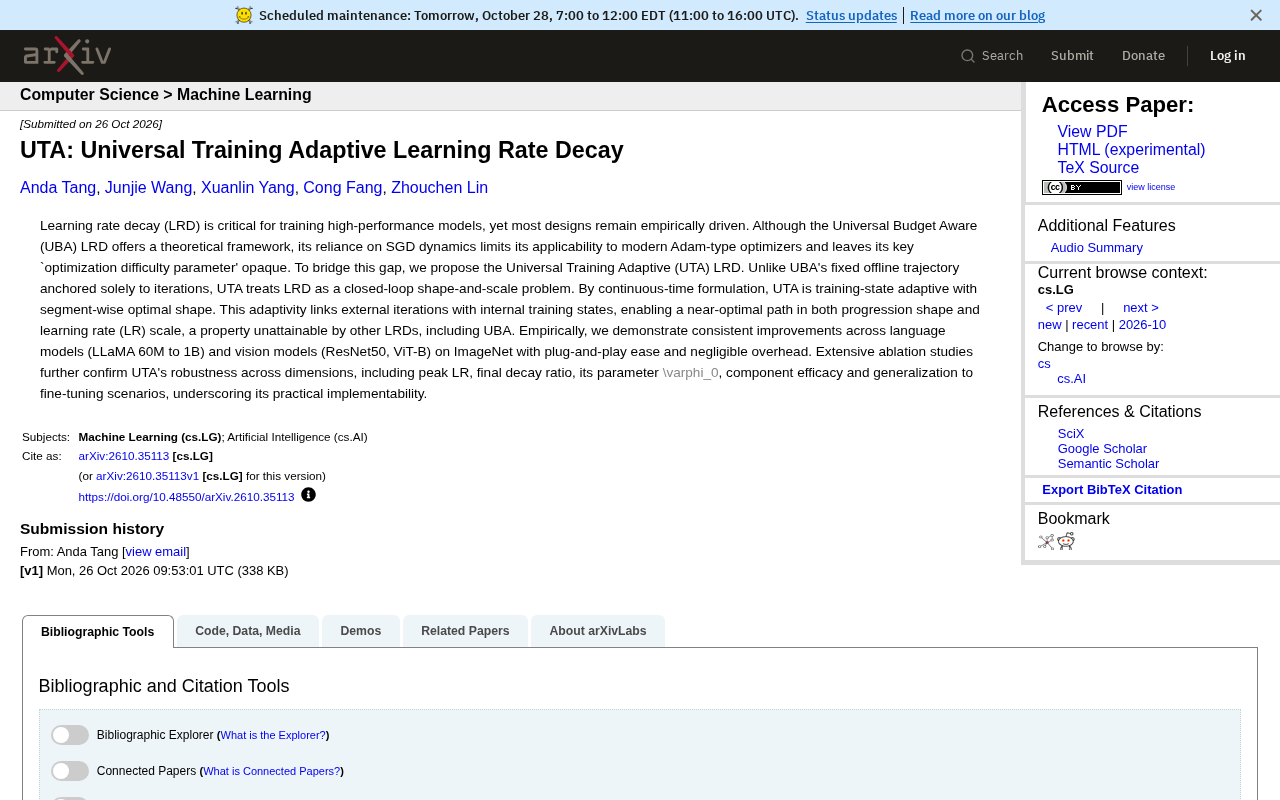
UTA将学习率衰减重构为闭环形状与尺度问题,兼容Adam并在多模型上一致提升。
文章介绍了通用训练自适应学习率衰减(UTA)方法。针对现有通用预算感知(UBA)方法依赖SGD动力学、难以适配Adam类优化器且核心参数含义模糊的问题,UTA将学习率衰减重构为闭环控制问题,通过连续时间建模,使学习率曲线在每一段上根据当前训练状态自适应地选择最优形状与尺度。该方法不依赖特定优化器,即插即用且额外开销可忽略,对峰值学习率、最终衰减比例、参数φ₀及微调场景均表现鲁棒。实验在LLaMA架构(60M至1B参数)以及ResNet50、ViT-B的ImageNet任务上取得一致提升。文章认为这标志着学习率调度从经验规则向自适应控制转变,有望减少人工调参并提升训练效率。
学习率衰减(LRD)是训练高性能模型的关键,但多数设计仍依赖经验驱动。近期提出的通用预算感知(UBA)LRD虽提供了理论框架,却因依赖SGD动力学而难以适配现代Adam类优化器,且其核心的“优化难度参数”含义模糊。为此,研究者提出通用训练自适应(UTA)LRD,将LRD视为闭环的形状与尺度问题,通过连续时间公式实现训练状态自适应与分段最优形状,在语言模型和视觉模型上均带来一致提升。
UTA的核心机制:从开环到闭环
UTA与UBA的本质区别在于是否与训练状态联动。UBA依赖固定的离线轨迹,仅锚定迭代次数,因此无法根据模型内部状态动态调整。UTA则将LRD重构为闭环控制问题:通过连续时间建模,学习率曲线在每一段上都能根据当前训练状态自适应地选择最优形状。这种机制将外部迭代与内部训练状态(如梯度统计量)联系起来,使学习率在进展形状和尺度上逼近最优路径。
UTA的另一个优势是理论上的通用性。它不依赖于SGD的特定动力学,因此能无缝集成到Adam等现代优化器中,且即插即用、额外开销可忽略。论文通过大量消融实验验证了UTA对峰值学习率、最终衰减比例、参数φ₀以及微调场景的鲁棒性。
通用预算感知(UBA)学习率衰减:UBA 是此前提出的一类学习率衰减设计框架,其核心思想是在给定总训练预算(即总迭代步数)的前提下,通过离线计算得到一条“最优”学习率曲线,并以迭代次数作为唯一锚点驱动学习率变化。由于整条曲线在训练开始前就已确定,UBA 本质上是一种开环控制:无论模型在训练过程中实际处于何种状态,学习率都按预设轨迹变化。该框架的推导建立在随机梯度下降(SGD)的连续时间动力学之上,因此其最优性结论对 SGD 成立,却难以直接迁移到 Adam 等具有自适应二阶矩估计的优化器。此外,UBA 引入了一个“优化难度参数”来刻画损失曲面的性质,但该参数缺乏直观的物理含义,也难以从训练数据中直接估计,这限制了它的实际可用性。
闭环控制与学习率的形状—尺度分解:闭环控制是控制论中的概念,指系统根据被控对象的实时输出反馈来调整控制量,而非仅按预设程序执行。将学习率调度视为闭环问题,意味着学习率不再只由当前迭代步数决定,而是同时依赖训练过程中的内部状态(如梯度统计量、损失变化等)。UTA 进一步把学习率曲线分解为“形状”与“尺度”两个维度:形状描述学习率随训练进展的相对变化模式(如先升后降的整体轮廓),尺度描述整体幅值水平。通过在连续时间框架下对每一段分别求解最优形状,并按当前状态校准尺度,UTA 能够在不同训练阶段逼近理论最优路径。连续时间建模的好处是把离散的迭代更新近似为微分方程,从而可利用变分或最优控制方法解析地刻画最优学习率,而不必依赖特定离散优化器的更新规则。
实验验证:跨模型的一致提升
在语言模型方面,UTA在LLaMA架构(从60M到1B参数)上均取得一致改进;在视觉任务上,ResNet50和ViT-B在ImageNet上的表现也有提升。这些结果覆盖了不同规模与模态,表明UTA的增益并非偶然。
有意思的是,UTA的即插即用特性使其易于在实际训练流程中部署,而几乎不增加计算负担。消融研究进一步确认,UTA对关键超参数不敏感,这降低了调参成本,提升了实用价值。
Adam 类优化器与 LLaMA 架构:Adam 及其变体(如 AdamW)是目前训练大模型的主流优化器,它通过维护梯度的一阶矩和二阶矩估计,为每个参数自适应地缩放更新步长。这种逐参数的自适应性与 SGD 的全局统一学习率有本质区别,也是 UBA 等基于 SGD 动力学的调度方法难以直接套用的原因。UTA 不依赖具体优化器的更新形式,因此可与 Adam 类优化器配合使用。LLaMA 是 Meta 发布的开源大语言模型系列,采用 Transformer 解码器架构,包含旋转位置编码、SwiGLU 激活和 RMSNorm 等组件。论文在 60M 到 1B 参数的 LLaMA 规模模型上验证 UTA,覆盖了从较小规模到中等规模的预训练场景,这一参数跨度有助于判断方法增益是否随模型规模稳定存在。
行业启示:学习率调度进入自适应时代
UTA的提出标志着学习率调度从经验规则向自适应控制的转变。传统方法如余弦退火、阶梯衰减等虽广泛应用,但往往需要针对任务手动调参。UTA通过闭环反馈机制,让学习率曲线随训练状态动态调整,有望减少人工干预,提升训练效率。
对于从业者而言,UTA的即插即用特性意味着可以低成本地尝试并可能获得性能提升。尤其是在大规模预训练和微调场景中,学习率调度的微小改进可能带来显著的最终效果差异。UTA的通用性也使其适用于多种优化器和模型架构,具备较强的泛化潜力。
尽管UTA仍需选择参数φ₀,但实验显示其鲁棒性较好,这减轻了实际部署的负担。未来,随着自适应学习率方法的成熟,我们或可看到更多理论驱动且易于落地的训练策略。
余弦退火与阶梯衰减:余弦退火是一种广泛使用的学习率调度策略,学习率从峰值按余弦函数平滑下降到接近零,其优点是曲线连续、后期衰减平缓,有利于模型收敛到较平坦的极小值。阶梯衰减则是在预设的迭代节点上将学习率按固定比例(如乘以 0.1)下调,实现简单、行为可预测,常见于早期卷积网络训练。这两类方法都属于开环、经验驱动的调度:曲线形状和衰减时点需要人工设定,且一旦确定便不随训练状态改变。它们的性能对峰值学习率、衰减节点等超参数较为敏感,往往需要针对不同任务和模型规模反复调参。UTA 所代表的闭环自适应思路,正是试图用训练状态反馈替代这类手工规则,从而降低对经验调参的依赖。
相关推荐
MCP图解:AI Agent如何连接你的应用
MCP图解:AI Agent如何连接你的应用
从电商客服机器人场景出发,图解MCP(Model Context Protocol)如何解决AI应用与外部工具的M×N集成困境,对比REST API直连的缺陷,解析Tools/Resources/Prompts三大原语、Host-Client-Server三层架构、stdio与streamable HTTP传输,以及认证授权、凭证管理与prompt injection防护要点。
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。
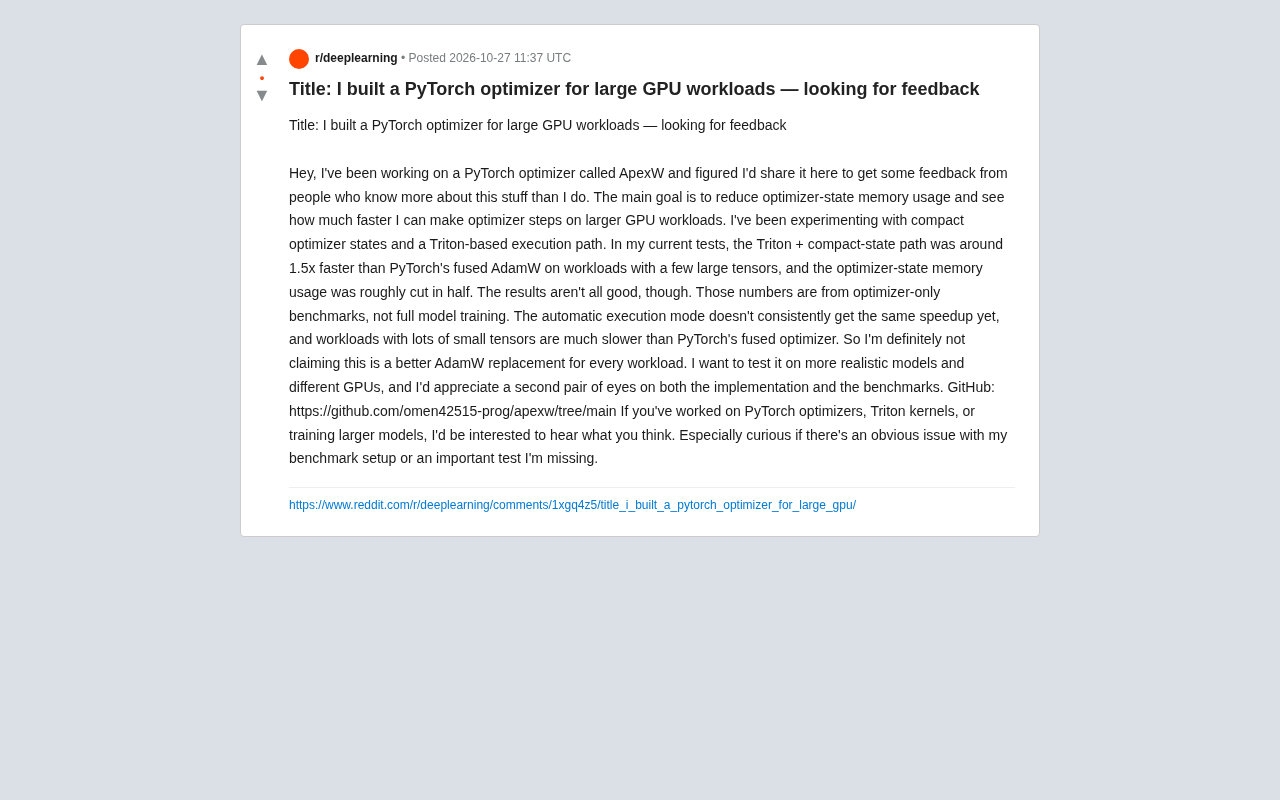
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。