v0.40.12预发布:MLX推理提速与Gemma视觉细节优化
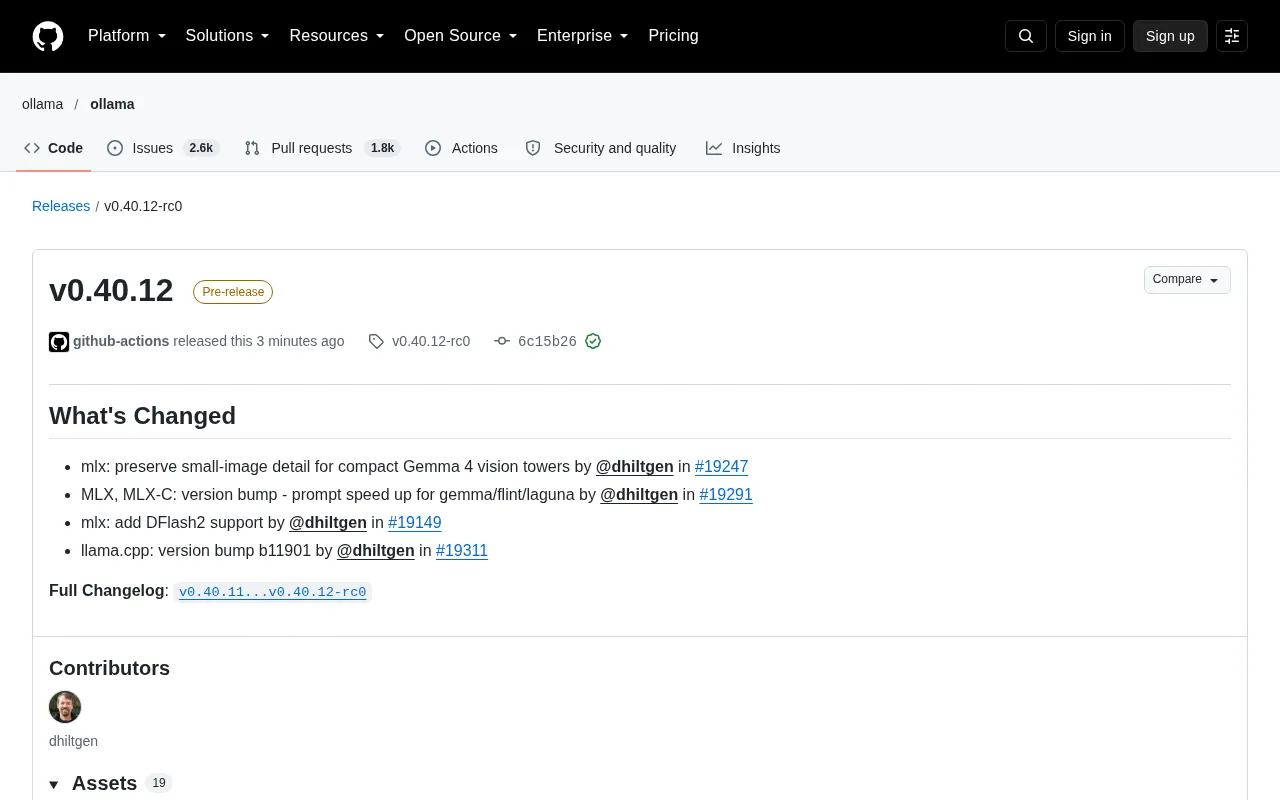
v0.40.12 预发布版聚焦 MLX 与 llama.cpp 后端的提示速度、小图保真与模型支持面修补。
v0.40.12 以预发布标签发布,四条变更全部由单一贡献者提交,改动集中在 MLX 与 llama.cpp 两条推理后端线上,属于典型的“小而密”迭代。MLX 侧有三处改动:一是为 Gemma 4 紧凑视觉塔优化小尺寸图像的细节保留;二是同步升级 MLX 与 MLX-C,为 gemma、flint、laguna 三个模型系列带来提示词处理速度提升,收益覆盖从 Python 绑定到底层 C 接口的完整链路;三是新增 DFlash2 支持,扩展可运行的模型范围。llama.cpp 侧则例行推进至 b11901,同步上游修复与算子改进。由于是 rc 版本且改动集中在推理后端,作者建议升级前在独立环境实测目标模型,尤其是视觉任务的小图表现,确认性能与精度的取舍符合预期。
v0.40.12 以预发布标签(Pre-release)出现在版本列表中,提交记录集中在 MLX 与 llama.cpp 两条推理后端线上。从更新条目看,这是一次典型的"小而密"迭代:没有新增大功能,而是围绕提示词速度、视觉细节保留和模型支持面做定向修补。
版本概况与发布节奏
该版本由 GitHub Actions 自动构建,发布者在提交哈希 6c15b26 上打上 v0.40.12-rc0 标签,提交经过 GitHub 验证签名(GPG key ID: B5690EEEBB952194)。
贡献者名单中只有 @dhiltgen 一人,四条变更全部由其提交,这暗示改动主题高度集中——基本可以视为一次针对 Apple Silicon / MLX 路线的专项性能补丁集。预发布形态也说明它尚未进入稳定通道,更适合愿意尝鲜并反馈问题的用户先行验证。
预发布版本(Pre-release / rc 标签) 是语义化版本流程中的一个阶段性标记:-rc0 表示 release candidate 的第 0 次迭代,功能已冻结、等待验证,但尚未承诺 API 与行为稳定。GitHub 上预发布版本不会被标记为 Latest,通常也不会出现在 releases/latest 的自动跳转中,包管理器的稳定通道默认不会解析到它,用户需要显式指定版本号才能拉取。与之相对,稳定版通过移除 rc 后缀并重新打 tag 产生。预发布阶段的核心作用是收集真实环境下的回归反馈:一旦发现问题,可以在不影响稳定用户的前提下继续发布 rc1、rc2。因此看到 rc 标签时,合理的预期是“可尝鲜、可反馈,但不建议作为生产默认版本”。
GitHub 验证签名 指提交或标签由 GPG 密钥签名,GitHub 用登记的公钥校验后显示 Verified 徽章。它能证明该对象确实由持有对应私钥的人或自动化系统创建,且在传输过程中未被篡改。文中的 GPG key ID 是公钥指纹的末 16 位,可用于追溯签名主体——这里指向 GitHub Actions 的自动构建身份,说明该 tag 由 CI 流水线而非人工本地推送生成,构建过程具备可复现性与可审计性。
MLX 后端的三处改动
小图细节与紧凑视觉塔
第一条变更标题为"preserve small-image detail for compact Gemma 4 vision towers"(#19247)。其含义是:在 Gemma 4 的紧凑型视觉编码器(vision tower)处理图像时,保留小尺寸图像的细节信息。
紧凑视觉塔通常通过降低输入分辨率或减少 token 数量来压缩计算量,代价是小图或被缩放后的图像容易丢失纹理与边缘信息。这条补丁针对的正是这一取舍点,方向上是在不显著增加开销的前提下改善小图输入的保真度。对需要处理缩略图、图表截图或小尺寸 UI 截图的场景,这类改动的影响会比参数堆叠更直接。
视觉塔(vision tower) 是多模态模型中负责把图像编码成视觉 token 的子网络,通常由 ViT 类结构堆叠而成,输出经投影层对齐到语言模型的嵌入空间。所谓“紧凑型”视觉塔,一般通过降低 patch 分辨率、减少层数或对视觉 token 做池化压缩来削减计算量与显存占用,让视觉编码的开销不至于压过语言主干。代价在于信息瓶颈:图像被切成更粗的 patch 后,细粒度纹理与边缘最先损失,小尺寸输入尤其明显——原图本身像素有限,再经缩放与粗粒度切分,可用的视觉 token 数量迅速逼近下限。
版本升级带来提示速度提升
第二条变更(#19291)同时涉及 MLX 与 MLX-C 的版本号提升,官方描述为"prompt speed up for gemma/flint/laguna"——即对 gemma、flint、laguna 三个模型系列提升提示词处理速度。
提示词处理(prompt processing)是首 token 延迟的主要构成部分,长上下文场景下尤其明显。这次提速通过底层库升级实现,而非应用层调度优化,意味着收益会随着这三个模型系列的使用自动生效,用户侧无需改配置。说个细节,变更同时升级了 MLX 与 MLX-C,说明改进覆盖了从 Python 绑定到底层 C 接口的完整链路。
MLX 是 Apple 为 Apple Silicon 设计的数组计算框架,采用统一内存架构,CPU 与 GPU 共享同一块物理内存,因而省去了独立显存之间的数据拷贝。MLX-C 则是其 C API 层,供非 Python 语言或需要更细粒度控制的调用方使用。Llama.cpp 一类的推理栈往往通过 C 接口对接 MLX,因此一次“MLX + MLX-C 同步升级”意味着算子实现、内存管理与绑定层同时更新,从 Python 绑定到底层 C 接口的调用链都能吃到改进。
提示词处理速度(prompt processing / prefill) 指模型对输入上下文做前向计算、填充 KV Cache 的阶段,其结果直接决定首 token 延迟(TTFT)。该阶段可以并行处理整段输入,属于计算密集型;随后的解码阶段则是逐 token 串行生成,属于访存密集型。长上下文场景中,prefill 往往占据端到端时延的大头,因此底层算子与 kernel 的优化在长提示词下收益最为显著。
新增 DFlash2 支持
第三条(#19149)是一条明确的能力扩展:为 MLX 增加 DFlash2 支持。相比前两条的性能与质量微调,这条属于支持矩阵的扩张,让该后端能够加载此前无法运行的模型格式或架构。具体支持范围需要结合仓库文档确认,但从提交标题看,它独立于 Gemma 与 llama.cpp 的改动线。
llama.cpp 的例行跟进
最后一条(#19311)将 llama.cpp 版本推进到 b11901。这类版本 bump 在混合后端项目中很常见,作用是同步上游修复与算子改进,避免本地分支与上游偏离过远。
虽然条目本身信息量有限,但它说明该项目同时维护 MLX 与 llama.cpp 两条推理路径,前者面向苹果生态的 GPU 加速,后者覆盖更广的硬件与量化格式。两条线并行更新,用户在不同平台上的体验差异会被持续压缩。
llama.cpp 是 ggml 生态下的 C/C++ 推理引擎,以对 CPU、Metal、CUDA、Vulkan 等多后端的广泛覆盖和丰富的量化格式(GGUF 体系下的 Q4_K_M、Q8_0 等)著称。它的版本号采用 b 加构建序号的滚动形式(如 b11901),不遵循语义化版本,每个构建号对应上游主干的一次快照。这种滚动发布意味着版本 bump 往往横跨大量上游提交,包含算子实现、量化 kernel 与后端适配的持续修补。对下游项目而言,定期跟进可以避免本地分支与上游长期分叉后产生难以合并的冲突,但同时也需关注上游行为变化可能带来的输出差异。
谁适合升级
从变更构成判断,这次预发布的价值集中在三类用户身上:在 Apple Silicon 上运行 Gemma 系列并受首 token 延迟困扰的用户、需要处理小尺寸图像输入的视觉任务用户,以及关注 DFlash2 新模型接入的用户。
由于是 rc 版本且改动全部集中在推理后端,升级前建议在独立环境验证目标模型的输出质量,尤其是视觉任务的小图表现——性能提升与精度变化往往同时出现,需要实测确认取舍是否符合预期。完整变更可参考 v0.40.11...v0.40.12-rc0 的对比记录。
相关推荐
微软工程师拆解Agentic AI训练:数据与评分器才是胜负手
微软工程师在UC Berkeley课程中详解Agentic AI模型训练实战:可验证与不可验证数据的处理、rubrics评分器设计、奖励黑客防范、异步强化学习效率优化,以及测试时与训练时扩展的未来方向。
SEC文件揭秘:8VC、Benchmark等风投巨头的新一轮募资动向
通过十月SEC文件,发现8VC、Benchmark等风投机构正在募集新基金。本文分析募资潮背后的市场信号与趋势,探讨资本供给和早期投资竞争。
WebMCP工具怎么测?用Evals评估非确定性AI行为
WebMCP 工具由非确定性的 AI Agent 调用,传统单元测试无法验证 Agent 是否选对工具、传对参数。本文介绍 Evals 评估方法:用 JSON 定义期望工具调用,通过 local 与 browser 两种模式运行,并借助 WebMCP eval-cli 多轮运行获得通过率与 Agent 轨迹报告。