VaultLedger:基于 Ollama 的离线发票对账工具

VaultLedger 用 Ollama 本地模型在断网下对账发票与银行流水,隐私优先但仍是原型。
VaultLedger 是开发者 akshat-bit420 用一周时间做出的离线发票对账原型:发票 PDF 经 PyMuPDF 抽取文本,交给 Ollama 本地运行的 qwen2.5:7b,借助 Pydantic schema 约束的结构化输出提取供应商、发票号、金额等字段,再由 pandas 与银行流水 CSV 比对,输出重复发票、未付款发票、无发票扣款三类标记并导出 Excel。作者记录了分类字段因 schema 过松而失效、Streamlit 重跑导致结果丢失、Ollama 服务未启动三个踩坑及修复。核心卖点是数据不出本机与零单文档成本,代价是需本地运行服务、仅按金额匹配、数字未校验、不支持扫描件,且只在一个模型的合成数据上测试过。
VaultLedger:基于 Ollama 的离线发票对账工具
小店铺和代账会计每天要面对成堆的发票 PDF 和银行流水 CSV,人工逐条勾对费时费力,而把财务数据上传到云端又让人不安。开发者 akshat-bit420 用 Ollama 驱动的本地模型做了一个原型 VaultLedger,在完全断网的环境下完成发票与银行流水的自动核对,并输出 Excel 审计报告。
它解决什么问题
很多本地小店的审计工作已经在电脑上完成,但完全没有自动化——有人坐在电脑前,一张发票对应一条银行流水地手动匹配。根据作者在多个本地商店的观察,网络连接并不是可以依赖的条件,云端工具在这类场景下直接不可用。
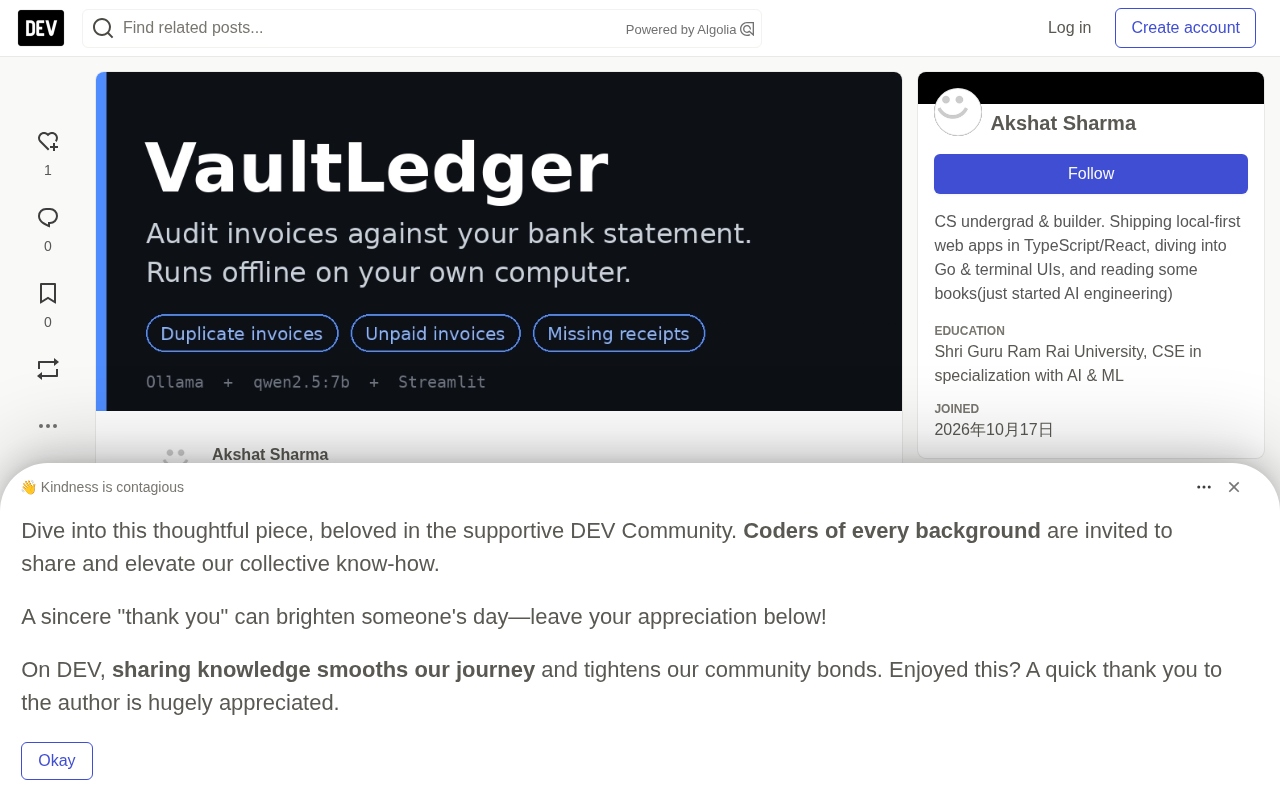
VaultLedger 的输入很直接:上传发票 PDF 和银行流水 CSV,本地开源模型逐张读取发票,输出三类标记:
- 重复发票:避免同一张账单被支付两次
- 无对应银行扣款的发票:清楚看到哪些还没付款
- 无发票的银行扣款:税务季常见的缺失凭证
在作者的示例文件上,整个审计在笔记本电脑上耗时约一分半到两分钟,结果以 Excel 报告形式下载,可以直接交给店主或客户。
技术实现:结构化输出是关键
整条流水线刻意保持简单:PDF 文本抽取、本地模型解析、结构化 JSON、pandas 比对。具体组件如下:
- 模型:
qwen2.5:7b,通过 Ollama 本地运行的开源权重模型 - PDF 读取:PyMuPDF 从每张发票中提取文本
- 结构化输出:Pydantic schema 传给 Ollama 的
format选项,模型必须返回字段精确匹配的合法 JSON,而不是需要二次解析的自由文本 - 对账:pandas 将抽取出的发票与银行 CSV 进行比较
- 界面:Streamlit,并支持审计结果的 Excel 导出
作者把温度设为 0.0,并配合 Ollama 原生的结构化输出 API,从发票中提取 vendor_name、invoice_number、invoice_date、subtotal、tax_amount、total_amount、currency 和费用 category 等字段。这种「schema 约束模型输出」的做法,是本地小模型能够稳定用于财务字段抽取的前提。
Ollama 的 format 选项与原生结构化输出
Ollama 从 0.1.30 版本前后开始支持让模型输出严格遵循 JSON Schema 的能力,调用时在请求里传入 format 字段。底层实现通常依赖 llama.cpp 的语法约束解码(grammar-constrained decoding):在生成每个 token 时,只允许那些能继续满足当前 JSON 语法和 schema 约束的候选词进入采样。这意味着模型不是「被要求」输出 JSON,而是在解码层面「不可能」输出违反 schema 的字符,因此不需要事后用正则或二次调用来修复格式。对财务字段抽取这类需要百分百可解析的场景,这比只靠提示词要求「请返回 JSON」可靠得多。
Pydantic 的 Literal 如何约束模型
Pydantic 是 Python 的数据校验库,用类型注解声明数据结构。当字段声明为 str 时,schema 里只是 {"type": "string"},模型可以填任意字符串;而声明为 Literal["Software", "Travel", ...] 时,生成的 JSON Schema 会带上 enum 列表,语法约束解码便会把输出限制在这些取值之内。这正是文中「分类字段一开始形同虚设」问题的根因:schema 的约束力等于它在解码器层面表达的严格程度,宽松的类型注解等于没有约束。
三个踩坑与修复
作者在开发过程中记录了三个具体问题,对想复刻本方案的人有参考价值:
分类字段一开始形同虚设。 schema 里要求填写 Software、Travel 之类的分类,但字段被定义成普通字符串,模型对每张发票都回答「Invoice」。Ollama 只强制 schema 里写明的东西,把字段改成带允许值的 Literal 之后问题消失。这说明结构化输出的约束力完全取决于 schema 写得有多严格。
点击下载后结果消失。 Streamlit 在每次点击时都会重跑整个脚本,下载 Excel 的瞬间表格就没了。把结果存入 st.session_state 解决了问题——作者是在录制自己的演示视频时发现这个 bug 的,修复后重新录了一遍。
「Failed to connect to Ollama」。 第一次点审计按钮时所有发票都失败,模型已经下载好,但 Ollama 服务没有启动。修复方式是先启动 Ollama(安装后会在后台运行)。应用会清晰显示这个错误,README 也提示用户在启动前确认 Ollama 正在运行。本地跑 AI,意味着你也得负责运行服务它的进程——这是为了隐私和零单文档成本所接受的权衡。
为什么本地优先对这类场景重要
作者把隐私直接当作产品卖点。店主和代账会计保管着他人托付的银行流水与发票,开源权重模型跑在同一台机器上,文档永远不会去到用户无法控制的服务器,作者用断网录制演示视频来证明这一点。
成本结构同样关键。模型一次性下载之后没有 API 账单,而云端 API 按文档计费,随着处理量增长会侵蚀小企业的利润空间。模型在应用里是一个设置项,任何 Ollama 能跑起来的模型都可以替换——不过作者只测试了 qwen2.5:7b,明确表示无法对其他模型的表现下结论。
作者也坦率指出了闭源模型仍然占优的地方:扫描件和手写发票。当前版本只读取带文本层的 PDF,闭源视觉模型在今天处理扫描件会更好。
开源权重模型与数据不出机器
「开源权重」指模型参数可以下载到本地运行,推理过程不依赖厂商服务器。与之相对,云端 API 每次调用都要把输入(这里是发票全文和金额)发送到第三方。对代账会计而言,这涉及受托数据的合规义务,很多地区的职业规范要求对客户财务信息保持控制权。本地推理让数据在物理上不出本机,断网即可验证这一点,这是云端方案无法提供的可审计性。
7B 模型的运行门槛
7B 指约 70 亿参数。以 4-bit 量化后,qwen2.5:7b 的显存或内存占用大致在 5GB 上下,普通带独显的笔记本或 16GB 内存的机器可以运行,但速度取决于硬件。这也解释了文中「需要一台能舒适运行 7B 模型的电脑」这一局限:模型规模直接决定了部署门槛与单文档处理时间(示例中约一到两分钟)。
明确的局限与下一步
这个一周做出的原型,作者列出了相当诚实的局限清单:
- 匹配只按金额:两个不同供应商收取相同金额可能被误匹配。下一步是金额加日期窗口,再加供应商名称模糊匹配。
- 重复检测依据供应商、总额和日期:真实重复往往体现为相同发票号,作者计划补上这一维度。
- 模型给出的数字未经验证:7B 模型可能算错,作者打算增加「小计加税额等于总额」的校验,不通过的行标记为待复核。
- 尚不支持扫描版 PDF
- 只在干净、合成的发票上测试过一个模型,无法声称在杂乱的真实发票上的准确率
- 印度发票的 GST 支持是下一个计划中的功能
- 需要一台能舒适运行 7B 模型的电脑
作者自己的判断是:这是个一周原型,他真正有信心的是那个想法本身——文档留在本机,断网也能完成审计。对于处理敏感财务数据的小型业务来说,「数据不出机器」这一点本身,就足以让本地开源模型成为值得认真考虑的方案。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。