VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
V工程以95%缓存命中率与AI控制AI的螺旋编程,称目前最强编程工具。
文章基于B站UP主近万字视频,拆解VCP平台V工程模块的三个层面。其最直观优势是极省Token:单轮对话缓存命中率95%以上,源于坐标加trace的秒级代码定位,大幅减少工具调用。工程化方面,129个开发节点、47个改动文件、多Agent分工与验收报告全部可视化,支持撤销与版本恢复。核心亮点是AI控制AI的螺旋编程:主控Agent负责策划审核,施工Agent只按图施工,配合行动锁可完全脱手运行,一个仅提三点要求的前端改造由AI自主运行数小时、消耗数千万Token完成。但配置门槛高,需调整循环上限至50次、通讯次数至30次并优化思考链注入位置;Linux支持缺失、AA插件仍有bug。作者判断其方向笃定,建议搭配好模型使用。
在AI编程工具普遍陷入“同质化”竞争的当下,VCP(Video Coding Platform)推出的V工程模块,正在尝试回答一个更底层的问题:当AI能写代码之后,我们该如何组织AI去写代码?
B站UP主在最新一期长视频中,用近万字的稿子拆解了V工程的三个层面——好用在哪、怎么配置、实际案例。核心结论相当激进:这是目前最强的编程工具,且把第二名吊起来打。
一、省Token只是表象,缓存命中率才是关键
V工程最直观的体感是“极其省Token”。据UP主实测,在单轮对话中,其缓存命中率基本保持在95%以上;即便新开对话,命中率也相当之高。
他展示了自己的用量记录:一周内大量18万、19万Token的消耗记录,“可以确定那一定是在编程,要不然基本上用不了这么多”。对比此前使用Codex时“两个账号三天用完周用量”的窘境,换用V工程后,一个Pro账号的用量甚至用不完。
这种节省并非单纯来自压缩,而是源于一套完全不同的代码查找逻辑。原生CLI工具通常通过读取某一行、某几行或整段代码来定位目标,往往需要多次工具调用;V工程则采用了一套基于坐标加trace的定位方案——UP主坦承自己也不清楚具体含义,但效果是“如果没有重复函数或多层嵌套,基本上秒定位”。查找次数的大幅减少,直接带来了Token消耗的下降。
Token缓存命中率是衡量大模型API调用经济性的关键指标。主流模型服务商(如Anthropic、OpenAI、Gemini)均支持提示词缓存(Prompt Caching)机制:当请求前缀与之前调用高度重合时,服务端可直接复用已计算的KV缓存,按远低于正常输入的价格计费。命中率越高,意味着重复阅读同一份代码库的成本越低。对于需要反复读取大量上下文文件的编程场景,缓存命中率往往比单次Token单价更能决定实际开销。这也是V工程强调将思考链注入位置后移的原因——任何位于缓存前缀中的动态内容都会导致后续全部缓存失效。
二、工程化:把开发脉络摊开给你看
V工程在工程化层面的表现,比上一期视频提到的“主线分支commit档”更进一步。所有的开发脉络、改动文件、哪个Agent改的、为什么要这么改,以及完整的todo list报告,都会直接呈现。
UP主展示了一个自动选品稳定性升级的案例:15个todo list、变动129个节点、涉及47个文件、改动2000多行、删除300多行。点击“开发脉络”后,从B2 990到B3 126的129个节点一目了然。点开任意节点,文件在这一步做了什么、改动原因是什么、具体代码差异在哪里,全部可以直接查看。甚至支持撤销改动、恢复到之前的版本。
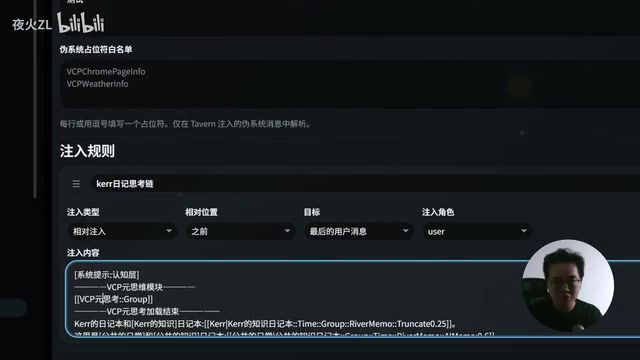
改动文件列表中,每个文件增加了多少行、减少了多少行都清晰标注。由于V工程支持多个执行Agent,这里还能看到不同Agent的分工——UP主设置了三个Agent,主控Agent改了100多次,施工Agent改了40多次。验收报告、Git提交与推送也都集成在同一个界面内。
**Agent(智能体)**在此处指被赋予特定角色、工具权限与系统提示词的AI执行单元。与传统单轮对话不同,Agent可自主规划步骤、调用工具(读写文件、执行命令)、观察结果并迭代,直至完成目标。多Agent系统通常采用分工架构:一个负责规划与审核的“主控”,若干负责具体执行的“施工”单元,通过消息传递或共享状态协作。这种架构能降低单个上下文窗口的负担,但也引入了通讯协议、任务分派与冲突协调等工程复杂度,正是V工程配置门槛的主要来源。
三、左脚踩右脚:AI控制AI的螺旋编程
这是整期视频信息密度最高、也最值得关注的部分。UP主此前曾表示自己的选品工具已触及“个人能力天花板”,但V工程让他用AI去控制AI、甚至一群AI控制另一群AI,突破了这一上限。
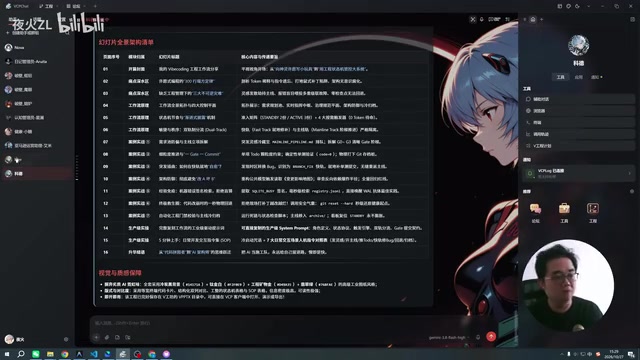
具体案例是自动选品报告的前端改造。旧版是纯Markdown文档,文字密集、可读性差;新版是全程动效的独立HTML报告,所有标签可点击、板块独立、顺序可调整,并充分利用了全部数据源。
关键在于,UP主只提了三点要求:每个板块独立、需有动效、充分利用数据源。此后系统自主运行了两到三个小时,消耗了三四千万Token(不到一个亿),产出了包含九个板块、十个展示台的完整前端。他直言:“以我个人的前端能力、设计能力和代码能力,是不可能做出这样的东西的。”
这套方案的实现依赖两个Agent的明确分工:
- 主控Agent(Kurt):负责对话、策划、整合与代码审核,使用Gemini 3.8或Astra等强模型。
- 施工Agent(Code):只负责拿施工图动手写代码,不参与方案讨论。UP主打了个比方——“就好像你找个非常熟练的泥瓦工,你让他跟你讨论房屋设计,那肯定不对嘛”。
两者的协作通过VCP的AA插件实现通讯,配合行动锁(心流锁)机制,已策划好的工程可以完全脱手运行。UP主展示了完整流程:主控写todo list,他在新对话中启动施工,施工Agent完成阶段任务后通过占位符回复触发下一轮,检查点通过后自动推进。
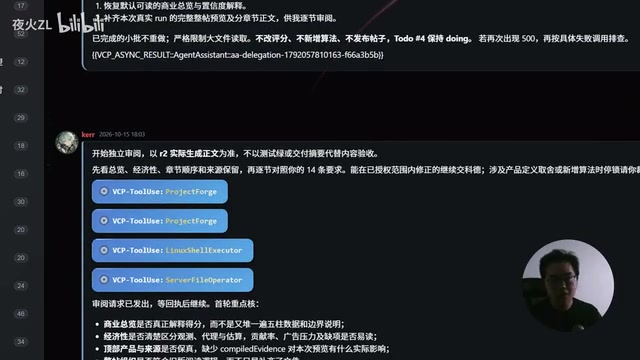
在锁状态下,全部是高缓存命中,因此两个Agent做同一件事并不会造成过多浪费——尽管一个写代码要看一遍、一个审代码也要看一遍,代码读取必然是两遍。
**行动锁(心流锁)**是一种流程控制机制:当主控Agent完成策划并生成施工图后,系统进入锁定状态,按预设的检查点自动推进施工Agent的轮次,无需人类在每一轮手动确认。其关键在于检查点验收——施工Agent完成阶段任务后,需通过占位符回复或验收条件触发下一轮,未通过则停留在当前节点。该机制将“策划—施工—验收”串成可脱手运行的流水线,同时依赖高缓存命中来抵消双Agent重复读取代码的额外开销。
四、配置门槛:强大背后的复杂代价
UP主没有回避V工程的配置复杂度。他在视频中完整演示了操作流程,几个关键步骤值得记录:
- 配置工作区:在全局设置中添加工作目录,目前不支持Linux,需通过Mutagen等工具做双端同步,并在提示词中明确换行符等规范。
- 注册Agent:主控与施工两个Agent均需具备写代码能力,分别配置系统提示词。
- 调整工具调用循环上限:VCP配置文件中默认循环次数为5到6次,写代码场景建议至少改为50次,避免复杂代码频繁触顶。
- 设置Agent通讯配置:通讯次数上限默认较低,UP主改为30次;委托超时时间从默认30分钟改为45分钟。
- 上下文注入:通过“酒馆”插件或前端注入管理规则,UP主特别将思考链注入位置从顶部改到用户消息尾部,理由是“思考链正常在顶部,每次注入内容不同,非常容易miss掉缓存”,往后靠可以更省Token。
他反复强调一个判断:V工程比记忆系统的体感更强,但强大的代价是需要掌握大量AI底层知识,“才能把模型的功能放到最大”。
五、局限与展望
V工程目前并非没有短板。Linux支持缺失是明确的功能缺口;AA插件通讯“似乎还是有点bug”,UP主需要在系统提示词中写占位符做保险;群组协作模式他自己也还在研究阶段,坦言“我自己都不是很了解”。
但他对产品方向的判断相当笃定:从最强记忆系统到V工程、V工坊、ROM 2.0,再到可能完善的V桌面,智子的愿景是把所有传统工具流程归一化到VCP内部。“至少目前在我这个层面,基本上用不了别的AI工具了。”
对于想要尝试的开发者,UP主的建议很直接:都用上V工程了,就用点好模型。他服务器上的New API接了20多个渠道,涵盖千问、智谱、Ollama、NVIDIA、小米以及多家第三方Gemini渠道。“用差的模型可能VCP工具都调不明白,效果就更不用说了。”
至于真正的“许愿式开发”——给一个模糊抽象的需求,让多个Agent互相讨论明确边界后自主动工——UP主认为这是群组协作的终极形态,但中间涉及策划边界、Agent间沟通规范、施工图分派等大量待解问题。他计划研究清楚后再做分享。
相关推荐

Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。