VCR-Bench:填补视频分类鲁棒性评测空白的开源框架

VCR-Bench 是首个系统化、可复现的视频分类对抗鲁棒性开源评测框架。
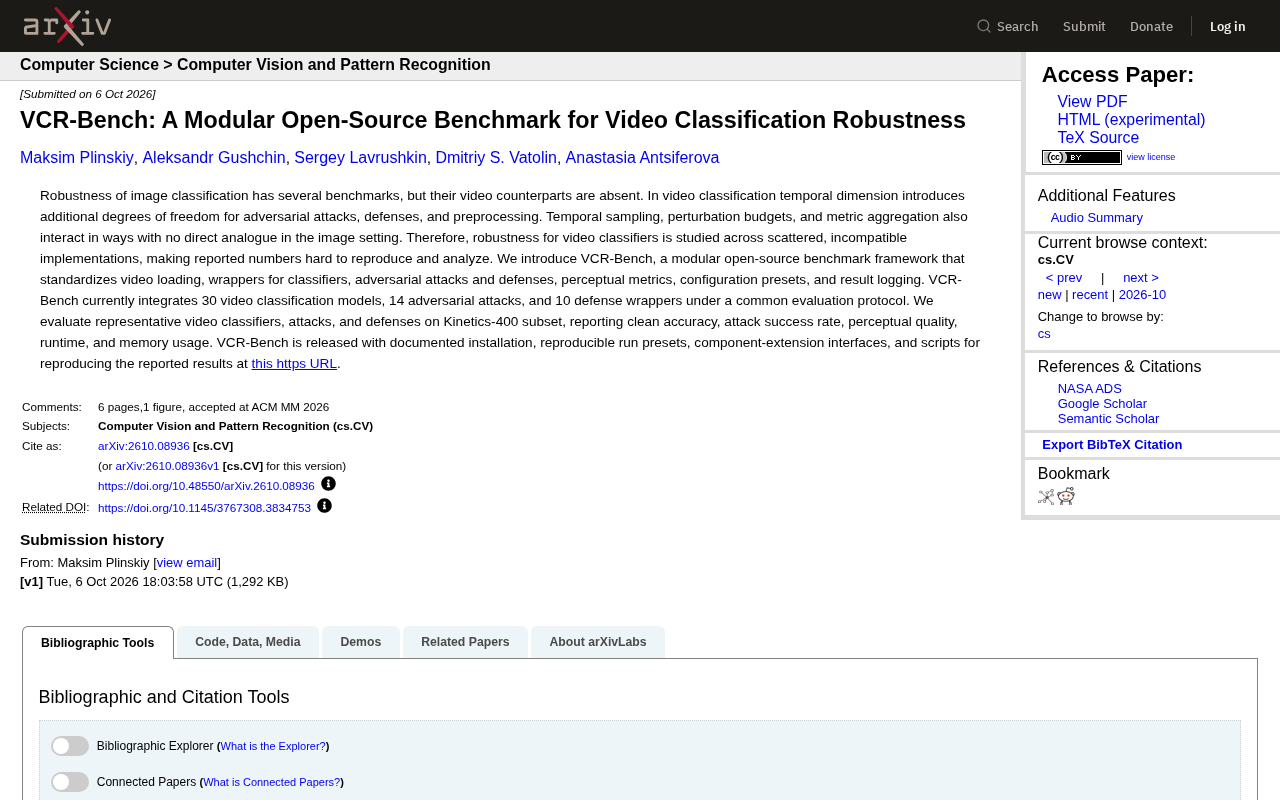
视频分类鲁棒性研究长期因缺乏统一标准而陷入各自为战的困境——不同论文采用不同协议,结果既难复现也无法横向比较。VCR-Bench 以模块化开源框架的形式填补这一空白,整合了30个视频分类模型、14种对抗攻击方法和10个防御封装器,在统一协议下从干净准确率、攻击成功率、感知质量、运行时间和内存占用五个维度进行综合评测。框架的核心价值不仅在于组件规模,更在于对可复现性的系统保障:详细文档、固定配置预设、扩展接口和复现脚本共同确保「报告的数字可以被别人跑出来」。项目已在 GitHub 开源,有望推动视频鲁棒性研究走向标准化与可积累。
视频分类鲁棒性为何长期缺乏统一标准
图像分类领域早已拥有成熟的鲁棒性评测基准,研究者可以在统一协议下对比不同模型抵抗对抗攻击的能力。但视频分类领域却长期处于「各自为战」的状态——没有一个被广泛接受的标准化基准。
问题的根源在于视频数据多出的时间维度。相比静态图像,视频在时间轴上引入了额外的自由度,这直接影响到对抗攻击、防御手段以及预处理流程的设计。时间采样策略、扰动预算的分配、以及评测指标如何在帧与帧之间聚合,这些因素相互交织,在图像场景中几乎找不到直接对应的处理方式。
结果就是,视频分类器的鲁棒性研究散落在各种互不兼容的实现里。不同论文报告的数字难以复现,更难以横向比较,整个领域缺乏可靠的参照系。
**对抗攻击(Adversarial Attack)**是指通过对输入数据施加人眼难以察觉的微小扰动,使机器学习模型产生错误预测的技术。在图像领域,这类扰动通常以像素级噪声的形式呈现,受限于 L∞ 或 L2 范数约束(即扰动幅度上限)。视频场景下,攻击者不仅需要决定每一帧施加多大的扰动,还要考虑扰动在时间轴上如何分配——是均匀施加到所有帧、集中攻击关键帧,还是利用帧间相关性构造时序一致的扰动。防御手段则涵盖对抗训练(在训练时引入对抗样本提升模型免疫力)、输入预处理(如去噪、随机化)等策略。这些攻防机制在图像领域已有大量标准化实现,但其在视频上的移植方式至今众说纷纭,缺乏共识,这正是视频鲁棒性评测难以横向对比的根本技术原因。
VCR-Bench 做了什么
VCR-Bench 的定位是一个模块化的开源基准框架,目标是把视频分类鲁棒性评测的各个环节标准化。它涵盖了从数据到结果的完整链路:
- 视频加载:统一的数据读取方式,避免因加载差异导致的结果偏差
- 分类器封装:为不同模型提供统一的调用接口
- 对抗攻击与防御:内置多种攻击和防御模块
- 感知质量指标:衡量扰动对视频视觉质量的影响
- 配置预设与结果日志:保证实验可复现
这种模块化设计意味着研究者不必再从零搭建评测管线,而是可以在同一套协议下插拔不同组件进行公平对比。
集成规模
目前 VCR-Bench 已经整合了相当可观的组件库:
- 30 个视频分类模型
- 14 种对抗攻击方法
- 10 个防御封装器
所有这些都运行在一套共同的评测协议之下,这正是过去该领域所缺失的关键基础设施。
评测维度与实验设置
研究团队在 Kinetics-400 数据集的子集上,对代表性的视频分类器、攻击方法和防御手段进行了评测。值得关注的是,VCR-Bench 并不只报告单一的准确率指标,而是从多个维度综合衡量:
- 干净准确率(clean accuracy):模型在无攻击情况下的基础表现
- 攻击成功率(attack success rate):衡量攻击的有效性
- 感知质量(perceptual quality):对抗扰动是否足够隐蔽
- 运行时间(runtime):评估方法的计算开销
- 内存占用(memory usage):资源消耗情况
这种多维度评测的意义在于,鲁棒性从来不是孤立的数字。一个攻击方法可能成功率很高,但如果它引入的扰动肉眼可辨、或者需要庞大的计算资源,那么它在实际威胁模型中的价值就要打折扣。把准确率、感知质量和资源开销放在一起看,才能更真实地反映攻防双方的权衡。
Kinetics-400 是由 DeepMind 发布的大规模视频动作识别数据集,包含约 30 万个来自 YouTube 的视频片段,涵盖 400 个人类动作类别(如运动、烹饪、乐器演奏等),每段视频约 10 秒。它是视频理解领域最主流的预训练与评测基准之一,众多主流视频分类模型(如 TSN、SlowFast、VideoSwin 等)均以其作为标准评测集。选用该数据集的子集进行鲁棒性评测,一方面保证了与已有文献的可比性,另一方面也降低了大规模攻击实验的计算成本。不过,Kinetics-400 主要聚焦于动作识别场景,对于监控、医疗、自动驾驶等垂直领域的泛化性仍有待验证,这也是文末提及「覆盖场景仍有限」的背景所在。
可复现性是核心价值
VCR-Bench 最值得强调的贡献,或许并不在于它集成了多少模型或攻击,而在于它对可复现性的系统性保障。该框架随附了详细的安装文档、可复现的运行预设、组件扩展接口,以及用于重现论文结果的脚本,项目已开源在 GitHub。
在当前 AI 研究中,复现难是一个普遍痛点,视频领域尤甚——数据体量大、预处理复杂、随机性来源多。VCR-Bench 通过固定配置预设和统一日志,让「报告的数字可以被别人跑出来」成为默认而非奢望。
组件扩展接口的设计同样重要:它意味着这个基准不是一次性的静态产物,而是可以随着新模型、新攻击、新防御的出现持续演进。社区可以在不破坏既有对比基础的前提下贡献新组件。
对视频鲁棒性研究的意义
VCR-Bench 的出现,有望让视频分类鲁棒性研究从「散点式、不可比」走向「标准化、可积累」。当研究者使用同一套协议、同一组指标时,领域内的进展才能被真正量化和追踪。
对于关注视频 AI 安全的从业者而言,这类基础设施的价值往往被低估。它不像一个新模型那样抢眼,但它定义了后续工作的评价尺度。谁的攻击更强、谁的防御更稳,最终都需要在一个公认的擂台上见分晓——VCR-Bench 正试图成为这样一个擂台。
当然,目前的评测仅基于 Kinetics-400 子集,覆盖的数据集和场景仍有限。基准的真正影响力,还取决于社区的采纳程度和后续的持续维护。但作为填补空白的第一步,它的方向清晰且务实。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。