Vela 3.0发布:路由与片段提取合二为一
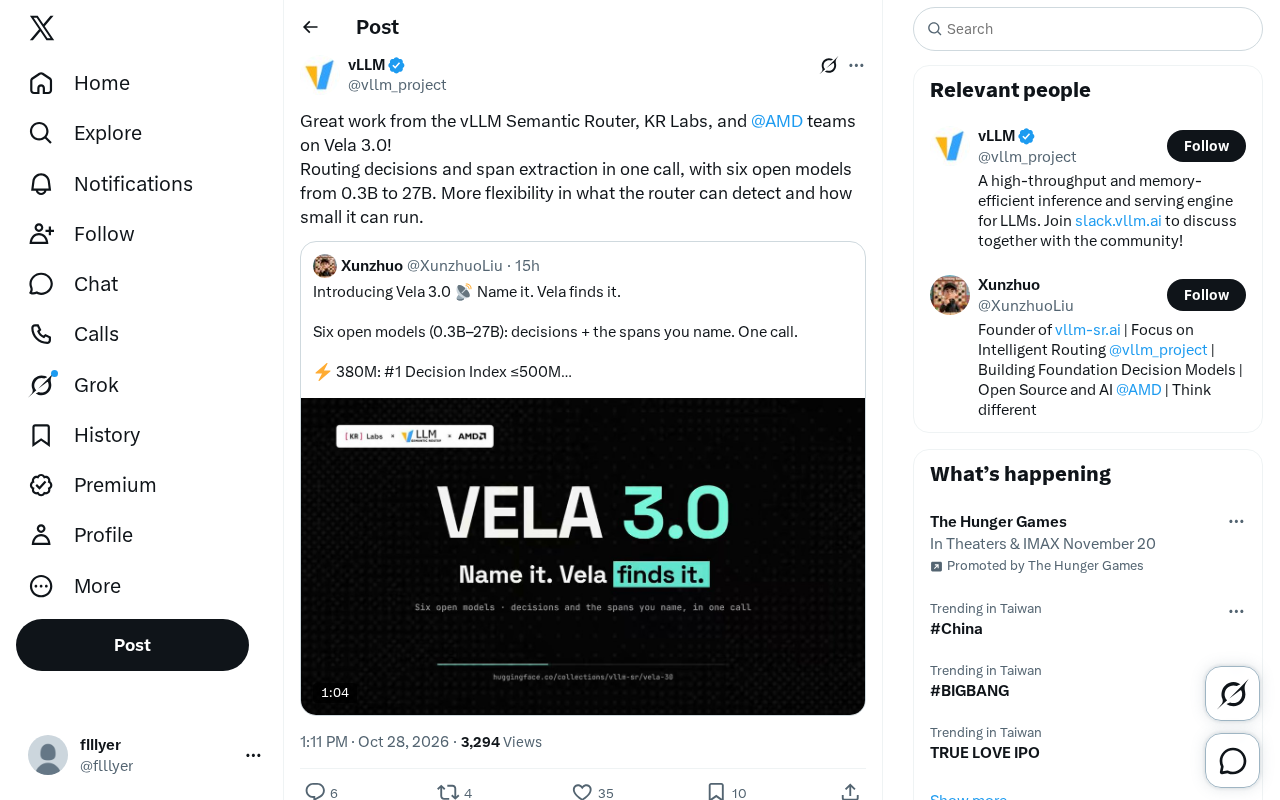
Vela 3.0将路由决策与片段提取合并为单次调用,并提供0.3B至27B六款开放模型。
vLLM Semantic Router、KR Labs与AMD团队联合发布Vela 3.0,核心变化是将语义路由中的路由决策与片段提取合并为单次模型调用,从而减少调用往返开销、降低端到端延迟,并避免两次调用间信息传递不一致的问题。同时发布六款开放模型,参数范围覆盖0.3B到27B,兼顾资源受限的边缘高并发场景与更复杂的语义判断任务。官方强调路由器可检测内容更灵活、可运行的最小规模更小,这共同扩大了语义路由在生产环境中的适用范围。三方协作中AMD的加入暗示了在AMD硬件平台上的适配或优化意图。目前具体性能数据与基准对比尚未披露。
据Twitter上的技术动态,vLLM Semantic Router、KR Labs与AMD团队合作发布了Vela 3.0。这次更新的核心变化是:将路由决策(Routing decisions)与片段提取(span extraction)合并为单次调用,并提供了从0.3B到27B的六款开放模型。
从两次调用到一次:架构层面的合并
在传统的语义路由系统中,路由决策和片段提取通常是两个独立的步骤:先判断请求应该交给哪个模型或处理流程,再从输入中抽取出关键片段。Vela 3.0把这两步合并到同一次调用中完成,意味着系统在决定路由的同时就能输出所需的片段信息。
这种合并带来的直接影响是减少调用开销和延迟。对于需要实时响应的应用场景,少一次往返就意味着更快的端到端响应。同时,单次调用也降低了两次调用之间信息传递不一致的风险。
语义路由(Semantic Routing) 是指用轻量模型对用户请求的语义进行判断,再决定把请求分发给哪个下游模型、工具或处理流程的技术。它与传统的基于关键词或规则的路由不同,依赖模型对意图的理解,因此能在措辞多变的情况下保持稳定的分发效果。语义路由通常部署在请求入口处,对延迟敏感,所以模型体积和调用次数直接决定其可用性。
Span extraction(片段提取) 源自信息抽取任务,指从输入文本中定位并截取一段连续字符区间,例如找出用户查询中真正需要检索的关键实体或指令片段。在路由场景中,片段提取常用于剥离冗余上下文、构造更精确的下游输入。传统实现中它与路由判断分属不同模型或不同调用轮次,Vela 3.0 将二者合并,本质上是用一次前向计算同时产出分类结果与区间定位结果。
六款开放模型覆盖0.3B到27B
Vela 3.0提供了六款开放模型,参数范围从0.3B到27B。这个跨度覆盖了从极轻量部署到较强能力推理的多种需求。0.3B级别的模型适合资源受限的边缘环境或高并发场景,而27B级别的模型则能承担更复杂的语义判断任务。
官方描述强调了两点:路由器能检测的内容更灵活(more flexibility in what the router can detect),以及能运行的最小规模更小(how small it can run)。前者指向检测能力的扩展,后者指向部署门槛的降低——这两者共同决定了语义路由在实际生产环境中的适用范围。
开放模型(Open Models) 通常指权重可公开获取、允许自行部署与微调的模型,区别于只能通过 API 调用的闭源模型。对语义路由这类入口组件而言,开放权重意味着可以本地化部署、控制数据不出域,并能针对特定业务语料做蒸馏或微调。0.3B 级别的模型在量化后可以跑在 CPU 或低端加速卡上,适合高并发、低成本的边缘过滤;27B 级别则更接近通用小模型的能力上限,能处理更细粒度的语义区分。模型谱系跨度大,使得同一套路由框架可以在开发验证阶段与生产部署阶段使用不同尺寸的模型,而接口保持一致。
三方协作的背景
这次发布由vLLM Semantic Router、KR Labs和AMD三方团队共同完成。vLLM Semantic Router本身是围绕vLLM生态的语义路由组件,KR Labs和AMD的参与表明该项目在推理基础设施层面有更深的整合意图。AMD的加入尤其值得关注,它可能意味着Vela 3.0在AMD硬件平台上经过了适配或优化。
vLLM 是当前主流的高吞吐大模型推理引擎,以 PagedAttention 和连续批处理为核心优化手段,广泛用于生产环境的模型服务。vLLM Semantic Router 建立在 vLLM 生态之上,属于请求进入推理引擎之前的调度层。AMD 在推理侧的参与通常涉及 ROCm 软件栈与 Instinct 系列加速卡的适配,若 Vela 3.0 针对 AMD 平台做过优化,则意味着该路由组件可以在非 NVIDIA 的 GPU 环境中获得可用的推理性能,这对希望降低硬件绑定风险的团队具有实际意义。
对语义路由实践的意义
语义路由的核心价值在于用较小的模型成本做出足够好的分发决策。Vela 3.0把决策与提取合一,并给出从小到大的模型谱系,实际上是在降低这套方案的接入成本:开发者可以先从0.3B的小模型起步验证效果,再按需升级到更大的模型。
单次调用完成路由与片段提取的设计,也简化了系统集成时的接口复杂度。对于正在构建多模型调度、意图识别或内容过滤管线的团队,这种合并式接口值得关注。
目前官方披露的信息集中在这两个能力点上,具体性能数据和基准对比尚未展开。后续可以关注各尺寸模型在路由准确率与延迟上的实测表现。
相关推荐
Cursor AI实战:用AI IDE加速编程的效率与成本权衡
深入解析 Cursor AI IDE 的界面布局、Agent/Plan/Debug/Ask 四种模式、模型选择与 Git 上下文集成,并结合实操演示讨论其订阅成本与直连 Claude 的性价比权衡。
免费落地页设计规则库:Claude Code与Cursor实测指南
Claude Code 与 Cursor 可用的免费落地页设计技能 Landing Page Design 介绍:MIT 协议、近 9000 星,先问 offer/受众/行动再规划 12 区块,字体与间距均为硬约束,配套 Redesign 技能改造存量页面,附动效技能下架与星数不代表质量的提醒。
Cursor总写错代码?问题可能出在上下文而非提示词
Cursor反复写错代码,问题可能不在提示词而在上下文。本文解析如何通过补充相关文件、完整报错与预期结果,配合先计划、小步改、跑测试的流程,减少AI编程错误,同时提醒代码审查仍是开发者的责任。