Vercel AI SDK 新增 TypeSafe 评估провайдер,重塑 LLM 评测方式
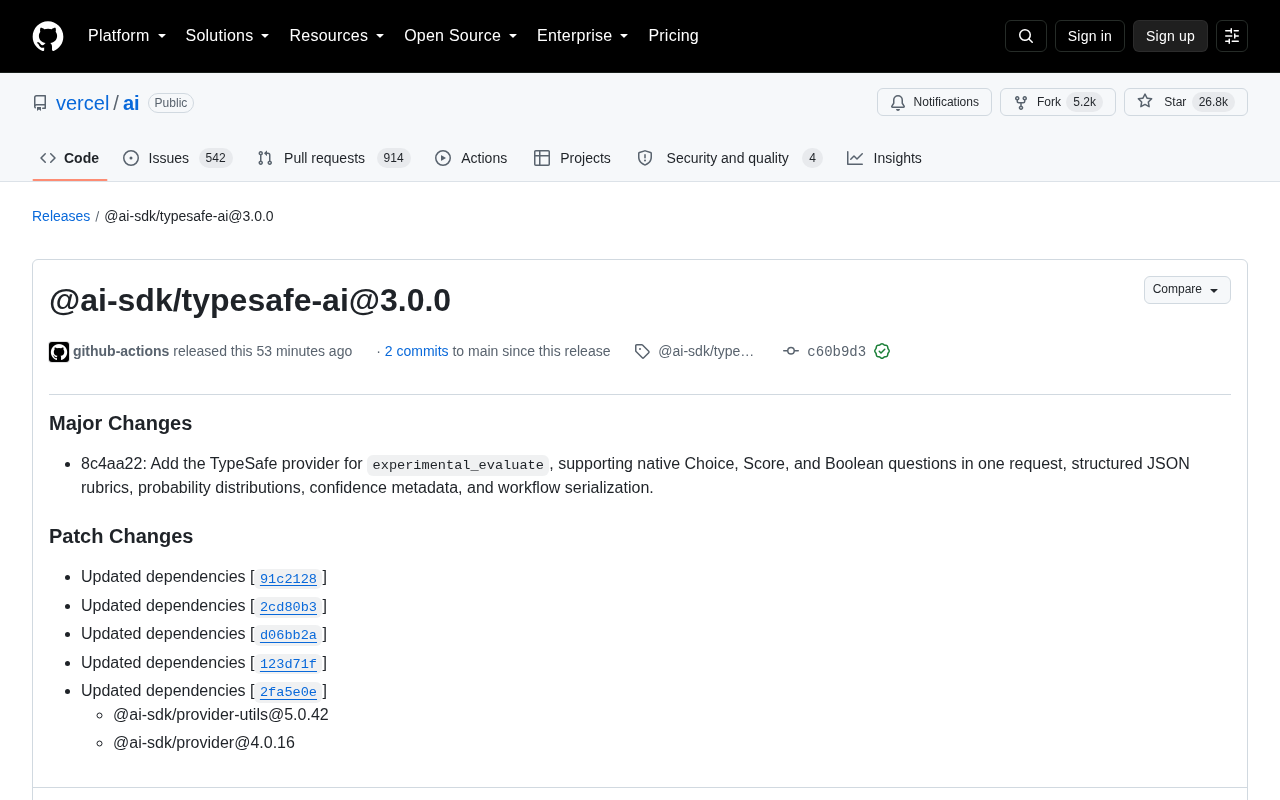
Vercel AI SDK 发布 TypeSafe provider,将 LLM 评估标准化为结构化、类型安全的工程化方案。
`@ai-sdk/typesafe-ai@3.0.0` 引入了专注于 LLM 评估的 TypeSafe provider,核心接口为 `experimental_evaluate`。它允许开发者在一次请求中同时处理 Choice、Score、Boolean 三类评估问题,并以结构化 JSON rubric 定义评分标准,附带概率分布与置信度元数据,使评估结果从单一字符串升级为可量化的结构化数据。此外,工作流序列化能力让评测配置可被保存与复现,TypeScript 类型安全保障则将错误暴露前移至编译阶段。整体而言,此次更新是 Vercel 推动 LLM 评测工程化的重要一步,适合正在为生产级 AI 应用建立可靠评测体系的开发团队关注。
Vercel 旗下的 AI SDK 近期发布了 @ai-sdk/typesafe-ai@3.0.0 版本,为开发者带来了一个专注于 LLM 评估(evaluation)的全新 provider。这次更新围绕 experimental_evaluate 接口展开,试图把散乱的模型评测流程收敛成一套类型安全、结构化的标准方案。
一次请求解决多种评估问题
新版本最核心的变化,是引入了 TypeSafe provider 来支持 experimental_evaluate。它的设计目标很明确:让开发者能够在一次请求中同时处理 Choice(选择题)、Score(打分)和 Boolean(是非判断)三类原生评估问题。
在过去,如果你想用大模型对某段输出做多维度评价——比如既要判断内容是否合规(Boolean),又要给质量打个分(Score),还要在几个候选答案里选一个(Choice)——往往需要分别构造多次调用,再手动拼接结果。TypeSafe provider 把这些能力整合进单个接口,减少了往返请求的开销,也降低了评估逻辑的复杂度。
结构化 JSON 评分标准与概率分布
除了多题型合并,这次更新还带来了几个对可靠性至关重要的特性:
- 结构化 JSON rubrics(评分标准):开发者可以用结构化的 JSON 定义评分细则,而不是把评判标准塞进一大段自然语言 prompt 里。这让评估口径更加一致、可复用。
- 概率分布(probability distributions):模型给出的不再只是一个孤立的答案,而是可以附带各选项的概率分布,帮助判断模型对结论的把握程度。
- 置信度元数据(confidence metadata):进一步补充了每次评估的置信信息,为下游决策提供更多依据。
这些能力合在一起,意味着评估结果从「一个字符串」升级为「一份带有统计意义的结构化数据」。对于需要做质量监控、A/B 测试或自动化门禁(gating)的团队来说,这种可量化的输出格式更容易接入现有的数据管线。
Rubric(评分标准) 是 LLM 评估领域借鉴教育测量学的概念,指对输出质量进行多维、细粒度打分的判断准则。传统做法是将评分规则直接写入 prompt 的自然语言描述中,但这种方式存在两个明显缺陷:一是不同次调用之间措辞的细微差异可能导致模型对规则的理解偏移,二是评分逻辑无法被程序直接解析或复用。将 rubric 结构化为 JSON,意味着每条评判维度(如"逻辑连贯性""内容准确性"等)都成为具名字段,权重与阈值可被显式设定。这不仅让评估标准在团队内对齐更容易,也为后续统计分析和自动化流水线提供了机器可读的输入格式。概率分布(Probability Distribution)则来自模型本身的 token 预测机制——对于选择题类问题,模型在各选项 token 上的 logits 经 softmax 归一化后即可得到概率分布,高集中度的分布意味着模型对答案更有把握,而平坦的分布则提示结论存在不确定性,值得人工复核。
工作流序列化的价值
该版本还提到支持 workflow serialization(工作流序列化)。评估往往不是单点操作,而是由多个步骤组成的流程。能够序列化工作流,意味着评估配置可以被保存、传输、复现,也便于版本管理和团队协作。
这一点在实际工程中经常被忽视,却直接决定了评估体系能否长期维护。一个无法复现的评测流程,其结论的可信度会大打折扣。TypeSafe provider 通过序列化机制,为「评估即代码」的实践提供了基础支撑。
工作流序列化(Workflow Serialization) 在软件工程中通常指将一组操作步骤及其配置转化为可持久化的数据格式(如 JSON、YAML),以便存储、传输和重放。在 LLM 评估场景中,一个完整的评测工作流可能包含:数据预处理、多轮评估调用、结果聚合、阈值判断等多个阶段,每个阶段都依赖特定的参数配置。若这些步骤仅存在于运行时内存中,则难以在不同环境(本地开发、CI/CD、生产监控)之间保持一致。序列化后的工作流可纳入版本控制系统,使评估标准的变更有据可查;也可作为测试用例的一部分,确保模型升级前后的横向对比在完全相同的评测条件下进行。这一机制与基础设施即代码(Infrastructure as Code)的理念一脉相承,是将 AI 评测从临时脚本演进为可治理工程实践的关键一步。
类型安全带来的开发体验
从命名就能看出,这个 provider 的一大卖点是 TypeSafe(类型安全)。在 TypeScript 生态里,类型安全直接关系到开发效率和出错率。当评估问题的输入输出都有明确类型约束时,开发者可以在编译阶段就发现字段错配、结构不符等问题,而不必等到运行时才暴露。
对于把 LLM 评估集成进生产系统的团队,这种编译期保障能显著减少调试成本,也让评估代码本身更接近普通业务代码的可维护标准。
其他更新与总结
除了上述主要变更,本次发布还包含若干补丁级更新,主要是对依赖项的同步升级,涉及 @ai-sdk/provider-utils@5.0.42 和 @ai-sdk/provider@4.0.16 等底层包。
整体来看,@ai-sdk/typesafe-ai@3.0.0 反映出一个趋势:随着大模型应用逐渐进入生产环境,「如何系统化评估模型输出」正变得和「如何调用模型」同等重要。Vercel 通过把评估能力标准化、结构化、类型化,正在把 LLM 评测从一门手工艺往工程化方向推进。对于正在构建 AI 应用并苦于缺乏可靠评测手段的开发者,这个 provider 值得关注和试用。
注:由于该版本标记为
experimental_evaluate,相关接口仍处于实验阶段,生产使用前建议充分验证其稳定性。
相关推荐

Automattic高管在Mullenweg短暂离任期间签署互惠离职协议
Automattic公司CFO Mark Davies与法务负责人Andy Missan在Matt Mullenweg短暂离任期间相互签署离职补偿协议,包含一年薪资与额外股权归属,引发公司治理透明度关注。
H3 Singularity优化技巧:加速40%还能提升画质
Reddit社区分享的Minimax Singularity工作流优化技巧:在H3 Latent前插入RTX上采样器,实现40%加速同时提升画质,附参数取舍与12bit输出实践经验。
X上线Cashtags股票交易功能,社交与市场界限消融
X(原Twitter)宣布向美国用户开放通过Cashtags直接交易的功能,打通市场讨论与实际交易的通道。本文解析这一功能的运作逻辑、社交交易的机遇与风险,以及平台边界扩张背后的趋势。