Verdandi:文档智能开源工具,成本仅为Azure的十分之一

开源文档智能平台Verdandi以97%准确率、十分之一成本挑战Azure ACU,核心是VLM+人工在环。
Verdandi是一位前安永风险咨询分析师自建的文档智能开源平台,从“不想再手动从PDF复制数据到Excel”的朴素需求出发,目标是挑战微软Azure Content Understanding(ACU)。在100份文档的基准测试中,Verdandi字段宏准确率达97.0%,略高于ACU的96.2%,而成本仅为后者的约十分之一(9.7倍差距)。其核心设计理念是VLM不做法官:视觉模型负责提取,文本预言机独立验证提取值是否真的出现在声称的位置,低置信度字段升级到备用模型或人工复核。系统还提供字段级置信度、自定义模板与阈值、跨文档验证、本地OCR、零数据保留模型支持等能力。作者坦诚承认项目仍有局限,包括公开数据集可能存在训练数据污染、准确率差距较小而成本差距更为稳健,并计划通过社区反馈继续迭代。
Verdandi:文档智能开源工具,成本仅为Azure的十分之一
文档处理是许多行业的隐形痛点。一位前安永(EY)风险咨询分析师在B站和GitHub上分享了他自建的文档智能平台Verdandi——一个从"不想再手动从PDF复制数据到Excel"这个朴素需求出发,最终演变成挑战微软Azure Content Understanding(ACU)的开源项目。
这个项目提出的问题很直接:当全球贸易、医疗、保险等行业的文档处理需求本质相同时,为什么每个领域都要买一套不透明、按量计费的封闭工具?Verdandi给出的回答是:一个可自定义、模型可替换、带完整人工复核流程的开源平台。
从安永的日常说起
作者在安永的工作可以用一个词概括——文档。据其描述,从分析师到高级顾问,团队成员每天花超过6小时验证和提取文档数据:打开PDF、分屏Excel、日复一日地复制粘贴。无论职位和经验如何,任务本身没有区别。
更让他困惑的是激励结构:按小时收费的模式似乎比对流程改进的奖励更直接。这促成了一个非技术背景的分析师去啃"最烦人的技术难题"。2026年6月开始构建Verdandi时,他完全没意识到问题的复杂度,而某些验证错误可能直接影响财务数据和结算时间。
他最初只是想找一个能把非OCR PDF转成OCR的工具,但发现开放网络上文档处理相关的产品要么分散、要么极度商业化。在他调研的7到9家全球物流文档处理公司中,没有一家提供透明、终端用户可直接使用的产品,选项永远是"预约演示"或"联系销售"。
Azure Content Understanding曾让他看到希望,但登录Azure Foundry的体验被他形容为"像走进空客A350的驾驶舱"——功能强大但门槛极高。
Azure Content Understanding(ACU) 是微软 Azure AI Foundry 体系下的文档理解服务,属于 Azure AI Document Intelligence 的产品线延伸。它把光学字符识别(OCR)、版面分析、表格抽取、表单字段映射与基于大语言模型的语义理解打包成一套托管 API,用户通过定义 schema(字段模式)让服务自动从发票、合同、报关单等文档中抽取结构化数据。ACU 的计费通常按文档页数或功能层级(如纯 OCR、表格识别、表单+表格组合)叠加计费,并以 Azure 区域列表价为准,因此在大批量文档场景下成本会随页数和功能复杂度快速上升。对终端用户而言,它的主要门槛在于需要在 Azure 门户中完成资源创建、模型部署、配额申请和权限配置,这一整套企业级流程对不熟悉云平台的个人用户相当不友好。
基准测试:97% vs 96.2%,成本差9.7倍
Verdandi在100份文档上与微软Azure Content Understanding进行了基准对比。测试集包括FATURA2清洁发票35份、CORD v2真实印尼收据照片25份、Kaggle扫描发票10份,以及30份合成文档(干净、退化扫描、手写风格、印地语+英语混合、多文档)。
两个系统处理相同的100份SHA256验证文档(共103页),使用相同的8字段模式加行项目,零样本运行,由同一评分者用相同归一化器评分。Verdandi使用GPT-6-luna,ACU使用其支持的最强模型GPT-5.5和text-embedding-3。
| 指标 | Verdandi | ACU |
|---|---|---|
| 字段宏准确率(两次运行均值) | 97.0% | 96.2% |
| 行项目精确率/召回率均值 | 95.4 / 96.3 | 94.2 / 95.3 |
| 行项目F1 | 0.958 | 0.947 |
| 找到文档数 | 100/100 | 100/100 |
准确率差距仅0.8个百分点,作者自己承认"只是两次运行中的几个单元格,ACU在多个字段和杂乱照片上胜出"。但成本差距更为显著:
| 成本项 | Verdandi | ACU |
|---|---|---|
| 总成本(修正后) | $0.2619 | $2.5522 |
| 每份文档 | $0.0026 | $0.0255 |
| 成本比 | 9.7倍 | — |
Verdandi使用了超过两倍的token(约131万 vs 56.8万),但整体成本远低,因为其通过订阅网关获得的每token费率更低。ACU按Azure美国东部列表价计费,且根据OCR、表格、表格+表单等功能有不同的定价层级。
说个细节,作者在caveats中坦诚说明:公开数据集(FATURA2、CORD、Kaggle)可能出现在任一模型的训练数据中,30份合成文档是防污染控制组;Kaggle扫描件风险最高,在kaggle_01上两个系统都读出了错误值。Verdandi有意采用日优先日期策略,因此部分美式日期格式在Kaggle扫描件上被计为未命中。
人工在环:VLM不是最终裁决者
Verdandi的核心设计理念之一是"VLM不做法官、陪审团和行刑者"。系统不会让视觉模型拥有完全决策权。
根据用户设置的置信阈值,VLM会标记出不确定的提取和验证点,由备用模型查看分歧并给出置信答案。如果备用模型也无法准确得出结论,则升级为"flag",由人工介入,视觉确认文档上的实际值。
用户可以查看"模型声称"与"文本声称"的提取数据位置,决定同意、不同意或输入自定义值。
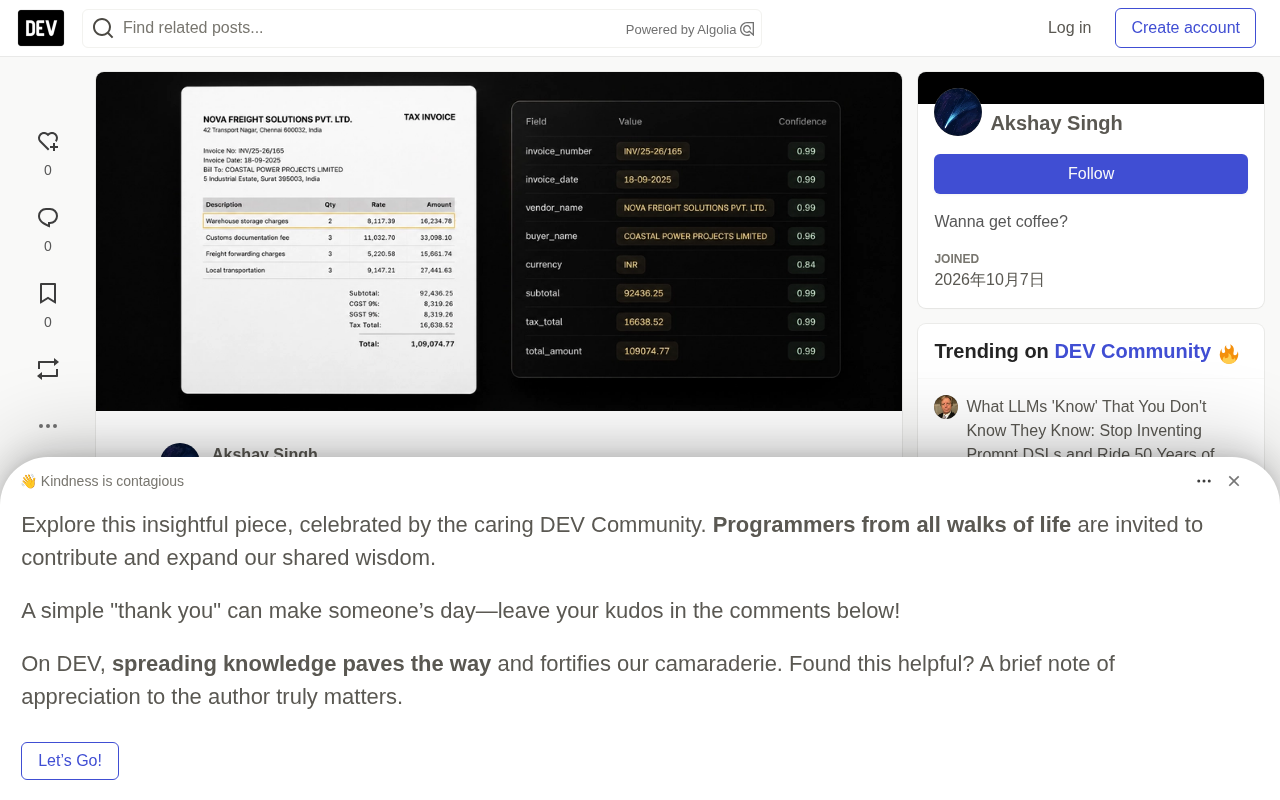
这种设计的哲学基础是:可靠系统不需要对每个字段都返回答案,它应该能够说"我没有足够证据自信地告诉你"。置信度不是AI做论断的自信程度,而是系统为该论断赢得的信任程度。
技术架构:视觉优先,验证其次
文档提取本质上是空间性的。发票号码不只是一个字符串,它存在于特定页面的特定位置,通常在标签旁边、表格内或某种视觉结构中。
Verdandi的OCR层生成结构化文本信息以及数据坐标,而非简单转储大块文本。这为后续的文本管线独立验证视觉模型的决策奠定了基础。
文本预言机(Text Oracle)
当视觉模型提取出INV-49281并声称在第1页某区域找到时,文本预言机执行一个不那么光鲜的任务:"我真的能在那个区域附近的文本中找到INV-49281吗?"
如果找到,就有独立证据支持模型的提取。如果找不到,Verdandi不会自作聪明地发明替代值,而是提出flag。对于文档处理系统,"差不多"可能错得离谱。
作者特别解释了为什么不用另一个AI模型来验证:如果第一个VLM说发票号是INV-49281,再问另一个VLM"你同意吗?",得到的是两个概率系统互相认同,不构成独立真相来源。
独立真相来源(independent source of truth) 是可靠系统设计中的一个关键原则:验证者必须与被验证者基于不同的机制或数据得出结论,否则验证只是重复同一个错误。在文档处理里,如果用另一个 VLM 去“复核”第一个 VLM 的输出,两者共享相似的训练分布和幻觉模式,容易在同一个字段上犯同一类错误,因此不构成有效验证。文本预言机走的是另一条路:它不重新理解文档语义,而是回到 OCR 产出的结构化文本与坐标,做确定性的字符串与位置匹配。这种做法的代价是它无法判断语义是否正确,只能判断“模型声称的值是否真的出现在它声称的位置”,但正因如此,它提供的是与视觉模型相互独立的证据,而不是另一个概率性意见。
置信度是字段级的
一份文档不应该获得一个笼统的"置信度87%"。设想一份海关文件有50个提取字段,其中49个完全可靠,1个因扫描损坏而模糊——文档级分数会掩盖这个问题。
Verdandi在字段级别评估置信度,使不确定性能够附加到具体信息上,让系统能够区分"发票号码高置信度"和"税额需要复核"。
VLM(视觉语言模型,Vision-Language Model) 是一类同时接受图像和文本输入、并输出文本的模型,典型代表包括 GPT-4V/5V 系列、Claude 的视觉版本以及开源的多模态模型。与只处理文字的 LLM 不同,VLM 能直接“看见”文档截图或扫描件,因而可以绕过传统 OCR 管线,直接从像素中读出字段值、表格结构和版面关系。在文档智能中,VLM 的优势是能处理手写、倾斜、表格交错等传统 OCR 容易失效的场景,劣势是它的输出本质上是概率生成,可能“读错但很自信”,并且难以给出可追溯的证据链。Verdandi 正是针对这一缺陷设计了文本预言机与字段级置信度,让 VLM 只负责候选提取,再由独立的文本证据和人工流程来确认。
模板、工作流与跨文档验证
Verdandi的模板系统让用户完全控制数据提取方式。用户可以描述文档(它是什么、长什么样、如何在多个文档中识别它),添加只属于该文档的独特词汇。"Allow-no-match"功能让VLM在不确定找到的文档是否匹配描述时选择标记并放弃,而不是从无关文档提取数据。
每个数据点有独立可自定义的置信阈值。较高的阈值意味着VLM提取的数据必须高度准确,否则在审查区标记为"未达置信阈值"。
对于发票等含行项目的文档,用户可以提取行项目,并在表头措辞不同的边缘情况下输入数据帮助VLM理解提取内容。还可以设置自定义算术规则,如"行项目之和=发票总额",以及表注释说明如何阅读表格。
跨文档验证
这是ACU不具备的功能。当供应商提供包含发票和对应运输单据的文件时,跨文档验证检查文件中的文档是否相关。不相关的文档被标记,可在"审查区"人工复查。
例如,发票上的报关单号是1234567,而报关单上的号码是1234568。独立处理时,两个字段都看起来合理,都可能有高置信度,都正确对应各自文档——但其中一个是错的。跨文档验证让不同文档的字段相互比较。
Verdandi不会自动决定哪个文档错了,而是说:"这两项不一致,应该有人看看。"对于财务和合规文件,基于一个值自动"修复"另一个可能比简单标记差异更糟糕。
零数据保留(Zero Data Retention,ZDR) 是模型提供商提供的一种数据处理承诺:客户的输入和输出不会被用于训练,也不在提供商侧长期存储,仅在完成推理所必需的短时间内存在。对于财务、医疗、法务等敏感文档,ZDR 意味着即使文档被发送到云端模型,也无法被提供商事后调取或用于改进模型。许多企业级 API(如 OpenAI、Anthropic 的部分企业方案)提供 ZDR 选项,但通常需要单独申请或签署协议。在 Verdandi 这类混合架构中,ZDR 与本地 OCR、可排除特定提供商模型、导出后清理磁盘图像等措施配合,构成一套分层的数据治理策略,使用户可以在便利性与隐私之间自行权衡。
隐私与数据安全
- 本地OCR:Verdandi可完全在设备上OCR文档,文档无需离开机器。
- ZDR模型:通过OpenCode,可限制仅使用零数据保留(Zero Data Retention)模型,防止提供商保留提交的数据。
- 提供商控制:可通过OpenCode从可用模型池中排除中国模型。
- 磁盘清理:用户可启用"导出后释放磁盘",在成功导出后删除本地生成的文档图像。
目标是:尽可能保持敏感处理本地化,最小化提供商侧数据保留,让用户控制哪些模型能看到文档。
导出与可观测性
最终的输出层刻意"无聊"。JSON用于程序化工作流,保留Verdandi生成的结构化表示;Excel用于人类后续处理,将行项目表保持为行项目表,而不是变成单元格A17里的["Item 1", "Item 2", "Item 3", ...]。
Run Explorer暴露处理运行的元数据和中间信息:模型使用、token消耗、提取尝试、验证结果、flags、处理事件、错误和失败。这让用户能回答"为什么这份文档处理成本比上一份高"或"哪个模型在这个工作流中消耗最多token"等问题。
坦诚的局限
作者在结论中保持了难得的谦逊。Verdandi仍有粗糙边缘,部分方面需要进一步开发。他计划把项目发到Reddit获取"残酷反馈"——"如果不去Reddit,还能去哪里找一群人对你构建的东西极其诚实?"
未实现的功能包括自学习(将人工验证输出作为未来类似文档处理的上下文)和文档解释器(就文档任何细节进行对话)。他引用《双城之战》的台词作为未竟完美的注脚:"完美没有代价,只有追求的终点。"
Verdandi已在GitHub开源,使用Moonshot、DeepSeek广告和OpenAI的模型构建。对于那些厌倦了"预约演示"和按小时计费文档处理的人来说,这可能是第一个真正透明、可自定义且成本可控的选择。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。