Vibe Coding是什么?大模型+Agent+工作流三层架构全解析

什么是Vibe Coding
Vibe Coding这个词由前特斯拉AI总监Andrej Karpathy提出,一篇帖子直接引爆了整个技术圈。它描述的是一种"只管提需求、全凭感觉走"的编程方式。
人物背景:Karpathy不仅是前特斯拉AI总监,更是深度学习领域的奠基人之一。他曾在OpenAI担任研究科学家,主导了GPT早期研究,后加入特斯拉主导自动驾驶感知系统。他在2025年初发布的那条帖子之所以有分量,正因为他是少数既能写顶级AI论文、又真正大量编程实践的人——他的观察不是营销话术,而是来自一线的真实体验。
Vibe Coding不仅是一种工具使用方式,更折射出编程文化深层的范式迁移。它与"氛围感"(Vibe)的隐喻高度契合——程序员不再需要逐行审阅代码,而是凭借对系统整体走向的直觉感知来驾驭AI,类似爵士乐手的即兴演奏,而非严格照谱演奏。这种转变的背后,是AI编程工具从"自动补全"到"自主执行"的本质跃迁:早期的GitHub Copilot只能在光标处预测下一行;而Vibe Coding时代的工具,已经能够理解意图、分解任务、主动调用工具并验证结果,完成过去只有资深工程师才能独立处理的完整开发环节。
要理解它的革命性,先对比一下过去的AI编程方式。以前我们怎么用AI写代码?把需求写成一段话,AI生成一段代码,小心翼翼复制下来,粘贴到本地编辑器运行——结果报错了,再把报错信息复制回去喂给AI,如此循环往复。这个过程里,人充当了一个疲惫的"肉体搬运工"。
Vibe Coding完全是另一个画风:你只需提出想法和需求,剩下的AI全包了。它会自己阅读本地代码、自己修改、自己编译,报错了自己看报错信息再自己改,直到跑通测试。你甚至懒得去确认它改了哪一行,整个流程在后台自动运转。这种"不动手、全靠自动反馈驱动"的状态,就是Vibe Coding。

大模型:AI编程的超级大脑
为什么以前做不到这么潇洒?因为在AI编程的早期阶段,云端网页里的AI和本地编辑器里的项目代码是两个完全隔绝的世界,全靠程序员用肉体不停做"物理传导"。
这带来了三个痛点:操作极度繁琐(手腕都快得鼠标手了)、效率极其低下(大部分时间浪费在搬运代码上)、上下文严重割裂(大模型根本不知道你本地其他文件长啥样,给出的代码经常和项目八竿子打不着)。
技术演进的关键一步,是把"脑子"和"皮囊"彻底分离。我们平时看到的网页聊天框,说白了只是一个展示用的UI外壳,它自己没有智商,只负责传字和显示。真正厉害的是隐藏在外壳背后的大语言模型——它才是那个能看懂需求、规划逻辑、写出高质量代码的超级大脑。
技术原理:大语言模型(Large Language Model,LLM)本质上是基于Transformer架构的深度神经网络,通过在海量文本数据上进行自监督预训练,学会预测"下一个Token"的概率分布。代码之所以是LLM的强项,是因为代码具有极强的结构规律性和逻辑一致性——比自然语言更容易被统计模式捕捉。当模型参数量突破某个临界点后,会涌现出推理、调试、跨文件理解等在小模型上完全看不到的能力,研究者将此称为"涌现能力"(Emergent Abilities)——这也是为什么"更大的模型"在代码生成上往往有质的飞跃,而非线性提升。值得一提的是,这种涌现并非事先设计,而是随规模扩大"自发浮现",谷歌研究团队2022年的论文《Emergent Abilities of Large Language Models》首次系统记录了这一现象,至今仍是AI领域最具争议也最具影响力的发现之一。
主流大语言模型怎么选
目前市面上的主流模型各有侧重:
- Anthropic的Claude系列:在代码生成这个细分领域是公认的首选,逻辑细腻,生成代码几乎不用改就能跑
- OpenAI的GPT系列:追求全能和通用,什么场景都能应付
- Google的Gemini系列:与谷歌自家生态结合紧密
- 国产大模型:如千问、DeepSeek广告,在算力受限的情况下把效率和性价比做到极致,又聪明又快
不同模型在代码任务上的差异,很大程度上来自训练数据配比和强化学习微调(RLHF/RLAIF)策略的不同。Claude系列在代码领域的优势,普遍被认为与其在"Constitutional AI"训练方法下形成的更强逻辑一致性有关;而DeepSeek等国产模型则通过高效的混合专家架构(MoE)在参数效率上做到了极致压缩,用更少的计算资源实现了接近顶级模型的代码生成质量。
Agent:给AI装上手脚
就算这些大脑聪明到能考上名牌大学,它们依然有一个残酷的物理局限——没有手。大模型住在云端服务器里,由于网络和安全隔离,它没办法穿过网线读取你本地的文件,更别提执行系统命令。它就像一个被关在玻璃房里的超级思想者,无所不知,但如果没人帮它拿东西,什么也改变不了。
打破这个僵局的,就是Agent(智能体)。思路特别简单:既然大模型下不来,那就在本地电脑里安插一个听话的"执行官"。Agent本质上是一个运行在本地的应用程序,充当云端大模型的双手和眼睛,专门执行本地系统级别的操作。
Agent的技术本质:Agent这一概念源自强化学习领域,指能感知环境、做出决策并执行动作的自主实体。在AI编程语境下,Agent的核心是一个"感知-规划-执行"循环:感知本地文件系统和终端输出,规划下一步操作(由LLM负责),执行具体系统调用。现代LLM经过专门的微调训练,能够识别何时需要调用外部工具,并生成格式规范的调用指令,而不是单纯输出文字——这使得AI第一次真正具备了与物理计算环境交互的能力,从"会说话的顾问"进化为"能干活的工程师"。值得关注的是,多Agent协作系统(Multi-Agent System)正在成为下一个前沿方向:多个专职Agent分工协作,一个负责需求分析,一个负责代码生成,另一个专门做安全审查,通过消息队列互相通信——这种架构在复杂软件项目中已展现出超越单一Agent的显著优势。
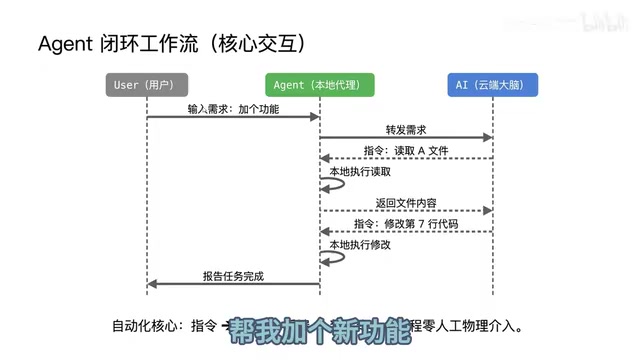
用一个真实场景模拟它们的配合:你输入需求"帮我在界面上加个按钮",本地Agent立刻转发给云端大脑;大脑思考后下令"读取本地A文件",Agent照做并回传内容;大脑看完发出新指令"把A文件第七行改成这段代码",Agent照办;最后Agent确认运行无误,向你汇报任务完成。整个过程,人类完全不需要任何物理介入。
Agent与大模型如何通信
云端大脑和本地Agent之间不全靠大白话——大白话虽好懂但太模糊,机器执行容易出错。当大模型需要执行本地操作时,会输出一段结构严密的JSON代码块,里面清楚写明函数名和参数。Agent的解析器拦截到这个JSON,就发起Function Calling(函数调用),在本地环境精准执行读取、写入或运行命令的操作,保证了执行过程的绝对可靠。
Function Calling的技术细节:Function Calling是OpenAI于2023年在GPT-4中率先引入、后被各大模型厂商跟进的关键能力。开发者在API调用时预先声明一组"工具描述"(JSON Schema格式),模型判断需要调用工具时,会输出结构化JSON而非自然语言,明确指定函数名和入参;客户端解析执行后将结果回传给模型,完成一轮工具调用循环。这种机制的可靠性远超让模型"在文本里描述该怎么做"。2024年,Anthropic进一步推出了MCP(Model Context Protocol)协议,试图将工具调用标准化为行业通用接口,向统一的Agent生态迈出重要一步。MCP的意义可以类比USB接口的统一:在此之前,每家AI工具厂商都有自己的"私有插头",开发者需要为每套工具单独适配;MCP定义了一套统一的服务器-客户端协议,让任何遵循标准的工具都可以即插即用地接入任何支持MCP的AI系统,大幅降低了整个生态的集成成本,也被业界视为AI工具链走向成熟的重要信号。
正因为Agent只是本地执行工具,开发门槛大大降低,也催生了繁荣的工具生态:既有官方自研的Claude Code、Codex,也有第三方集成工具如Cursor、GitHub Copilot、Cline,还有大量开源社区工具。这个生态最棒的特性是自由解耦——你用着第三方框架,可以随时把底层大脑换成Claude或国产大模型,就像买了辆车,发动机想换谁家的就换谁家的。
工程化:驯服脱缰的野马
如果真让AI这样"裸奔"写代码,很快你就会经历程序员生涯的大崩溃。失控编程会带来两个典型灾难:
第一是目光短浅。大模型一次只能看一部分代码,在这个文件修了个bug,结果引发连锁反应,导致另一个不相关的文件彻底崩盘——也就是"修一处崩全盘"。
上下文窗口的技术限制:这个问题的技术根源在于Context Window(上下文窗口)的限制。模型每次处理请求时能"看到"的文本总量有上限,以Token数量衡量——早期GPT-3只有4K Token,Claude 3.5支持约200K Token,相当于一本中等篇幅的小说。但真实工程项目动辄几十万行代码,永远无法一次性全部塞入上下文。这就是为什么Agent需要精准的文件检索操作——通过RAG(检索增强生成)或语义搜索,把最相关的代码片段动态注入上下文,而不是把整个代码库都喂给模型。RAG技术的核心是向量数据库:代码文件被切分成片段,通过嵌入模型(Embedding Model)转化为高维向量存储;查询时,用同样的方式对需求文本向量化,再用余弦相似度检索最相关的代码片段——这个过程每次只取"最关键的一小部分",在上下文有限的条件下实现了对大型代码库的有效理解。上下文管理能力,是区分优秀AI编程工具与玩具工具的核心指标之一。
第二是需求误解。你想让它写个绿帽子剑客塞尔达,它理解偏了,直接给你整出个二次元角色。
根因在于没给AI立规矩。在缺乏工程规范边界的情况下,AI处于极度危险的"野蛮生长"状态。
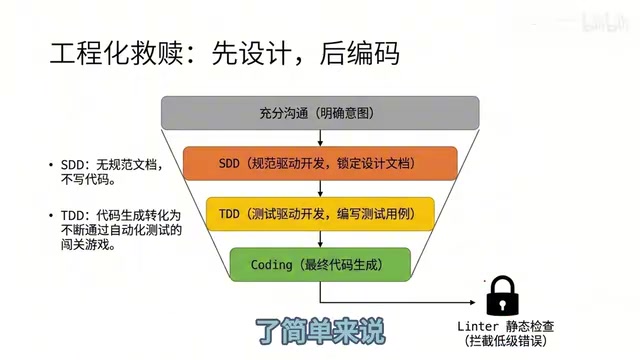
解决之道是软件工程里的"工程化救赎",核心思想是先设计后编码:
- 充分沟通,把需求意图彻底搞明白
- 进入**SDD(规范驱动开发)**阶段,先逼大模型写出规范设计文档,把设计和逻辑锁死在文档里,暂不写代码
- 进入TDD(测试驱动开发),先写好所有自动化测试,然后写代码变成"闯关游戏"——必须不断跑测试直到全部通过
- 最后用Linter静态检查工具做一轮拦截,把低级错误一网打尽
SDD与TDD的软件工程背景:TDD由极限编程(XP)先驱Kent Beck在2003年系统化提出,核心是"红-绿-重构"循环:先写一个必然失败的测试(红),再写最少的代码让测试通过(绿),最后在不改变行为的前提下优化代码结构(重构)。这套数十年积累的成熟方法论在AI编程时代被重新激活,原因深刻:AI生成代码的最大风险不是语法错误,而是"幻觉性正确"(Hallucination Correctness)——代码能运行、语法完整,但逻辑与预期不符,甚至会悄悄修改函数签名或改变已有行为而不给任何提示。自动化测试是目前最有效的"AI幻觉杀手"。把测试写在代码之前,等于给AI圈定了一个客观的验收标准,让它无法用"能运行"来糊弄人。SDD(规范驱动开发)则更进一步,通过要求AI先输出可审查的设计文档,把决策从代码层面提前到语义层面,人类得以在最低成本的阶段介入纠偏——修改一份文档的代价,远低于在代码写完后再大规模重构。
工作流:把工程方法论打包复用
道理都懂,但如果每次写新功能都要手动跟大模型说一遍"先写规范、再写测试、最后写代码",光提示词就得敲几千字,人自己先崩溃了。于是**工作流(Workflow)**诞生了。
工作流的核心思想特别朴实:把那套复杂庞大的工程方法论直接打包、模板化,封装成可重复使用的模板。最终效果是你只需在终端输入一行极简指令,就能触发背后一整套标准化的开发流程。
两个代表性工作流
OpenSpec 把开发流程像外科手术一样切成三步:第一步"探究",AI进入只读模式不停发问,直到需求彻底澄清;第二步"提案",AI输出一份SDD规范文档锁定开发计划;第三步"应用",AI才被赋予写入权限,严格按文档写代码。这种设计的精妙之处在于权限管控——AI在"探究"和"提案"阶段被明确限制为只读,从根本上消除了"需求没搞清楚就乱改文件"的风险,把人类审查的介入点精确锁定在最高价值的节点上。
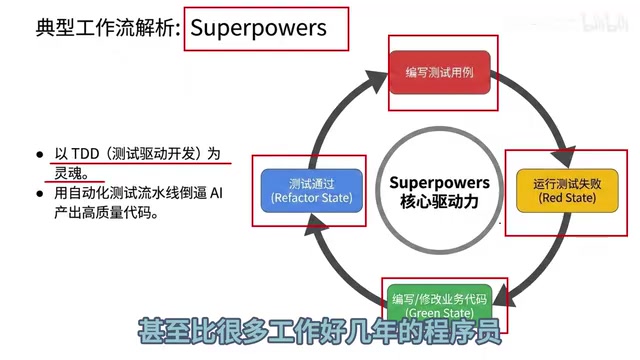
Superpowers 的核心是TDD,它在后台设计了一个自动化死循环:先写测试用例,运行(因无业务代码而失败,系统处于红色状态);接着编写业务代码,再次运行;测试通过后进入绿色状态;然后大模型还会重构代码让它更优雅。这种用自动化测试流水线倒逼AI的方式,产出的代码质量甚至比很多有多年经验的程序员还干净。
拆开这些工作流,里面主要装了三样东西:提示词模板(规范大模型的行为路径)、辅助小程序(如Linter做格式校验)、规则配置文件(如claude.md,相当于项目的"家规",划定全局行动边界)。
提示词模板的设计本身已演化为一门独立学问——提示词工程(Prompt Engineering)。研究者发现,在提示词中加入"Chain-of-Thought"(思维链)指令,明确要求模型在给出答案前先一步步推理,能显著提升复杂任务的准确率;而"Few-shot"示例的加入,则能有效约束模型输出的格式和风格,让工作流的每一步都产出可预期、可解析的结构化结果。工作流本质上是把这些提示词工程技巧系统化、工程化,让普通开发者无需深入研究提示词设计,也能稳定享受到最佳实践带来的质量红利。
三层架构:不被工具淘汰的底层逻辑
回望这两年AI编程的演化,经历了三个清晰的阶梯:
- 1.0 复制粘贴时代:基于聊天窗口,效率低、手工琐碎,程序员就是搬运工
- 2.0 智能代理时代:Agent接管双手,打破本地与云端隔离,AI能自己动手干活
- 3.0 工程工作流时代:引入成熟工程方法论,用规则和逻辑根除系统性失控
面对日新月异的工具,大可不必焦虑。因为技术底层逻辑万变不离其宗——三层架构永远不变:
- 最底层是大模型,提供脑力和逻辑
- 中间是Agent,负责物理交互和本地执行
- 最上层是Workflow,负责工程方法与系统控制
只要把"大模型 + Agent + 工作流"这套框架搞明白,以后不管出什么新工具,你花五分钟就能轻松驾驭。这套三层架构与经典软件工程中的"表现层-业务层-数据层"分层思想一脉相承,其稳定性来自于每一层的职责边界足够清晰:大模型专注认知推理,不承担执行副作用;Agent专注系统交互,不掺杂业务逻辑判断;Workflow专注流程编排,不直接耦合具体工具实现。正是这种关注点分离(Separation of Concerns)的设计哲学,让整个体系在工具频繁迭代的情况下依然保持结构稳定。
未来编程的终极形态一定是软件工程的彻底自然语言化——也许不久你只需说一句"我想写个塞尔达这样的游戏",模型、Agent和工作流就会自动咬合,直接帮你把游戏造出来。
但在那个时代到来前,最真诚的生存建议是:不要盲目追逐现象级新工具,而要把这套底层架构逻辑学透。在工具日新月异的时代,只有掌握底层逻辑的人才永远不会被淘汰。
核心要点
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。