Vibe Coding企业级实战:Claude Code+Codex工程化开发

从Vibe Coding到工程化,实战拆解AI编程的企业级进阶路径与工具选型。
文章记录了B站UP主朱老师的一节实战课程,探讨AI编程工具如何从"氛围编程"跨越到企业级工程化。作者指出,Vibe Coding适合产品经理快速做出Demo,但面对分布式、微服务、高并发等复杂业务时,生成代码难以维护、bug修复易陷入死循环。课程设计了三层递进路径:纯Vibe Coding、计划模式,以及基于Claude Code的Super Power插件、覆盖需求到部署全流程的工程化开发。文章还对比了Claude Code与Codex的能力与可用性差异,讨论了模型选择的优先级,并以OpenRouter类模型聚合平台为例说明套壳生意的商业逻辑,最后提及阿里内部AI工程化体系的推进情况。
AI编程工具正在重塑开发者的工作方式,但“氛围编程”(Vibe Coding)与企业级工程化之间仍存在巨大鸿沟。B站UP主朱老师在一节实战课程中,用Claude Code和Codex两个工具,从零演示了如何跨越这道鸿沟。
为什么Vibe Coding做不了企业级项目
Vibe Coding源自海外,核心逻辑是“你描述想法,AI生成代码”。对于产品经理或非技术背景的创作者来说,这确实降低了开发门槛。早期不少博主用这种方式做出了补光灯、番茄钟、跨境小网站等工具,甚至宣称“程序员要被干掉了”。
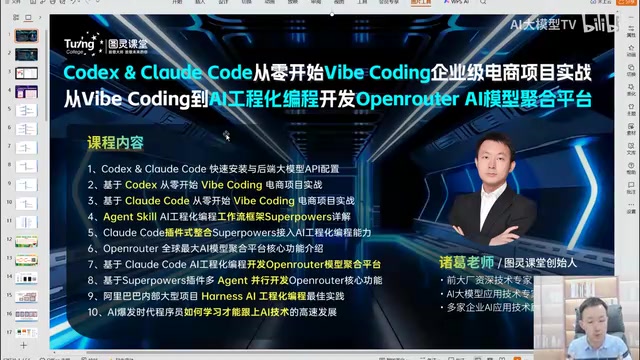
但朱老师指出,这类项目功能极其简单,往往两句话就能描述完。一旦项目规模变大、业务逻辑变复杂,问题就会暴露:生成的代码难以维护,线上出bug后非技术背景的指挥者无法有效指导AI修复,项目很容易陷入死循环直至停滞。
企业级项目的本质是业务复杂、技术复杂——分布式、微服务架构、高并发场景,这些都不是简单描述需求就能让AI一次性写对的。Vibe Coding可以快速产出Demo,但距离可维护、可迭代的企业级系统还有很长的路。
Vibe Coding 一词由 AI 研究者 Andrej Karpathy 在 2025 年初提出,指开发者完全顺应 AI 的代码生成、不逐行审查、凭"感觉"推进的开发方式,其典型工作流是自然语言描述 → AI 生成 → 直接运行 → 报错再描述。它与 AI 辅助编程(AI-assisted coding)的区别在于人的介入程度:后者要求开发者理解并审核生成代码,前者则把审阅责任交给工具本身。这正是它在小项目中效率极高、在复杂系统中迅速失效的根本原因——缺乏人类对架构与契约的把关,代码质量无法随规模收敛。
三层递进的实战路径
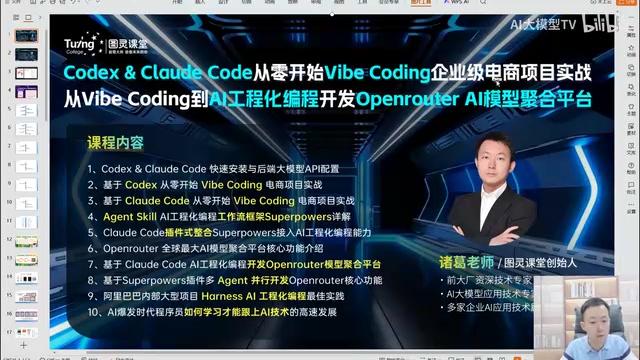
课程设计了一条从易到难的路径,对应三种开发模式:
第一层:纯Vibe Coding。 用Claude Code和Codex各建一个电商项目文件夹,给几句需求就让AI直接开写。几分钟内就能看到可运行的页面,适合理解工具的基本能力边界。
第二层:计划模式(Plan Mode)。 Claude Code和Codex都提供计划模式,AI会先拆解需求、规划步骤,再动手写代码。相比直接生成,这种方式对稍复杂的项目更可控。
第三层:工程化编程。 这是课程的核心。基于Claude Code的Super Power插件,用一套覆盖需求分析、开发、测试、部署全流程的Skill体系来开发真正的企业级电商项目。Super Power包含数十个Skill,本质上是把大厂内部的AI工程化规范封装成了可复用的开发流水线。
计划模式(Plan Mode)是当前主流 AI 编程工具的一种交互范式:模型在写代码前先输出结构化的实施计划(涉及哪些文件、改动顺序、依赖关系、验证方式),由用户确认或修改后再执行。它相当于把"需求分析—方案设计"这一步显式化,减少模型在长任务中偏离目标。与之配套的常见实践还有规则文件(如 CLAUDE.md、AGENTS.md)与上下文管理,用持久化的项目约束替代一次性提示,这也是从"对话"走向"流水线"的关键过渡。
Claude Code与Codex的真实能力对比
朱老师对两个工具的评价相当直接:Claude Code在专业开发者中使用最多,能力最强,其内部有一套非常成熟的AI工程化体系,对专业化编程做了大量优化。但问题在于Anthropic的CEO“非常排华”,最新模型仅限美国使用,封号频繁且恢复麻烦,导致他本人现在用得越来越少。
Codex早期比Claude Code差很多,但GPT最新版本发布后能力提升明显,加上使用限制更少,他现在的使用频率反而更高。国内工具方面,Codebody、Trae、Cursor也都不错,但核心还是看背后的模型能力——模型排第一位,工具排第二位。
在后端模型选择上,他试过智谱GLM、小米MiMo、DeepSeek广告等国内主流模型,认为GLM是目前最好用的一梯队,DeepSeek性价比最高,MiniMax、Kimi、腾讯混元也都在可选范围内。
文中提到的"模型排第一位,工具排第二位",指向的是 AI 编程工具的分层结构:底层是模型能力(推理、长上下文、代码生成与工具调用),中层是代理框架(文件读写、命令执行、多轮规划、子代理调度),表层才是 IDE 或 CLI 的交互形态。同一模型接入不同工具,效果差异主要来自上下文组织与工具调用策略;而不同模型在同一工具下,差距往往更为显著。因此评估工具时应区分"模型上限"与"工程封装",前者决定天花板,后者决定稳定性与可复现性。
OpenRouter套壳网站为什么这么赚钱
课程第二个项目是开发一个类似OpenRouter的AI模型聚合平台。OpenRouter是全球最大的AI大模型聚合平台,接入了市面上几乎所有主流模型,部分还免费或低价可用。
朱老师在这里抛出了一个反直觉的判断:当前AI领域最赚钱的不是面向C端的AI应用——豆包、腾讯元宝这些都在亏钱——而是卖算力的、卖token的,以及做token套壳聚合的网站。他身边有朋友做这类出海套壳网站,十几人团队一年做到一两个亿的流水。
这个项目的教学价值在于:它既是一个真实有商业价值的项目类型,又能让学员理解API聚合、多模型路由、计费系统等企业级开发中的常见架构模式。
模型聚合平台的核心机制是统一 API 网关:对外提供与 OpenAI 兼容的接口协议,对内对接多家厂商的模型端点,通过路由策略在价格、延迟、可用性之间做权衡,并在失败时自动回退到备用模型。其商业模式通常是在上游 token 批发价上加价转售,或提供预付费额度与用量统计。这类项目的技术难点不在模型本身,而在计费对账的准确性、密钥与配额管理、多租户隔离以及流式响应的透传稳定性——这些正是企业级后端工程的典型课题。
大厂在怎么做AI工程化
课程还涉及国内头部大厂的AI编程实践。据朱老师透露,阿里内部正在推行一套完整的AI工程化编程体系,包含从需求到上线的全流程规范,他有一份内部文档会在课程中解读其整体思想(因实践内容过多,仅讲大体框架)。
这部分的价值在于让学员看到:AI编程不是“打开对话框让AI写代码”这么简单,大厂已经在把它变成一套可管理、可审计、可协作的工程流程。Super Power这类插件,某种程度上就是这种流程的开源化封装。
开发者该从中看到什么
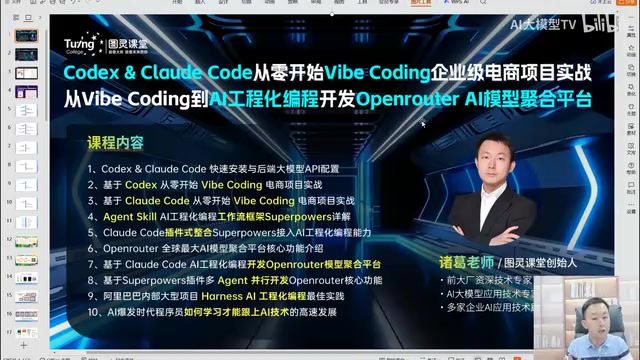
这节课程的信息密度不小,但真正值得关注的不是具体工具的操作步骤——那些看文档就能学会——而是两个结构性判断:
其一,Vibe Coding的边界是清晰的。它能帮你快速验证想法、做原型,但企业级项目的复杂度决定了它必须辅以工程化规范。把AI编程等同于“不用懂技术也能做系统”,是对工具能力的误读。
其二,工具选型正在从“哪个IDE好用”转向“哪个模型+哪套工程流程好用”。VS Code + Claude Code插件、Codex桌面端与CLI的组合,代表的是“轻编辑器+强AI代理”的新范式,传统重型IDE如果不转型,处境会越来越尴尬。
对于想跟上这波变化的开发者,朱老师的建议很朴素:这是个需要终身学习的职业,AI不会淘汰所有人,但会淘汰停止学习的人。
相关推荐

RAG入门实战:从原理到企业级知识库搭建
B站RAG保姆级课程精华解读:从检索增强生成的核心原理、文档切分与向量化流程,到影响准确度的五大因素及企业级知识库搭建的适用边界,附微调与RAG的选型建议。

AI大模型选型指南:DeepSeek与千问三实战对比
AI大模型开发者如何选型?本文基于B站教程内容,拆解DeepSeek V3与R1的Function Calling差异、千问三的编程式思维模式切换与智能体能力,并梳理多模型并行的学习路径与实战选型逻辑。

锚定、损失厌恶与助推:零售商操纵你花钱的5种心理战术
行为经济学揭示零售商如何用锚定效应、框定效应、损失厌恶和助推理论操纵你的消费决策。本文拆解5种常见心理战术,并给出放慢决策、自定锚点等反制方法,帮你看穿折扣背后的定价设计。