Vibe Coding实战一个月:零代码开发踩过的坑与经验总结

Vibe Coding让人不用写代码,但从能跑到可靠运行,坑远比想象深。
一位零编程经验的创作者用AI编程智能体Codex完成了两个真实项目,发现Vibe Coding虽然免去了写代码,但因AI输出的随机性、错误逐步放大和自然语言的模糊性,开发过程极其痛苦。他总结出三条核心经验:必须深度参与AI开发全过程、建立强制验收机制检验输出、技能文档要分层管理。Vibe Coding的本质不是让人退出开发,而是让人从代码执行者转变为系统架构师和质量守门人。
Andrej Karpathy 在 2023 年预言"未来最火的编程语言是自然语言",由此催生了 Vibe Coding 的概念——人类只需用自然语言描述需求,AI 负责写代码、跑程序。这听起来像是零基础用户的逆袭机会,也像是程序员的生存危机。
但真实体验究竟如何?一位完全没有软件开发经验的创作者,花了整整一个月,用 OpenAI 的编程智能体 Codex 做了两个真实项目,全程不写一行代码。他的结论是:代码确实不用写了,但坑比想象中深得多。
为什么选编程智能体而非聊天AI
很多人尝试 Vibe Coding 的第一反应是用 ChatGPT 或 DeepSeek广告 来辅助开发,但编程智能体(如 Codex)与聊天 AI 有本质区别。Codex 可以直接在本地电脑上调用各种编程工具和语言,自动完成从代码编写到执行的全流程。
而如果使用聊天 AI,人类就变成了"本地电脑与 AI 之间的信使"——反复复制粘贴、汇报运行结果。更麻烦的是,人类在传递信息时会不自觉地压缩或扭曲细节,导致整个开发过程反而不流畅。
当然,选择 Codex 的代价也不小。140 元/月的 Plus 账户基本做不了像样的真实项目,必须升级到 700 元/月的 Pro 账户。Vibe Coding 的第一个感受就是:很费钱。
两个真实项目的Vibe Coding开发历程
项目一:Obsidian 数学笔记 PDF 导出工具
第一个项目来自真实需求:将 Obsidian 中包含大量数学公式和 SVG/PNG 插图的笔记导出为精美的 PDF。开发流程非常直接——用中文向 Codex 描述需求,它创建代码和界面,测试不满意就让它改,反复迭代约 20 次就完成了。
成品效果不错:目录、正文样式、插图排版都符合要求,甚至还做了一个 Windows 客户端安装引导程序。整个过程比较顺利,给了作者极大的信心。
但后来证明,这种顺利恰恰是最大的陷阱。
项目二:直播自动切片系统
第二个项目复杂得多。需求是输入一场 2-3 小时的直播录像,自动完成以下全部流程:
- 提取字幕并校正错别字
- 将字幕整理为文字稿,自动保存到 Obsidian 笔记库
- 智能精选 2-3 个精华片段(需要 AI 理解内容并判断重点)
- 对片段进行信息压缩(删除口水话、停顿)
- 烧录字幕到视频中
- 全程自动,无需人工介入
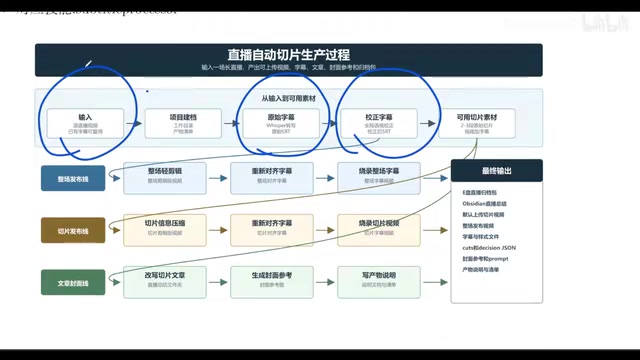
最终这个项目确实做成了,连续测试十几二十场直播,输出全部符合要求。但开发过程极其痛苦——作者在 B 站发的动态记录了"精神状态非常崩溃"的几十个小时。
Vibe Coding最大的坑:以为提需求就够了
在犯了大量错误并与高手交流后,作者总结出一个核心认知:不要误以为 Vibe Coding 就是"提需求→测试→OK",远远没有那么简单。
问题的根源在于大语言模型的几个固有特性:
1. AI输出具有随机性。 即使技能文档里写了明确规则——"不能动某个文件""必须用什么格式"——Agent 未必会遵守。它不像传统 Python 程序那样一步步执行,而是会"选择性执行"。
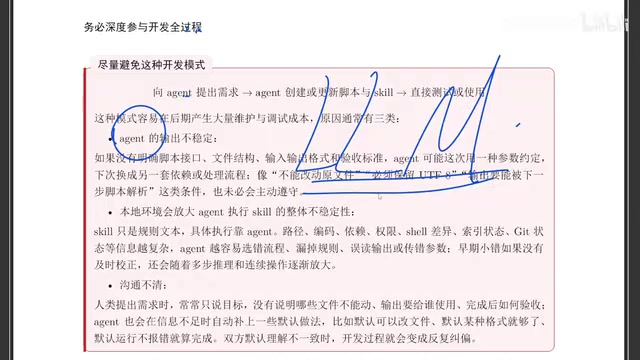
2. 错误会逐步放大。 大语言模型逐字预测的特性意味着,如果中间某一步出错且未被及时纠正,后续推理会让错误越来越大,最终偏离目标。
3. 自然语言存在灰色空间。 人类描述需求时会默认很多东西不说出来。比如"照某个模板生成字幕样式",AI 的理解可能每次都不同,十场直播就可能得到十种不同的字幕样式。
三条Vibe Coding血泪经验
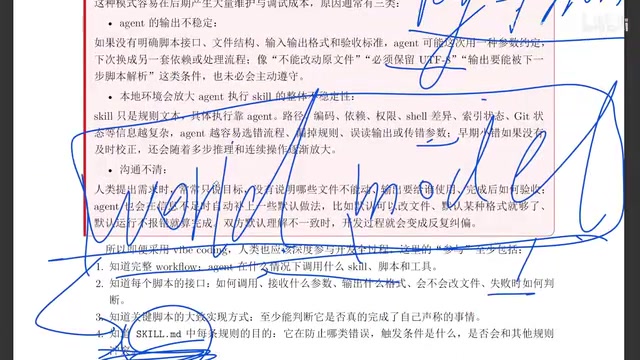
经验一:必须深度参与AI开发全过程
即便不写代码,你也必须清楚:
- Agent 在什么时候调用哪个脚本、哪个工具
- 每个脚本的接口接收什么参数、输出什么格式
- 失败如何判断、如何定位问题
- 脚本具体是怎么实现的(否则 Agent 可能"声称完成了但其实在撒谎")
你对某个细节不清楚的地方,Agent 就可能在那里犯错。 你不了解运作原理,就无法设计验收机制。
经验二:用强制验收机制检验AI的输出
这是让项目质量真正稳定下来的关键转折点。
作者之前浪费了大量时间处理每次不同的输出和各种小错误,根本原因是没有建立"硬验收标准"。比如直播总结文章,一开始 Agent 每次输出的格式都不一样,有时甚至只写三五句话就声称"概括了所有内容"。
解决方案是建立多层硬验收门槛:
- 文章门槛:强制检查文章是否包含指定章节,每个章节是否达到最低字符数
- 字幕样式门槛:验证字幕格式是否符合模板
- 输出文件清单门槛:检查所有应输出的文件是否齐全
- 视频压缩门槛:防止 Agent 偷工减料
- 归档格式门槛:文件名和目录结构是否符合标准
不符合要求时,程序返回失败,Agent 必须找原因并重新执行。不能让 AI 自己承认"我成功了",必须有硬的验证程序来判定。
经验三:技能文档要分层管理
随着发现的问题越来越多,技能文档从最初的 30 行膨胀到数百行、上万 token。但过长的技能文档反而会降低 Agent 的表现——上下文越长,注意力越分散。

解决方案是分层架构:主技能文件(skill.md)只写核心流程和规则,各种分支细节、错误处理方案、检查脚本的调用方式放到 references 目录中,按需加载。
更关键的是,作者建立了双副本机制:
- 机器执行版:干净、精简,只有命令和执行规则,没有注释
- 人类阅读版:在 Obsidian 中维护,记录每条规则的原因、规则之间的依赖关系、全局一致性说明
这样做的原因是:当前 AI 缺乏"世界模型",修改第 10 条规则时不会意识到它和第 134 条规则矛盾。局部优化可能导致全局负优化,而人类擅长把握这种全局一致性。
Vibe Coding的真正启示:人类角色如何转变
AI 确实让"写代码"这件事变得简单了——一个自然语言需求很快就能变成脚本、函数甚至小工具。但真实的软件开发远不止写代码:需求有没有说清楚?系统上下文有没有理解?后期维护谁来负责?
从"能跑起来"到"可靠地跑起来",中间隔着的才是工程的核心价值。
AI 越强大,局部实现的成本越低,工程师的价值就越向高层转移。真正稀缺的能力是:
- 把模糊需求拆解为清晰的模块和接口
- 判断哪些部分要解耦、哪些输出格式必须固定
- 确保交付可用、可复现、可定位问题
- 识别系统性风险藏在哪里
AI 擅长在局部环节做出看起来唬人的东西,但它很难判断需求本身对不对、接口适不适合长期维护、这么干的系统性风险在哪里。Vibe Coding 不是让人类退出开发,而是让人类从写代码的执行者,变成了整个系统的架构师和质量守门人。
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。