Vibe Patenting:LLM评审员能胜任专利撰写评估吗?
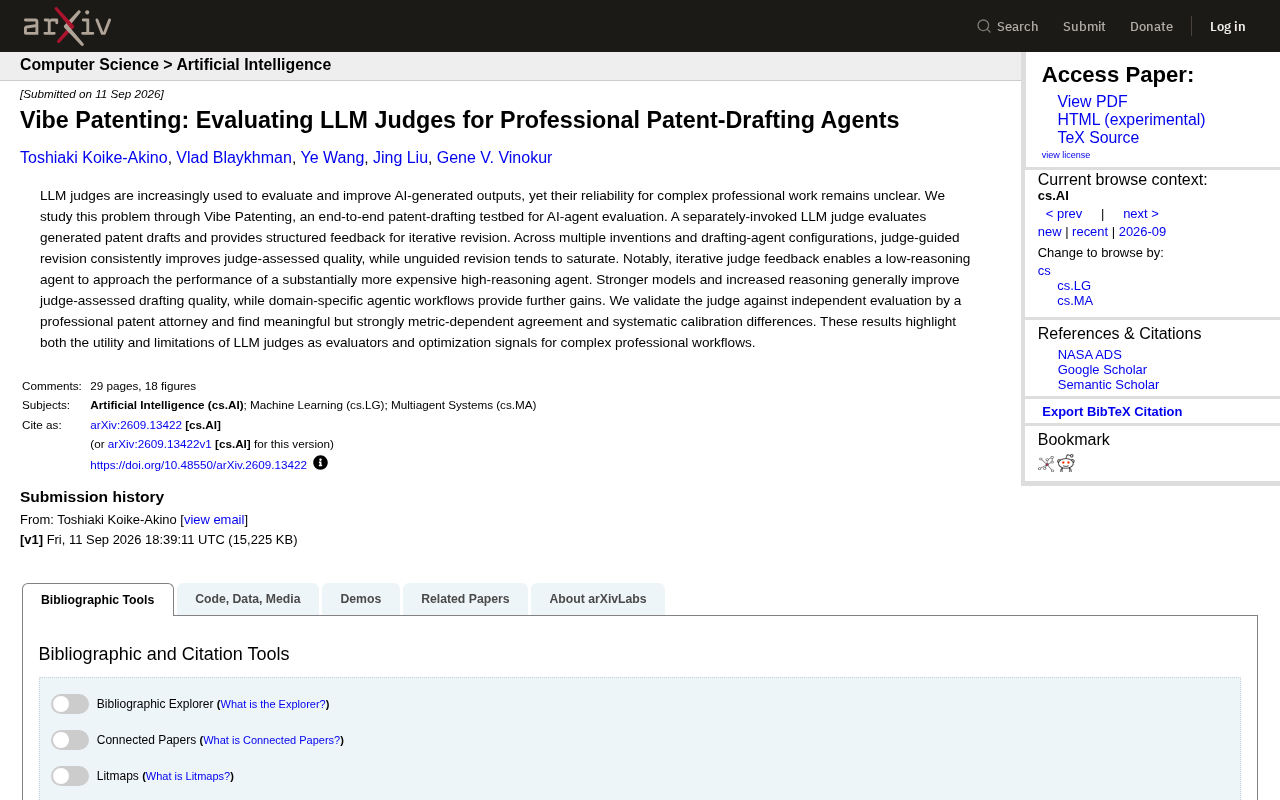
研究发现LLM评审员能有效引导专利草稿迭代改进,但其与专业律师的一致性强烈依赖具体评估指标。
这篇arXiv论文通过"Vibe Patenting"测试平台,系统评估了LLM评审员在专利撰写这一高专业门槛任务中的实际价值与局限。研究发现,评审引导的迭代修订能持续提升草稿质量,而无引导的自由修订很快饱和;更值得关注的是,有效的评审反馈机制甚至能让低成本的"低推理"智能体逼近昂贵的"高推理"配置,提供了一条用工作流设计换取模型能力的实用路径。然而,将LLM评审员的打分与专业专利律师独立评估对比后,研究发现二者一致性高度依赖具体指标,并存在系统性校准偏差。这既肯定了LLM评审员的工程价值,也警示开发者:在高专业门槛场景中,自动化评估不能盲目信任,必须针对具体维度进行人工校准。
当LLM成为专业工作的"裁判"
大语言模型(LLM)正越来越多地被用来评估和优化AI生成的内容——这类扮演评审角色的模型被称为"LLM judges"(LLM评审员)。它们能快速给出打分和反馈,看似为AI系统的自我迭代提供了闭环。但一个关键问题始终悬而未决:在需要高度专业知识的复杂工作中,这些AI评审员到底靠不靠谱?
一篇发表于arXiv的最新研究(arXiv:2609.13422)选择了一个极具挑战性的场景来回答这个问题——专利撰写。研究者构建了一个名为 Vibe Patenting 的端到端测试平台,专门用于评估AI智能体在专利起草任务中的表现,同时检验LLM评审员作为评估者和优化信号的可靠性。
Vibe Patenting 是怎么运作的
该测试平台的核心设计是一个"起草—评审—修订"的迭代循环。一个独立调用的LLM评审员负责评估生成的专利草稿,并输出结构化的反馈意见,供起草智能体进行下一轮修订。这种解耦设计——评审员与起草者分离——是为了模拟真实专业工作中"作者"与"审阅者"的角色分工。
研究覆盖了多个不同的发明主题和多种起草智能体配置,以确保结论不局限于单一案例。这样的设定让研究能够系统性地比较:有评审反馈引导的修订,与没有引导的自由修订,二者在质量提升上的差异究竟有多大。
评审反馈带来的实际增益
研究最引人注目的发现,是评审引导的修订能持续提升草稿质量,而缺乏引导的修订则往往很快陷入饱和——也就是说,模型自己反复改写,改到一定程度就无法再进步。
更有价值的一个结论是:迭代式的评审反馈能让一个"低推理"(low-reasoning)的智能体,逼近一个成本高得多的"高推理"(high-reasoning)智能体的表现。这意味着,与其一味堆算力、上更贵的模型,不如引入一个有效的评审反馈机制,用相对低廉的方式获得接近高端配置的产出质量。这对实际部署中的成本控制具有直接意义。
此外,研究也确认了一些符合直觉的规律:更强的基础模型、更多的推理投入,通常都会带来更高的草稿质量;而针对专利领域定制的智能体工作流,则能在此基础上进一步提升表现。
与人类专利律师的对比:关键的一步验证
如果只是让LLM评审员自己评自己,那这套循环很容易变成"自说自话"——模型可能只是在优化它自己认可的指标,而非真正的专业质量。为此,研究者做了一项至关重要的验证:将LLM评审员的评估结果,与一位专业专利律师的独立评估进行对比。
结果呈现出一种"有价值但强烈依赖指标"(metric-dependent)的一致性。换句话说,在某些评估维度上,AI评审员与人类专家的判断相当吻合;但在另一些维度上,二者的一致性就明显减弱。研究还发现了系统性的校准差异——AI评审员在打分尺度上与人类专家存在稳定的偏差。
这个发现既是肯定也是警示:LLM评审员确实捕捉到了部分真实的质量信号,但它并非人类专家的完美替代品,其可靠性高度取决于你关注的是哪个具体指标。
对AI专业化应用的启示
这项研究的意义超出了专利撰写本身。它揭示了LLM评审员在复杂专业工作流中的双重面貌:既是有用的优化工具,也存在明确的局限。
对于希望用AI辅助高专业门槛任务(如法律文书、医疗报告、金融分析)的开发者而言,几点启示值得记取:
- 评审反馈驱动的迭代,是提升产出质量的有效杠杆,甚至可以部分替代对更昂贵模型的依赖;
- 不能盲目相信LLM评审员给出的分数,尤其是在跨指标比较时,需要针对具体维度做人工校准;
- 领域定制的工作流设计仍然不可或缺,通用模型加上专业化编排才能获得最佳效果。
Vibe Patenting 的价值在于,它没有停留在"AI能不能写专利"这个表层问题,而是深入追问"我们用来评判AI的那把尺子,本身是否可信"。在AI系统日益依赖自动化评估进行自我改进的今天,这个问题的答案,直接关系到整个优化闭环的可信度。
相关推荐
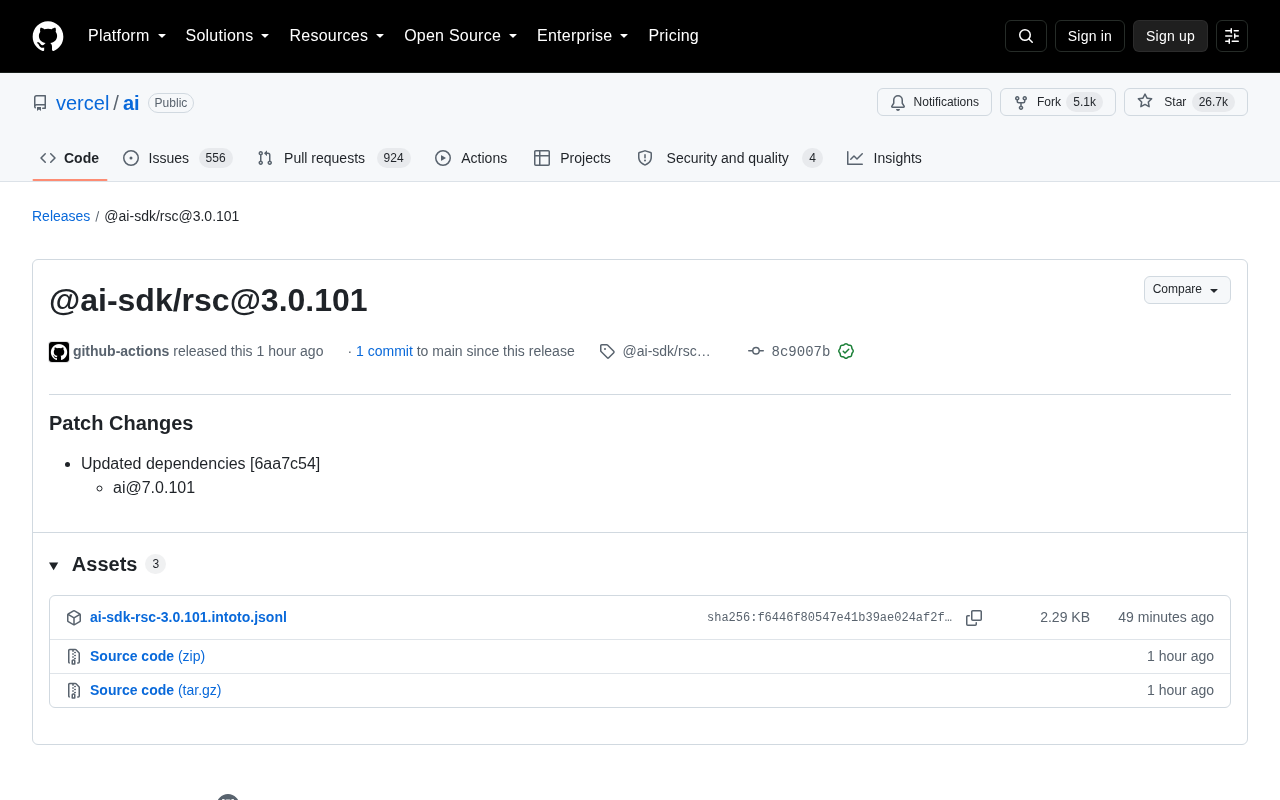
Vercel AI SDK 发布 @ai-sdk/rsc@3.0.101 补丁更新
Vercel AI SDK 发布 @ai-sdk/rsc@3.0.101 补丁更新,同步升级 ai 核心包至 7.0.101。本文解读该版本的更新内容、@ai-sdk/rsc 的作用及对开发者的影响。
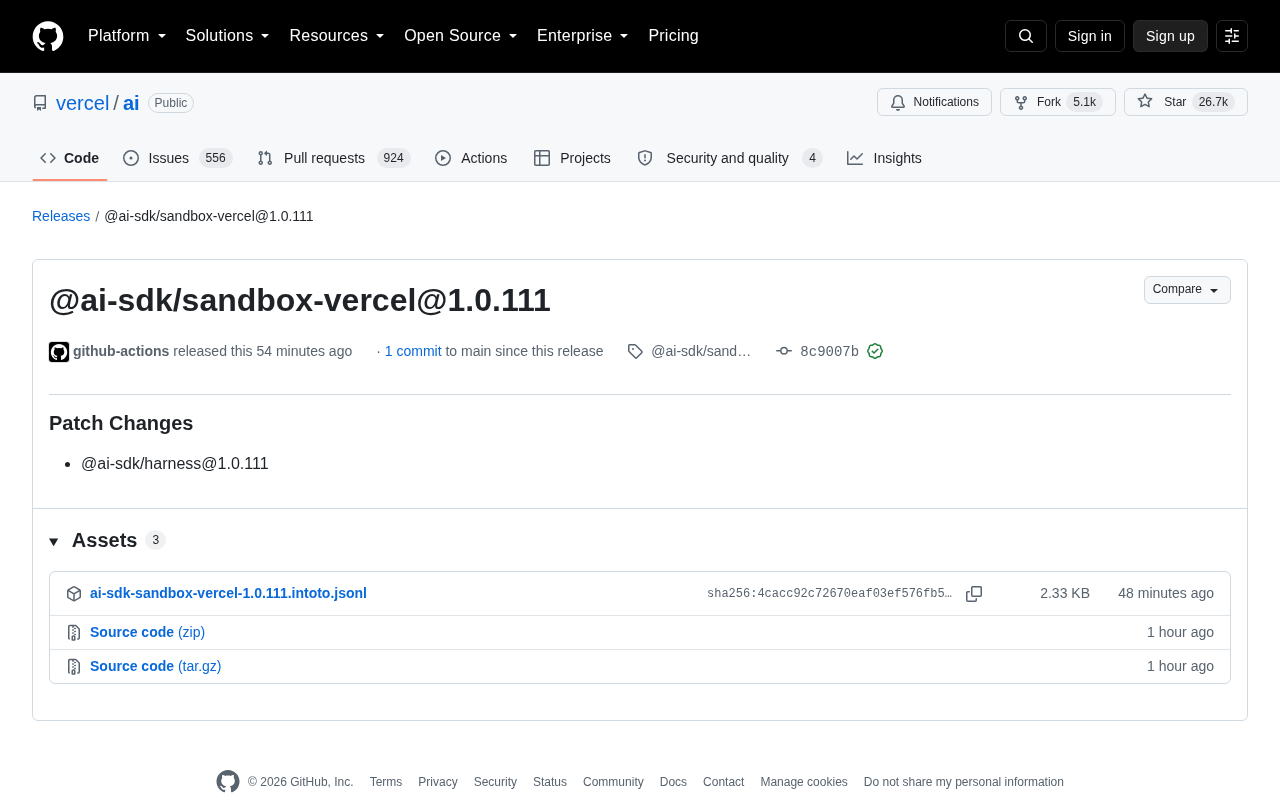
Vercel AI SDK 发布 sandbox-vercel@1.0.111 补丁更新
Vercel AI SDK 发布 @ai-sdk/sandbox-vercel@1.0.111 补丁版本,同步升级 harness 依赖。本文解析该版本更新内容、monorepo 版本管理策略及开发者升级建议。
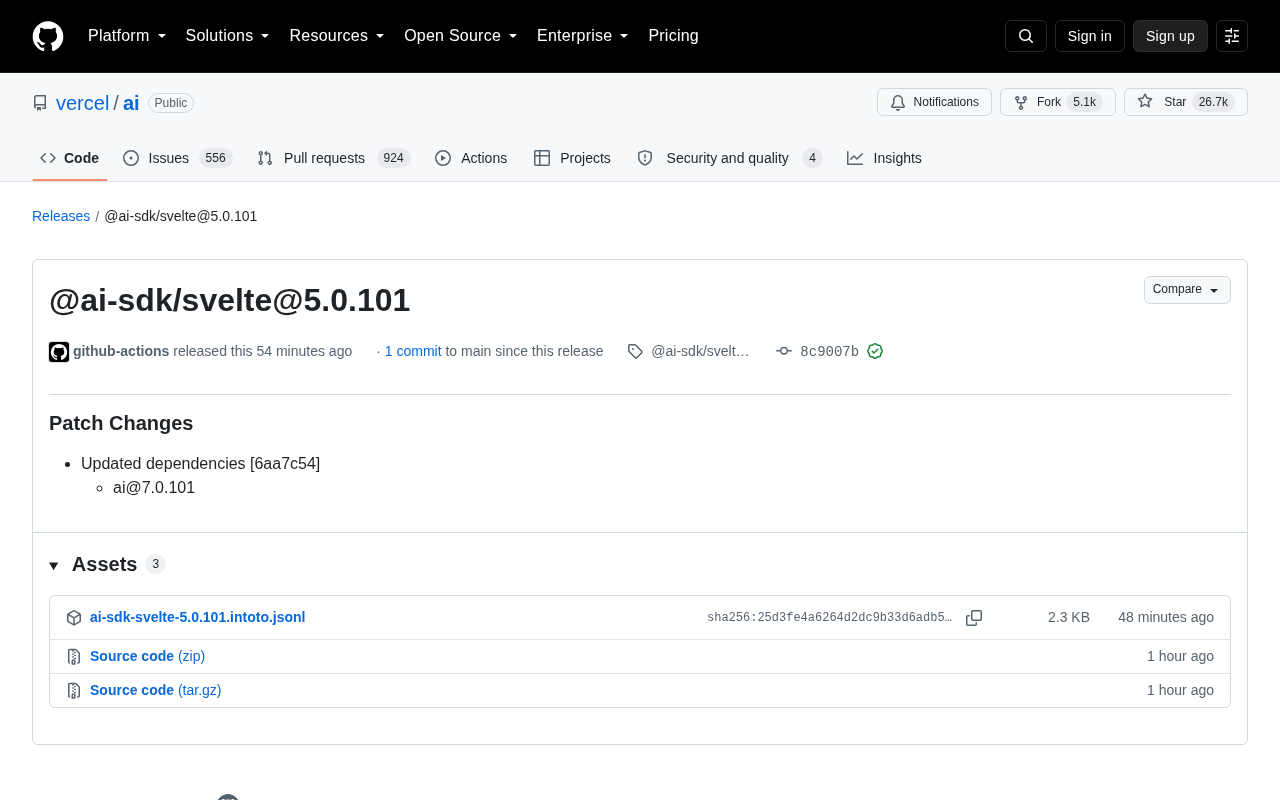
Vercel AI SDK 发布 @ai-sdk/svelte 5.0.101 补丁版本
Vercel AI SDK 发布 @ai-sdk/svelte 5.0.101 补丁版本,同步升级核心依赖至 ai@7.0.101。本文解读此次更新内容、Svelte 适配包的作用以及开发者的升级建议。