VLA预训练中示范质量怎么用?AXIS-Bench基准给出实证答案

系统比较VLA预训练中加权、过滤、条件化三种质量利用策略,条件化最优但存在模型依赖反转。
本文解读论文《What Matters in Quality-Aware VLA Pretraining》,用5000条次优人类示范和24个目标任务,在统一数据和预算下比较加权、过滤、条件化三种质量利用策略。核心结论是approach-aware episode conditioning平均成功率最高,且偏好episode级标签,过滤偏好chunk级标签,但存在模型依赖的反转,不能照搬。微调阶段使用常数标签也能提升成功率。作者发布AXIS-Bench,支持质量标签复算与轨迹重放。真机实验中仿真预训练把成功率从9.6%提升到31.7%,证明质量感知预训练带来实质迁移,但距实用仍有差距。
示范质量不是越多越好:VLA预训练的核心矛盾
机器人领域近年最热的方向之一,是把视觉-语言-动作模型(VLA)当作通用操作策略来预训练,再针对特定任务做微调。但一个长期被回避的问题浮出水面:人类远程操作采集的示范数据质量参差不齐,这些"次优数据"到底该怎么用?
一篇新论文 What Matters in Quality-Aware VLA Pretraining: A Benchmark and Empirical Study 直接切入这个问题。作者用 5,000 条天然次优的人类示范和 24 个目标任务,系统比较了三种质量利用策略——加权(weighting)、过滤(filtering)和条件化(conditioning)——在不同奖励定义和标签粒度下的表现。
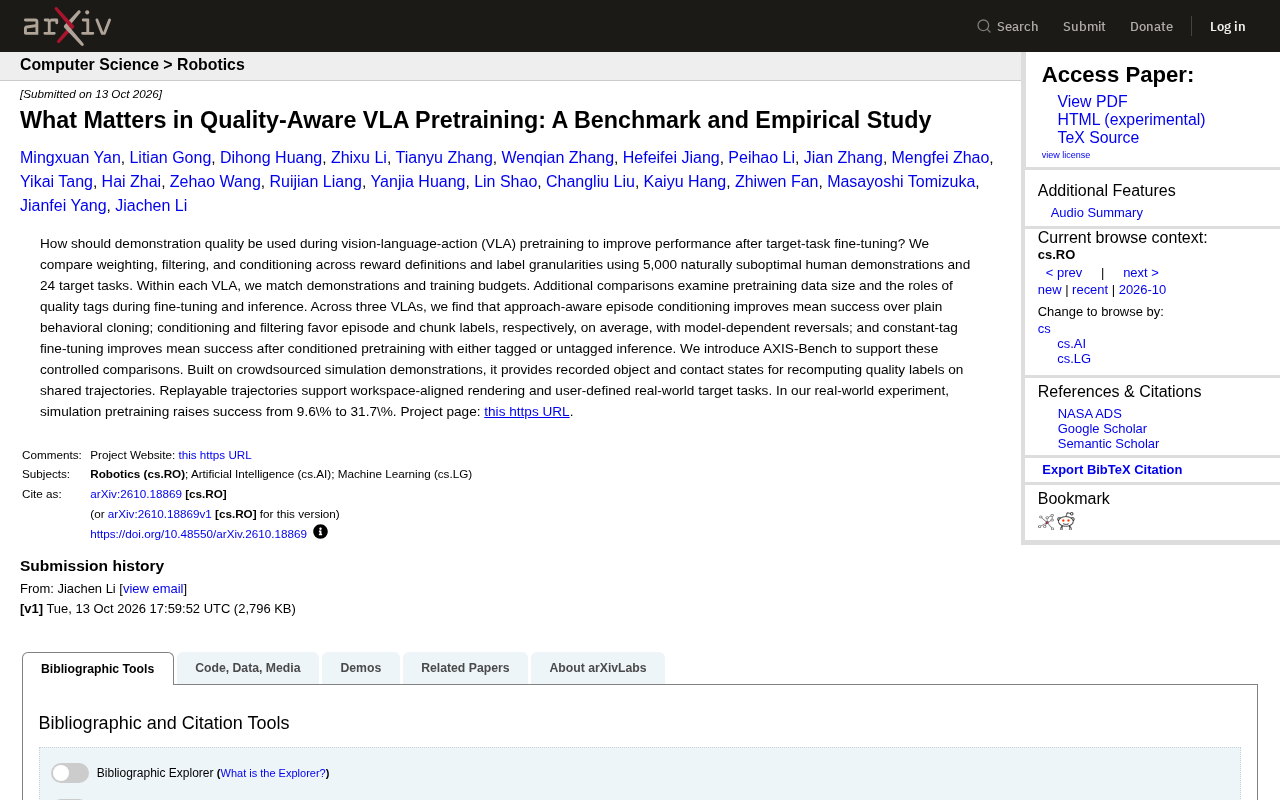
实验控制得相当严格:在同一个 VLA 内部匹配示范数量和训练预算,确保比较的是策略本身而非数据量差异。
VLA(Vision-Language-Action)模型是一类将视觉感知、自然语言指令与机器人动作生成统一到一个策略网络中的模型。典型结构是:视觉编码器处理摄像头画面,语言模型主干(如LLaVA、PaliGemma等)融合文本指令,动作解码头输出末端执行器位姿或关节角序列。预训练阶段通常在大规模人类远程操作示范上做行为克隆,让模型学会“看到什么、听到什么、该出什么动作”的映射;微调阶段再在目标任务的小样本上适配。VLA的价值在于跨任务泛化:一个预训练好的策略可以用自然语言指定新任务,而不必为每个任务单独训练。但这也意味着预训练数据的质量分布直接决定了下游能力上限——这正是本文讨论“次优示范”问题的背景。
三策略对比:条件化胜出,但细节有反转
核心发现可以概括为几点。
条件化(conditioning)整体最优。 跨三个 VLA 模型,"approach-aware episode conditioning"在平均成功率上稳定超过朴素行为克隆(behavioral cloning)。所谓 approach-aware,指的是不仅标注示范"好不好",还编码了它"怎么好"——执行路径的合理性被纳入条件信号。
标签粒度的影响因策略而异。 平均来看,条件化偏好 episode 级标签,过滤偏好 chunk 级标签。但这个规律并非铁律:论文明确提到存在"model-dependent reversals",即换一个模型,偏好可能翻转。这提醒实践者不能照搬结论,需要在自己的模型上验证。
微调阶段的标签策略同样重要。 一个反直觉的结果是:在条件化预训练之后,微调时使用常数标签(constant-tag fine-tuning)能提升平均成功率——而且无论推理时用带标签还是不带标签,这个提升都成立。这意味着质量标签的价值不仅在于训练信号,还可能在微调阶段起到某种正则化或分布对齐的作用。
论文还额外考察了预训练数据规模的影响,以及质量标签在微调和推理两个阶段各自扮演的角色,但摘要未给出这部分的具体数值。
三种质量利用策略的核心区别在于如何把“示范好坏”这一信号喂给模型。加权(weighting)是把质量分数乘到行为克隆损失上,让低质量示范的梯度贡献变小,本质上仍是单一策略,只是样本权重不同。过滤(filtering)是设一个阈值,把低质量示范直接剔除,训练集变小但更干净,问题在于阈值选择和过滤后数据量骤降。条件化(conditioning)则把质量标签作为额外输入拼接到策略的观测里,模型在训练时同时看到“当前示范的质量描述”和动作,推理时可选择是否提供该标签,从而让模型学会根据质量信号调整行为。条件化不改变损失函数,也不丢弃数据,因此在高噪声、大规模示范场景下通常更稳健,代价是需要额外的标签工程和输入设计。
AXIS-Bench:让质量标签可复算、轨迹可重放
为了支撑上述受控比较,作者构建了 AXIS-Bench。这个基准的几个设计值得关注:
- 基于众包仿真示范,提供记录好的物体状态和接触状态;
- 质量标签可复算:因为状态被完整记录,研究者可以在同一条轨迹上用不同奖励定义重新计算质量分数,而不必重新采集数据;
- 轨迹可重放,支持工作空间对齐的渲染;
- 支持用户自定义的真实世界目标任务,打通仿真预训练到真机部署的链路。
这套设计的价值在于可复现性。质量感知预训练的研究此前常因数据、标签、预算三者纠缠而难以横向对比,AXIS-Bench 把变量拆开了。
众包仿真示范指的是通过众包平台招募普通人,在仿真环境中远程操作机械臂完成任务,而非由专家在真机上采集。这种方式成本低、规模大,但操作者水平不一,天然产生大量次优轨迹——这恰好是质量感知预训练研究想要面对的真实数据分布。AXIS-Bench 完整记录每条轨迹中的物体状态和接触状态,意味着质量分数不再依赖采集时的主观评分,而是可以在事后用任意奖励函数重新计算。轨迹重放与工作空间对齐渲染则进一步支持跨轨迹的公平对比:不同操作者的动作空间被映射到同一坐标系,研究者可以在相同初始条件下比较策略行为。这些设计把“数据采集—标签生成—策略训练”三段解耦,使质量感知研究从个案实验走向可复现的受控基准。
真机实验:仿真预训练把成功率从 9.6% 提到 31.7%
论文报告了一个真实世界实验的结果:仅使用仿真预训练,目标任务的执行成功率从 9.6% 提升到 31.7%,翻了超过三倍。
这个数字的意义不在于绝对值多高(31.7% 离实用仍有距离),而在于它量化了"仿真预训练 + 真机微调"这条路线在质量感知条件下的增益幅度。对于正在搭建 VLA 数据管线的团队,这提供了一个可参照的基线。
你可能没注意到,9.6% 的起点意味着没有预训练时策略几乎不可用,而 31.7% 说明质量感知的仿真预训练确实带来了实质性的行为迁移,尽管距离可靠部署还有明显差距。
对实践者的启示
如果把这篇工作浓缩成可操作的结论:
选择质量利用策略时,条件化是默认首选,尤其当你能提供 episode 级的质量或路径标注时。过滤和加权并非无效,但它们对标签粒度的敏感度更高,且效果更依赖模型本身。
微调阶段别丢掉质量标签。常数标签微调这个简单操作就能带来提升,成本极低,值得一试。
跨模型迁移结论要谨慎。论文自己就发现了模型依赖的反转,说明这套方法论需要在自己的模型和数据上做小规模验证,而不是直接套用论文的超参。
项目页面已在 https://axis-bench.github.io/ 公开,代码和基准数据的具体开放情况需进一步确认。
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。