VLCQ:变长编码如何突破INT8量化瓶颈

VLCQ用变长编码替代定点映射,实现免数据、免微调的更高压缩率训练后量化。
VLCQ 是一篇针对深度神经网络训练后量化的论文,核心创新在于放弃传统定点整数编码,改用变长编码来表示量化数值,从而在数值密集区用更精细编码、稀疏区用更短编码,更贴合权重与激活的真实分布。它不需要访问训练数据、也不需要微调模型,属于纯 data-free 的 PTQ 方案。实验覆盖图像分类、分割和目标检测三类任务:per-channel 量化下,VLCQ 相比 FP32 最高达 6 倍压缩、相比 PWLQ 最高 1.7 倍压缩,甚至在某些模型上超越 FP32 精度;优先压缩时可达 12.25 倍压缩且性能下降不超过 4%。per-tensor 下与 DFQ 相当但更灵活。论文未充分讨论变长编码的推理解码开销与硬件友好性。
深度学习模型部署到边缘设备和移动端时,量化几乎是绕不开的环节。在各类量化方案中,训练后量化(Post-training Quantization, PTQ)因为不需要原始训练数据、也不需要重新训练模型,工程落地成本最低,一直备受关注。但现有方法有一个隐含前提:要想保持接近 FP32 的精度,基本得用 INT8 定点整数;而一旦把位宽压到更低,性能就会明显下滑。
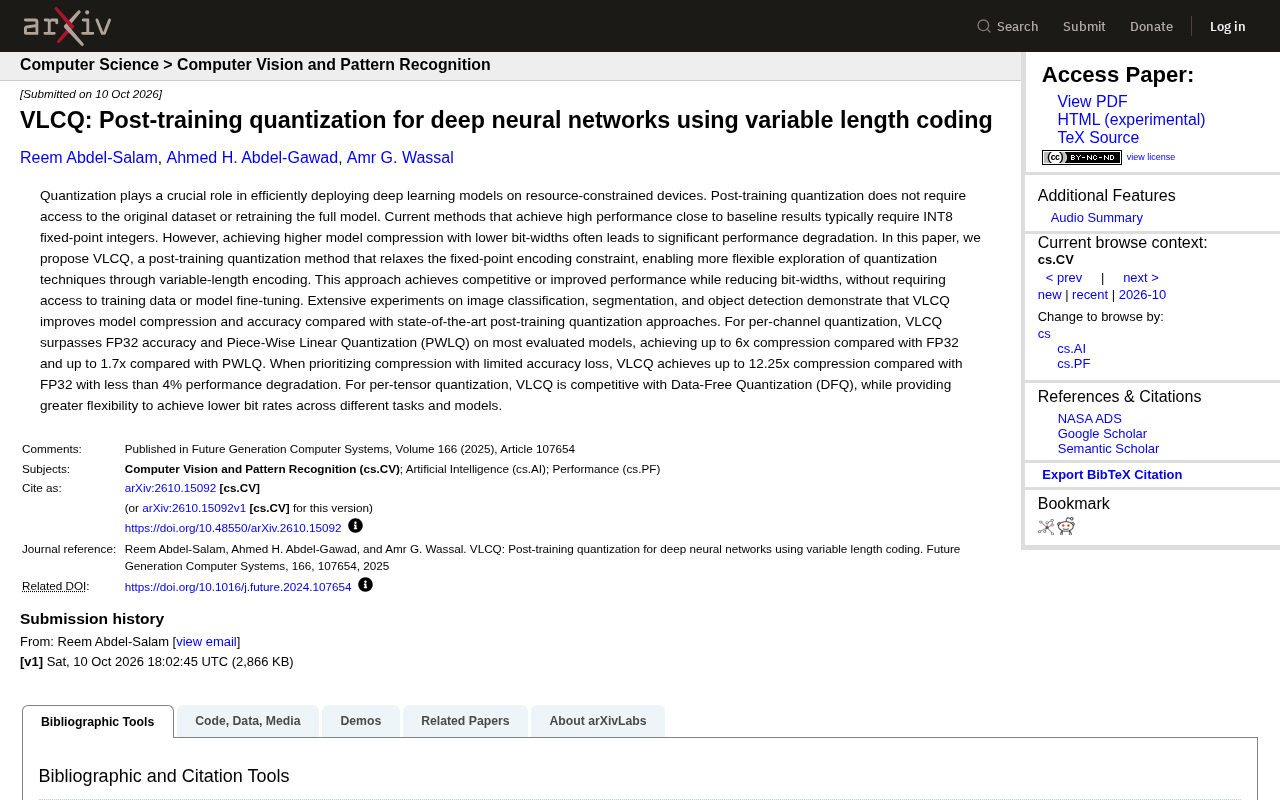
近期一篇题为《VLCQ: Post-training quantization for deep neural networks using variable length coding》的论文提出了一个不同的思路:放弃定点编码约束,改用变长编码来探索量化空间,从而在不访问训练数据、不微调模型的前提下,实现更高压缩率与更好精度的平衡。
定点量化的困境
传统定点量化的逻辑很直接:把浮点权重和激活值映射到固定位宽的整数网格上,比如 INT8 对应 256 个离散等级。位宽越低,可表示的数值等级越少,量化误差就越大。
论文指出,当前能达到接近 baseline 性能的训练后量化方法,通常都依赖 INT8 定点整数。这意味着一个尴尬的局面——想要高精度,就必须接受 8 bit 的存储和计算开销;想要更高压缩率,就得牺牲模型表现。对于参数量动辄上亿的视觉模型,这个矛盾尤为突出。
训练后量化(PTQ)与量化感知训练(QAT)的分野值得展开。QAT 在训练阶段就模拟量化误差,让模型参数主动适应低位宽表示,因此通常能达到更好的精度,但代价是需要完整训练数据、训练管线和数倍于推理的算力。PTQ 则在模型训练完成后直接对权重和激活进行映射,只用一个小的校准集(甚至完全不用数据)来估计数值范围,工程成本低得多。VLCQ 属于完全 data-free 的 PTQ,即连校准数据都不需要,这使它特别适合训练数据因隐私、版权或采集成本而无法获取的场景,例如医疗影像或车载感知模型。
VLCQ 的核心思路:用变长编码替代定点映射
VLCQ 的关键创新在于"放松"了定点编码这一约束。它不再要求所有量化值共享同一套固定位宽,而是通过变长编码(variable-length encoding)来表示量化后的数值。
这个转变的意义在于:数值分布密集的区域可以用更精细的编码表示,稀疏区域则用更短的编码,整体上更贴近权重和激活的真实分布特征。由于不依赖训练数据,VLCQ 依然属于纯训练后量化范畴,不增加数据获取或模型微调的成本。
**变长编码(Variable-Length Coding, VLC)**源自信息论中的熵编码思想,最典型的例子是 Huffman 编码和算术编码:出现频率高的符号分配短码字,频率低的分配长码字,从而让平均码长逼近信源熵。VLCQ 把这一思路迁移到量化数值的表示上——权重和激活的实际分布往往是重尾或近似高斯的,少数区间极其密集、多数区间稀疏,定点量化却对每个等级平均分配比特,造成浪费。变长编码让密集区间用更多码字精细刻画、稀疏区间用更少码字粗略表示,理论上能在相同平均位宽下降低量化误差。代价是码字长度不再对齐,解码需要变长前缀解析或查表,给硬件实现带来额外复杂度。
实验表现:压缩率与精度的双重优势
论文在图像分类、分割和目标检测三类任务上做了大量实验,结论指向两个层面的提升。
Per-channel 量化方面,VLCQ 在多数评估模型上超过了 FP32 精度和 Piece-Wise Linear Quantization(PWLQ)。相比 FP32 实现了最高 6 倍压缩,相比 PWLQ 实现最高 1.7 倍压缩。当把压缩优先级放到更高位置、容忍有限精度损失时,VLCQ 相比 FP32 可达到最高 12.25 倍压缩,性能下降控制在 4% 以内。
Per-tensor 量化方面,VLCQ 与 Data-Free Quantization(DFQ)表现相当,但在不同任务和模型上提供了更大的灵活性,可以更自由地压低 bit rate。
你可能没注意到,VLCQ 在 per-channel 场景下能够超越 FP32 精度这一点颇为反直觉——量化通常会引入误差,但变长编码带来的表示灵活性,可能在某些模型上起到了类似正则化的效果,反而改善了泛化表现。论文没有深入展开这背后的机制,这是一个值得后续研究关注的方向。
Per-channel 与 per-tensor 是量化粒度上的两种基本选择。Per-tensor 量化对整个张量共用一组缩放因子和零点,实现最简单、硬件最友好,但当张量内不同通道的数值范围差异很大时,小范围通道会被大范围通道"挤压",量化误差显著上升。Per-channel 量化则为每个输出通道单独计算缩放参数,精度通常更高,代价是存储和计算时需按通道索引参数,对算子融合和 SIMD 加速不够友好。VLCQ 在 per-channel 场景下收益更明显,说明它更能利用细粒度分布信息;而 per-tensor 下它与 DFQ 打平,也反映出粒度粗时编码灵活性带来的增益会被分布混叠抵消。
对边缘部署的启示
VLCQ 的价值不只在于数字上的压缩率提升。它提供了一个信号:训练后量化的瓶颈未必在于"位宽不够用",而可能在于编码方式过于刚性。定点整数便于硬件加速,但变长编码在存储效率上的优势,为资源极度受限的场景打开了新空间。
当然,变长编码也带来了编解码复杂度的增加,论文未详细讨论实际推理时的硬件友好程度。如果解码开销抵消了存储收益,工程落地的性价比就需要重新评估。
**PWLQ(Piece-Wise Linear Quantization)**是 PTQ 领域较有代表性的对比基线,其思路是把数值域切成若干区间,每个区间用独立的线性映射,本质上是分段逼近非线性分布,仍属于定点框架内的改良。DFQ(Data-Free Quantization)则强调完全脱离数据,通过权重均衡、偏置校正等解析手段缩小量化误差,是 data-free PTQ 的标杆方法。VLCQ 与这两者的区别在于:PWLQ 只是把定点映射做得更细,DFQ 只是把校准做得更巧,都没有跳出"固定码长"这一前提;VLCQ 改的是编码机制本身,因此才能在压缩率上取得数量级式的突破,也正因如此才引入了 PWLQ、DFQ 所没有的变长解码开销问题。
小结
VLCQ 通过引入变长编码,在训练后量化框架内实现了对定点约束的突破。在无需训练数据、无需微调的前提下,它在图像分类、分割、检测任务上展现出优于 PWLQ 和 DFQ 的压缩-精度权衡能力。对于关注模型压缩与边缘部署的研究者和工程师来说,这是一个值得跟踪的方向。
相关推荐

免费跑Claude Code:DeepSeek V3与Gemini API接入指南
教你用一键 Windows 安装器将 Claude Code 的后端切换为 DeepSeek V3、Gemini 或 OpenRouter 免费 API,零成本体验终端 AI 编程助手,附完整配置步骤与局限分析。

JetBrains 推出 ThinkRail:开发者效率新工具
JetBrains 在 Hacker News 上曝光新项目 ThinkRail,引发开发者社区关注。本文梳理已知信息、社区反应及其对开发者工作流的潜在意义。

Gemini 4 Argonne 入门教程:从建站到Agent的实战
Gemini 4 Argonne 完整入门教程:演示在 Google AI Studio 一句话构建卡路里追踪应用、用超长上下文审阅 10 页技术文档、在 Anti-Gravity 作为编程 Agent 开发浏览器游戏,并讲解 API Key 获取、定价与各平台订阅门槛。