vLLM P/D分离:KV传输成本决定收益的计算法则

P/D分离是延迟工程工具而非吞吐优化,KV传输与预填充耗时之比可提前算出。
文章系统拆解了vLLM预填充/解码分离架构的成本账。P/D分离的本质是延迟工程:它让解码实例不再被预填充步骤打断,从而稳定ITL尾部延迟,但vLLM官方明确表示它不提升吞吐量。代价是每个请求的KV缓存必须跨网络从预填充实例搬到解码实例。作者给出每Token KV字节数的计算公式,并以Llama-3.1-8B/70B为例说明GQA如何把缓存压到可接受范围。关键洞察是:传输耗时与预填充耗时的比值与Prompt长度无关,仅由模型形状、链路带宽和预填充吞吐决定,因此可以在采购硬件前算出。文章据此给出决策规则:严格p99 ITL目标、长短Prompt混合、高速互联场景适合分离;短Prompt低并发、离线批处理、慢速网络或小集群则应跳过。最后强调必须用混合负载下的p99 ITL而非平均延迟来验证效果。
为什么P/D分离是一个值得算清楚账的架构选择
把预填充(Prefill)和解码(Decode)拆到不同的引擎实例上运行,是vLLM近年来主推的部署模式之一。但vLLM官方文档对此有一个相当直白的表述:P/D分离可以独立调节首Token延迟(TTFT)和Token间延迟(ITL),也能更可靠地控制ITL的尾部抖动,但"分离式预填充并不会提升吞吐量"。
这意味着P/D分离本质上是一个延迟工程工具,而非吞吐优化手段。你要为此付出的代价是:每个请求的KV缓存都必须通过网络从预填充实例搬运到解码实例。这笔账能不能算得过来,取决于你用什么网络、跑什么模型、面对什么样的请求分布。
好消息是,这个成本是一个可以在采购网卡之前就计算出来的比值。本文基于公开模型配置和明确标注的假设,把这道算术题拆开放大,并给出一条可操作的判断规则。
预填充与解码的硬件性格冲突
理解P/D分离的价值,先要理解两种计算阶段的本质差异。
预填充一次性处理整个Prompt,属于计算密集型负载:大矩阵乘法、高算术强度、GPU张量核心吃满。解码则每步只生成一个Token,属于内存带宽密集型负载:每一步都要读取全部权重和不断增长的KV缓存,才能产出一个Token。
当两者跑在同一个引擎上时,它们会互相干扰。一个长Prompt中途到达,会把一个计算密集的步骤注入到一批都在等待下一Token的序列中间。每个序列都会经历一次ITL尖峰,尖峰时长大致等于这次预填充步骤的耗时。用户的体感就是:只要有人提交大文档,自己的输出流就会卡顿。
分块预填充(Chunked Prefill)是常见的第一层缓解手段:把Prompt切块,与解码步骤交错执行,每次停顿被限制在块大小以内。P/D分离则更彻底:预填充跑在独立实例上,解码实例永远不执行预填充步骤,解码步的节拍变得平稳。vLLM文档明确指出,这种方案比分块预填充更可靠地降低ITL尾部延迟。
分离还带来两个附带好处:两个阶段可以各自采用最合适的并行策略(例如预填充侧用更高的张量并行度来压低TTFT),以及在流量结构变化时独立扩缩两个资源池。
算术强度(Arithmetic Intensity)指一段计算中每读取一字节内存所执行的浮点运算次数,通常以 FLOP/Byte 计量。它是区分计算密集与内存密集负载的核心指标:当算术强度高时,GPU 的计算单元是瓶颈,张量核心可以持续满载;当算术强度低时,内存带宽成为瓶颈,算力再高也只能等待数据搬运。预填充阶段对整段 Prompt 做大矩阵乘法,算术强度可达数百 FLOP/Byte,远高于 GPU 的带宽-算力平衡点,因此是计算密集型;解码阶段每生成一个 Token 都要读取全部模型权重和 KV 缓存,算术强度往往只有个位数,因此是内存带宽密集型。这一差异正是两种阶段需要不同并行策略和硬件配比的根本原因,也是 P/D 分离能够各自优化的物理基础。
KV传输的算术:每Token多少字节
预填充搬到别处之后,产生的KV缓存必须先到达解码实例,第一个Token才能被产出。每Token需要搬运的字节数为:
kv_bytes_per_token = 2 * layers * kv_heads * head_dim * dtype_bytes
系数2对应Key和Value两份。下面是两个开源模型公开config.json中的形状参数:
| 模型 | 层数 | KV头数 | 头维度 | BF16每Token | FP8每Token |
|---|---|---|---|---|---|
| Llama-3.1-8B | 32 | 8 | 128 | 128 KiB | 64 KiB |
| Llama-3.1-70B | 80 | 8 | 128 | 320 KiB | 160 KiB |
这些数字之所以还能接受,关键在于分组查询注意力(GQA)。一个KV头数为64的完整多头注意力70B模型,KV缓存会是这个数字的8倍。
按此计算,70B模型上一个8192 Token的Prompt在BF16下产生2.68 GB的KV缓存——这是单个请求的传输载荷。
分组查询注意力(Grouped Query Attention, GQA)由 Ainslie 等人于 2023 年提出,是介于多头注意力(MHA)与多查询注意力(MQA)之间的折中方案。在标准 MHA 中,每个查询头都有自己独立的 Key 和 Value 头,KV 缓存随头数线性增长;在 MQA 中所有查询头共享一组 KV 头,缓存最小但质量损失明显。GQA 将查询头分成若干组,每组共享一组 KV 头,例如 Llama-3.1-70B 有 64 个查询头但只有 8 个 KV 头,即 8 个查询头共享一组 KV。这样在几乎不损失模型质量的前提下,KV 缓存和注意力计算的内存访问量降到 MHA 的八分之一。对 P/D 分离而言,GQA 直接决定了每 Token 需要跨网络搬运的字节数,是让传输成本变得可以接受的关键模型侧因素。
传输耗时与预填充耗时的比值
原文提供了一个刻意保持精简的计算脚本,方便替换成自己的模型形状、链路速度和实测预填充吞吐。
核心假设需要说清楚:70B稠密模型、4张GPU分担预填充、每GPU有效算力400 TFLOPS、链路跑满线速且不计协议开销。真实预填充吞吐取决于算子实现、张量并行效率和序列长度,务必用自己的实测值替换eff_tflops。
| Prompt Token数 | KV(BF16) | 预填充耗时 | 100GbE | 200Gb | 400Gb |
|---|---|---|---|---|---|
| 2,048 | 0.67 GB | 179 ms | 54 ms (30%) | 27 ms (15%) | 13 ms (7%) |
| 8,192 | 2.68 GB | 717 ms | 215 ms (30%) | 107 ms (15%) | 54 ms (7%) |
| 32,768 | 10.74 GB | 2,867 ms | 859 ms (30%) | 429 ms (15%) | 215 ms (7%) |
注意百分比那一列在每一行都完全相同。这不是巧合:传输量和预填充耗时都与Prompt长度成线性关系,所以比值会收敛为:
transfer / prefill = (kv_bytes_per_token / link_bandwidth) / (2 * params / (gpus * flops))
Prompt长度被约掉了。这带来几个实际推论:
- 可以仅凭硬件做决策。 模型形状、链路带宽、预填充吞吐三个量决定了比值,流量结构不影响。
- 长Prompt实际上比表格显示的更有利。 真实预填充包含一个超线性增长的注意力项,长Prompt的计算耗时相对传输耗时更长。
- 张量并行对传输侧也有帮助。 KV头分布在预填充的多张GPU上,如果每张GPU有自己的网卡通路,聚合带宽随GPU组规模扩展。上文的50 GB/s指的是单条400Gb链路,每GPU独立链路会显著改变结论,值得先检查拓扑再下判断。
- FP8 KV缓存付一次钱拿两份收益。 它同时把并发序列的显存占用和网络上搬运的字节数减半。如果你已经在做KV缓存量化,传输比值会顺带变便宜。
还有一个关于重叠的注意事项:传输未必串行发生在预填充之后。实现上可以在后续层还在计算时就开始搬运前面的层或块,从而隐藏部分成本。上面的数字是全部等待的最坏情况。重叠带来的收益是真实的,但取决于连接器实现和网络条件。
同机预填充对解码的伤害有多大
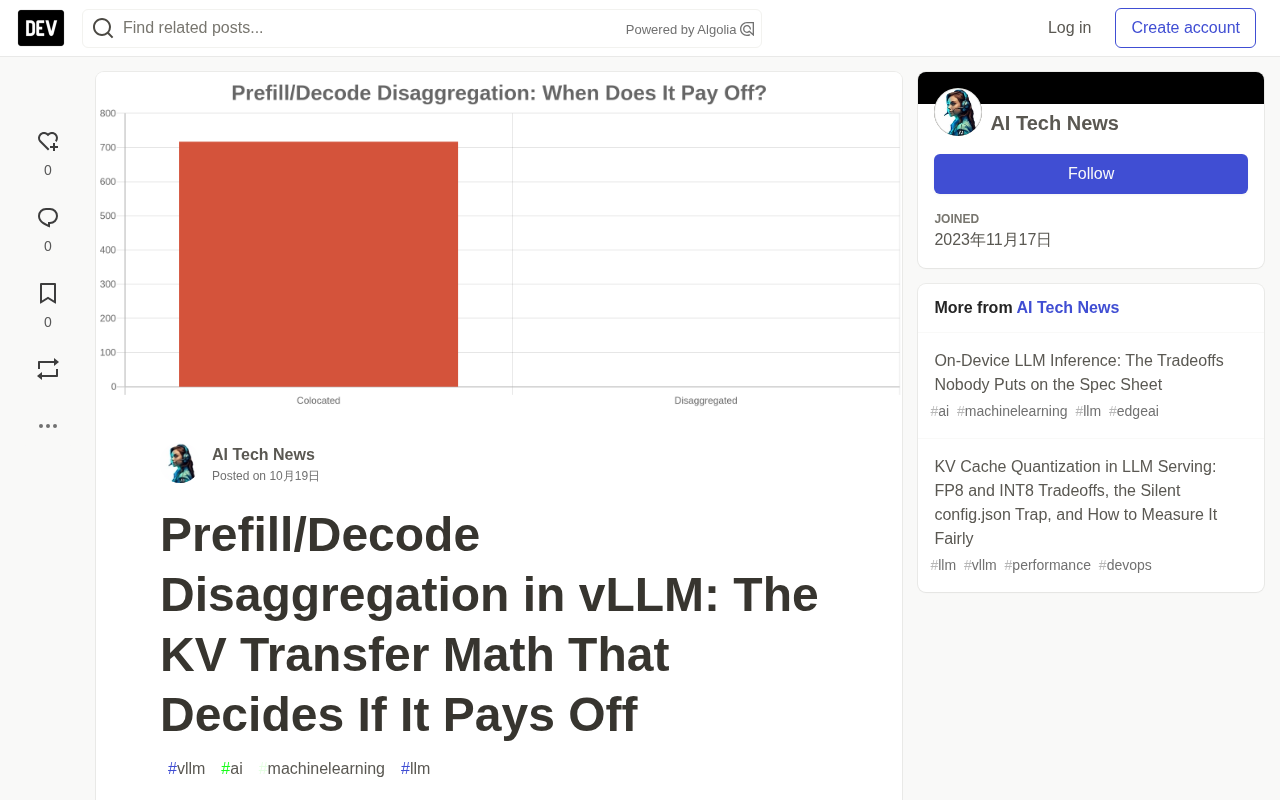
账本的另一边,是你要避免的损失。一个负载中的解码步耗时在几十毫秒量级。而同样假设下,8192 Token的预填充步骤需要717 ms。在这段时间里,解码批次中没有任何序列能前进一步。
分块能缩小停顿(2048 Token块是179 ms,512 Token块是45 ms),但永远无法消除它,而且小块有自己的代价:每个Prompt的步数更多、预填充效率更低、被分块的那个Prompt的TTFT更长。P/D分离在解码侧完全消除了干扰,代价是增加了一次传输步骤——在上表中相当于一次不再阻塞任何人的预填充耗时的4%到30%。
所以真正的比较对象不是"传输成本对比零成本",而是传输成本对比你实际请求结构下同机预填充对p99 ITL的伤害。如果你的负载是短对话轮次,伤害很小,传输是纯开销。如果是长文档、长RAG上下文、或者带大体积工具输出的Agent轨迹,伤害可能主导你的尾部延迟。
在vLLM中如何配置
该功能通过--kv-transfer-config配置,一个JSON字符串用于选择连接器。vLLM文档列出的连接器包括NixlConnector、MooncakeConnector、LMCacheConnectorV1和OffloadingConnector,并标注该功能为实验性、接口可能变化。文档中的NixlConnector示例如下:
vllm serve <model> \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_both","kv_buffer_device":"cuda","kv_connector_extra_config":{"backends":["UCX","GDS"]}}'
具体到每个实例的role取值,以及把Prompt发给预填充实例再转给解码实例的路由器或代理,请查阅你所安装版本的文档。这个接口一直在演进。
演进方向值得关注。vLLM博客近期介绍了推模式的NIXL连接器:传统拉模式下由解码实例向预填充实例请求KV;推模式下预填充实例通过RDMA直接把KV写入解码实例的内存。其目标是移除TTFT关键路径上的三个环节——路由中转、解码侧内存分配、传输建立。这对本文的算术有影响:这些固定开销不在上面的带宽比值里。在小Prompt场景下,每请求的建立开销可能主导纯字节传输时间,所以比值表是开销的下限,不是上限。
NIXL(NVIDIA Inference Xfer Library)是 NVIDIA 开源的推理数据传输库,为点对点 KV 缓存搬运提供统一的抽象层。它本身不实现具体传输,而是通过插件式后端适配不同硬件与协议:UCX 后端面向 InfiniBand 和 RoCE 等 RDMA 网络,支持 GPU 显存直接远程读写;GDS(GPUDirect Storage)后端面向本地 NVMe 存储与 GPU 之间的直接数据通路。NIXL 的价值在于把连接器逻辑与具体互联解耦,使 vLLM 的 P/D 分离部署能在不同集群拓扑上复用同一套接口。理解这一点有助于读懂 --kv-transfer-config 中 backends 字段的含义:它指定的是底层可用的传输通道,选择哪几个后端取决于你的网卡类型、驱动栈以及是否启用了 GPUDirect。
如何测量它是否真的有效
不要用平均延迟或吞吐量来做判断。P/D分离是尾部延迟工具,而且vLLM文档明确说不提升吞吐,吞吐基准会在两个方向上误导你。
正确的做法是:在后台持续注入长Prompt流的同时,测量p50和p99的ITL。原文给出的客户端使用OpenAI兼容的流式接口,记录每个响应相邻数据块之间的时间间隔:
import asyncio, json, time, httpx

async def stream_itl(client, url, model, prompt, max_tokens=256):
    gaps, last = [], None
    body = {"model": model, "prompt": prompt, "max_tokens": max_tokens,
            "stream": True, "temperature": 0}
    async with client.stream("POST", url, json=body, timeout=300) as r:
        async for line in r.aiter_lines():
            if not line.startswith("data: ") or line.endswith("[DONE]"):
                continue
            now = time.perf_counter()
            if last is not None:
                gaps.append(now - last)
            last = now
    return gaps
用一组固定的短请求作为"受害者",另起一个任务以恒定速率注入长Prompt,分别对同机部署和分离部署各跑一遍。报告受害者的p50和p99 ITL,以及长Prompt的TTFT。
保持对比公平的几条规则:
- 两边总GPU数相同。 把8张GPU拆成4预填充4解码,必须和8张同机部署对比,而不是和4张对比。
- 相同的到达过程和相同的Prompt集合,从文件回放,不要现场重新生成。
- 每次运行前用相同方式预热前缀缓存,或者干脆禁用它。 一个热的共享缓存会偏袒后运行的那个配置,在P/D场景下它还会改变实际需要传输的KV量。
- 导出两边的最终引擎配置并做diff。 相同的启动参数不等于相同的运行条件。
- 跑足够久以进入稳态,并报告实际提供的负载,而不只是延迟数字。
什么时候该用,什么时候该跳过
| 场景 | 判断 |
|---|---|
| 严格的p99 ITL目标,Prompt长或突发 | 强候选 |
| 预填充和解码的最优并行策略明显不同 | 强候选 |
| 资源池之间有高速互联(RDMA、每通路200Gb以上) | 算术上有利 |
| 短Prompt、低并发 | 跳过,分块预填充足够 |
| 离线批处理任务,只关心总吞吐 | 跳过,没有吞吐收益 |
| 池间只有100GbE或更慢,且没有FP8 KV | 先算比值,30%开销很难藏 |
| 小集群,拆分后两个池都太小无法有效批处理 | 跳过,利用率损失可能超过收益 |
最后一行值得强调。解码池需要足够的并发序列来填满批次,预填充池需要足够的到达率来保持忙碌。在小集群上拆分可能让两边都处于低利用率状态,而这个成本根本不会出现在传输比值里。
常见问题
P/D分离能提升吞吐吗? 本身不能。vLLM文档明确说明分离式预填充不提升吞吐。它的价值在于TTFT和ITL的独立调节,以及更紧的ITL尾部控制。
需要传输的KV缓存有多大?
每Token用2 * layers * kv_heads * head_dim * dtype_bytes计算。Llama-3.1-70B在BF16下是每Token 320 KiB,8192 Token的Prompt约2.68 GB。FP8 KV减半。
只用分块预填充够吗? 对短Prompt和中等负载往往够。分块把解码停顿限制在块大小内,但并未消除。vLLM文档称分离方案比分块预填充更可靠地控制尾部ITL,代价是KV传输和更复杂的部署。
该选哪个vLLM连接器? 文档列出NixlConnector、MooncakeConnector、LMCacheConnectorV1和OffloadingConnector等多个选项。选择取决于互联和软件栈,且该功能标注为实验性,建议锁定版本并在升级后重新测试。
拉模式和推模式的KV传输有什么区别? 拉模式下解码实例向预填充实例请求KV;推模式下预填充实例通过RDMA直接写入解码内存,vLLM博客称这移除了TTFT关键路径上的路由中转、解码侧分配和传输建立三个环节。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。