VLM-Seek 1.5 10B 本地部署实测:秒级视觉定位能否落地
RTX 5090本地部署VLM-Seek 1.5 10B,秒级实现自然语言驱动的开放词汇视觉定位。
本文记录了在搭载RTX 5090的本地机器上从零部署VLM-Seek 1.5 10B开源视觉大模型的完整过程。部署只需推理代码、模型权重和区域检测器权重三个核心组件,最大难点在于加速推理依赖需严格匹配Blackwell架构,最终确认的可用组合为Python 3.11 + CUDA 12.8 + PyTorch 2.10。实测中,1080P流水线图片和1200×1200图片均在约1.5-1.6秒内完成目标定位,达到秒级响应。与传统固定类别检测器不同,该模型支持自然语言描述目标,并具备当目标不存在时明确返回「找不到」的None机制,避免强行误检。模型约占20GB显存,显存不足时可尝试双卡分层方案,也可直接调用云端API替代本地部署。
开源视觉模型越来越多,但真正能跑到本地、满足实际业务需求的并不多。B站UP主「哈希二金之」用一台搭载 RTX 5090 的机器,从零把 VLM-Seek(视频中读作「VLX-SICK」)1.5 10B 模型部署下来,并用多组真实场景图片做了实测。本文梳理整个部署流程、踩坑经验与实测表现,供想要本地跑开源视觉大模型的开发者参考。
部署前要准备什么
整套部署只需要三样东西:推理代码、模型权重、区域检测器权重。推理代码直接从官方 GitHub 仓库拉取;模型权重和区域检测器权重则可以从国内的魔搭(ModelScope)社区下载,共三个文件,国内下载速度更友好。
环境方面,UP主使用 Conda 创建了一个 Python 3.11 的虚拟环境,再按照官方 requirements.txt 安装依赖。文件准备好后,在推理代码目录新建一个 resources 文件夹,把模型权重与区域检测器权重分别放进去,部署的「骨架」就算搭好了。
最容易踩坑的一步:加速推理依赖
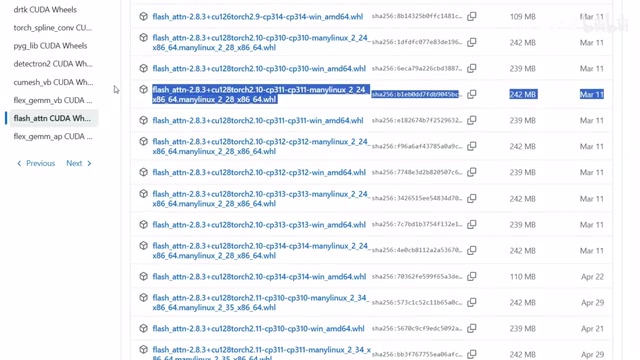
整个流程里最容易报错的,是用于加速推理的 Attention 相关依赖。原因在于硬件架构——这台机器用的是 RTX 5090,属于 Blackwell 架构,CUDA、PyTorch 和对应的编译包版本必须严格匹配。
UP主最终跑通的组合是 Python 3.11 + CUDA 12.8 + PyTorch 2.10,并找到对应的预编译包本地安装。这一步解决之后,剩下的依赖基本按 requirements.txt 正常安装即可。对于使用新架构显卡的用户来说,版本匹配是部署能否成功的关键门槛,盲目按通用教程安装很容易卡在这里。
这里提到的「Attention 相关依赖」主要指 FlashAttention 或类似的高效注意力计算库。这类库通过融合矩阵运算、减少显存读写来大幅加速 Transformer 模型的推理速度,但它们需要在本地针对特定 CUDA 版本重新编译,或使用预编译的 wheel 包。Blackwell 架构(如 RTX 5090 所采用的 GB202 芯片)于 2025 年才正式量产,很多主流教程和预编译包还是针对 Ampere(RTX 30 系)或 Ada Lovelace(RTX 40 系)架构构建的,直接套用旧版本会触发 CUDA kernel 不兼容错误。因此,使用最新架构显卡时,必须从官方或社区找到专门为该架构编译的包,或在匹配的 CUDA 工具链下自行编译,这是整个部署流程中技术门槛最高的环节。
实测表现:秒级定位是否属实
模型装起来只是第一步,真正值得关注的是 10B 视觉模型在本地的运行速度。UP主没有用官方 demo,而是直接拿不同分辨率、不同场景的图片实测。
场景一:快递分拣流水线。 分辨率 1920×1080,指令是「找出离我最近的彩色包裹」,大约 1.5 秒完成定位。
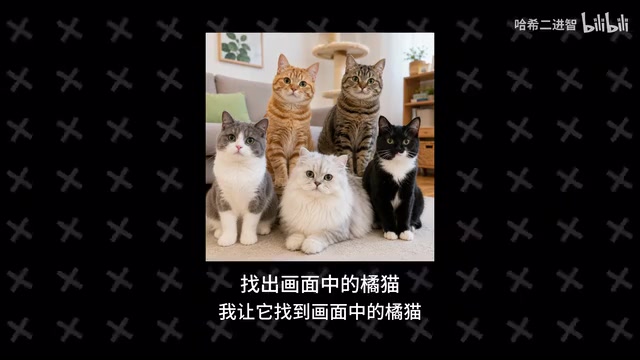
场景二:1200×1200 图片。 指令是「找到画面中的橘猫」,约 1.6 秒返回结果并成功定位目标。
从这几组实测看,在 RTX 5090 这套硬件和当前配置下,VLM-Seek 1.5 10B 的单次视觉定位已经基本做到秒级响应。对于需要快速响应的工业视觉、巡检类场景来说,这个速度具备一定的落地价值。
不止固定类别:自然语言描述目标
比速度更能体现差异化的,是它对自然语言的理解能力。VLM-Seek 和传统固定类别检测器最大的不同,在于你不必提前把目标写死成「汽车」「猫」这类类别,而可以直接用自然语言描述想找的对象。
比如「找到站在设备右侧穿蓝色工服的人」或「找到货架第二层最左边的纸箱」,模型都能理解并定位。这意味着它更像是在传统视觉检测与自然语言之间,增加了一层更灵活的交互方式。
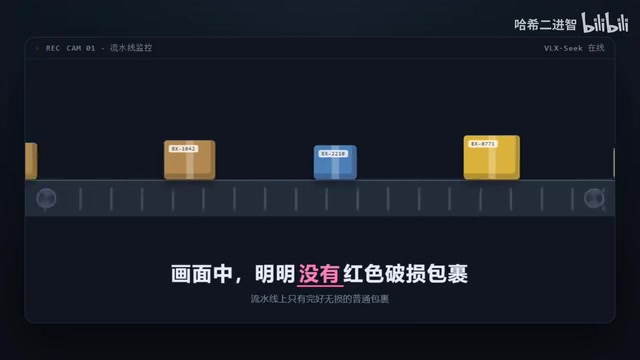
一个关键的健壮性测试是:如果画面里根本不存在目标会怎样?UP主故意让它「找到流水线上的红色破损包裹」,而画面中并没有这类物体。VLM-Seek 设计了 None 机制——当候选区域里没有符合描述的目标时,直接返回「找不到」,而不是强行框一个错误结果。
当然,这并不意味着它完全不会误检或漏检。但对实际业务而言,「找不到就明确说找不到」比强行给出一个错误答案更有价值,也更利于后续流程做判断。
VLM-Seek 所代表的「开放词汇目标检测(Open-Vocabulary Detection)」与传统检测模型有本质区别。YOLO、Faster R-CNN 等经典检测器在训练时固定了类别列表(如 COCO 的 80 类),推理时只能识别训练集中出现过的对象。开放词汇检测器则借助视觉-语言预训练(如 CLIP 思路),将图像区域特征与任意文本描述映射到同一向量空间,从而能够匹配训练时从未见过的类别或复杂自然语言描述。其中的「区域检测器」(Region Proposer)负责先生成候选区域,再由视觉语言模型判断哪个区域与文本描述最匹配。这种两阶段架构使模型能够处理「第二层最左边的纸箱」这类需要空间推理的指令,而非仅做简单的类别匹配。
硬件门槛与部署方式选择
10B 模型对硬件仍有一定要求。实测中模型权重本身约占用 20GB 显存,而推理过程还要为中间计算、候选区域和缓存预留额外空间,因此建议在 20GB 基础上再留出余量。RTX 5090 显存相对充足,部署和推理更稳妥。
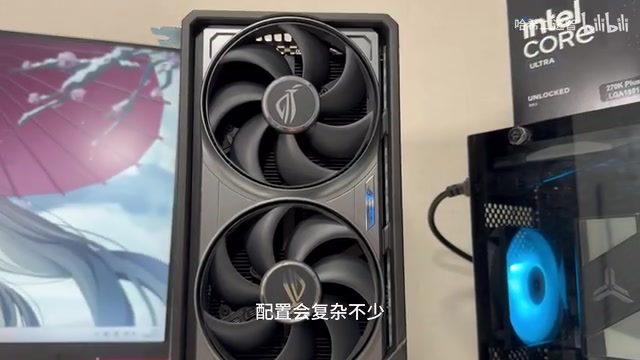
如果只有 16GB 显存怎么办?UP主也尝试过双 4060Ti 16GB 的方案,通过把模型分层放到两张显卡上同样可以运行,但需要对原始推理代码做调整,配置会复杂不少。
本地部署也不是唯一选择。如果只想快速把 VLM-Seek 接入自己的网页 Agent、RPA 或视觉应用,又不想维护整套 GPU 环境,可以直接调用公有云 API;而对于企业内部数据、工业现场或数据安全要求较高的业务,则更适合私有化部署。
小结
从这次从零部署的实践看,有三点值得记住:
- 可自部署:10B 级开源视觉模型确实能在本地跑起来,门槛主要集中在显卡架构与依赖版本匹配上。
- 秒级响应:在 RTX 5090 环境下,多组视觉定位任务已能做到秒级返回。
- 自然语言驱动:支持用自然语言描述目标,无需把需求提前固化成固定类别,并带有「找不到就说找不到」的 None 机制。
对于想尝试的开发者,可以直接去官方 GitHub 查看完整部署命令与环境版本;不想折腾环境的,也可以先用在线体验或 API 跑自己的图片看效果。