Voice Agent三明治架构实战:2000行代码构建实时AI语音智能体

用三明治架构与强推理模型,2000行代码实现实时AI语音智能体。
文章拆解了B站一场技术分享中的Voice Agent实战方案:在三种主流架构中,项目放弃原生实时Speech-to-Speech路线,选择经典的STT+LLM+TTS三明治架构。原因是当前多模态大模型普遍只支持多模态输入、输出仍为文本,且原生语音模型在Agent基准测试上得分偏低,难以承担工具调用与多步推理。方案的核心取舍是:用DeepSeek、Opus、GPT-5.x、智谱等Agent与Coding得分高的模型保证智能体能力,用工程手段解决由此带来的延迟问题。文章还给出选型建议:模块解耦、代码量可控是三明治架构的优势,但对流式与并发工程能力要求较高。
Voice Agent三明治架构实战:2000行代码构建实时AI语音智能体
B站近期一场技术分享完整拆解了基于Voice Agent的AI语音智能体开发方案,用不到2000行代码实现了一个可实时对话的智能体项目。该方案没有选择市面流行的Speech-to-Speech端到端路线,而是回归经典的"三明治架构",并在延迟控制上做了针对性优化。
三种主流语音智能体架构对比
从工程实现角度,所有语音智能体的底层架构可归结为三种路线。
三明治架构由STT(语音转文字)+ 大语言推理模型 + TTS(文字转语音)串联而成,推理模型像夹心一样被夹在前后两个语音模块之间,结构清晰。分享者本次项目正是采用这一路线。
原生实时Speech-to-Speech架构要求模型同时具备实时多模态输入输出能力——输入支持语音、图片、文字、视频,输出也必须是语音在内的多模态。目前主流大模型中满足这一要求的"几乎没有"。
混合级联架构则试图兼顾前两者的特点,将三明治结构与实时推理结合。
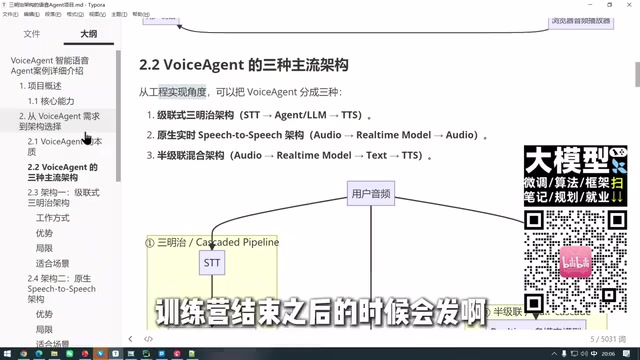
STT、TTS与端到端延迟是理解这三种架构的前置概念。STT(Speech-to-Text)负责将用户语音转写为文本,主流方案包括Whisper系列、FunASR等;TTS(Text-to-Speech)负责把模型生成的文本合成为语音,近年来基于扩散模型和神经编解码器的方案(如CosyVoice、Fish Speech)已能做到接近真人的自然度。所谓"端到端延迟",指从用户说完最后一个字,到智能体第一段语音开始播放之间的时间,而非整段回复的总耗时。它由四级串联构成:STT识别耗时、LLM首Token生成耗时、TTS首包合成耗时,以及各级之间的网络与排队开销。三明治架构之所以延迟压力大,正是因为这三段耗时是相加关系,任一级抖动都会直接抬高整体延迟,因此流水线并行、流式输出和首包优先策略成为工程优化的核心。
实时多模态的现实困境
一个容易被忽视的技术细节:市面上不少多模态大模型(如智谱系列、通义千问广告系列、GPT系列)支持多模态输入,但输出并不支持多模态。据分享者分析,语音智能体最关键的两个指标是实时性与延迟,合格产品的端到端延迟应在0.2秒以内,让人类无法感知。
采用Speech-to-Speech架构时,用户能明显感受到延迟——因为模型输出的是文本,还需要额外一级级联转换才能变成语音。这就解释了为什么即便找到支持多模态输入输出的模型,直接用于语音智能体仍不理想。
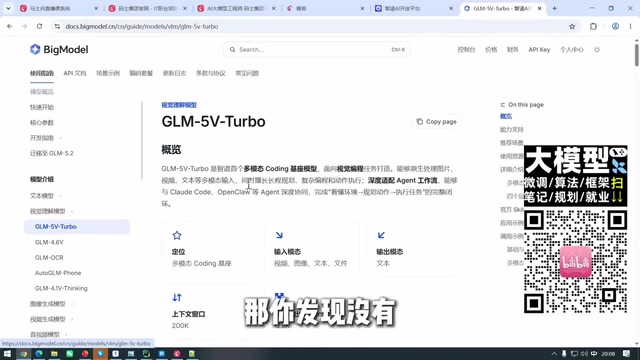
输入多模态与输出多模态是两个常被混淆的能力维度。输入多模态指模型能接收文本、图像、音频、视频等多种形式的prompt;输出多模态则要求模型能直接生成音频波形或图像token,而不只是文本。绝大多数所谓"多模态大模型"只做到了前者——它们把语音先转成文本再理解,回答时仍以文本形式吐出。对语音智能体而言,这意味着链路中必须额外插入一个TTS模块,多出一级转换开销,延迟自然上升。真正原生支持语音输出的模型(如GPT-4o的实时语音模式)采用的是语音token直接建模的方式,跳过了文本中间态,但这类模型通常闭源、难以私有化部署,且在工具调用等复杂任务上表现不如纯文本推理模型,这正是当前工程选型的两难所在。
智能体能力才是核心竞争力
语音只是外壳,真正的难点在于智能体本身的能力:循环迭代、用户意图识别、工具调用、Skill调用、上下文管理。而当前原生实时多模态模型在智能体基准测试上的得分普遍偏低。
分享者特别强调评估大模型时最该看两个指标:
- Agent(智能体)能力得分:反映模型在工具调用、多步推理等任务上的准确性
- Coding能力得分:反映代码生成与理解水平
据分享者介绍,近期DeepSeek广告正式版本、Kimi K3、智谱最新模型在国外知名测试平台上的Agent与Coding得分,已非常接近OpenAI GPT-5.5/5.6系列以及Anthropic Opus 4.8等模型的水平。这意味着国内开发者如今有更多高质量推理模型可以选择。
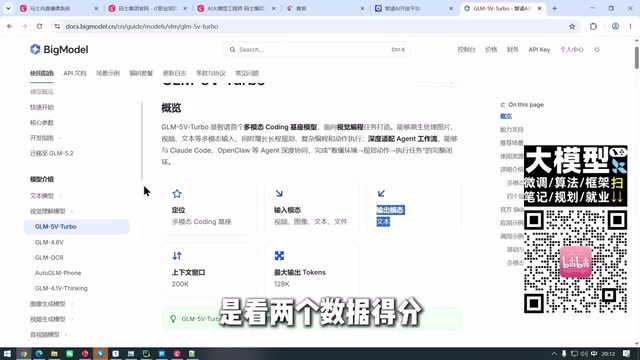
Agent能力与Coding能力之所以被单独拎出来作为评估指标,是因为它们高度相关于模型的"执行力"。Agent能力通常通过工具调用准确率、多步任务完成率、指令遵循度等维度衡量,典型基准包括BFCL、τ-bench、GAIA等;Coding能力则通过代码生成与修复类基准(如SWE-bench、LiveCodeBench)衡量。二者共同反映模型在真实生产任务中"能否正确调用外部接口、能否维持多轮状态、能否生成可执行结果"。语音智能体即便语音链路做得再顺滑,如果模型调不动工具、记不住上下文,交互体验依然会崩塌。因此选型时应优先看这两项得分,而非只看通用问答或翻译类榜单——后者与智能体实际表现的相关性远低于直觉。
三明治架构的工程破局
矛盾点很明确:Agent能力强的模型对语音输入输出支持不佳;而全模态语音模型在Agent基准测试上得分非常低。
分享者的解法是:在强推理模型前面加上STT、后面接上TTS,组成三明治结构。核心推理模型选用DeepSeek正式版、Opus 4.8、GPT-5.5/5.6或智谱最新模型等高Agent得分模型,从而在保证智能体能力的同时兼顾语音交互。
架构带来的代价是实时性损失,用户能感受到延迟。项目的关键突破就在于解决了这个延迟问题——这正是该实战项目的技术亮点所在。
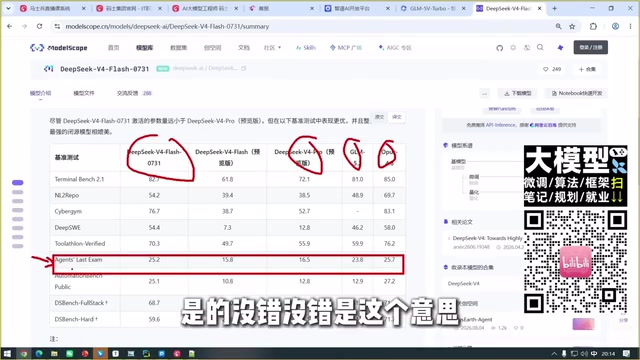
流式处理与断句检测(VAD)是三明治架构压低延迟的两项关键工程手段。流式处理要求STT、LLM、TTS三段全部以增量方式工作:STT边听边出中间结果,LLM一边收文本一边吐Token,TTS则不等整句完成就合成首段音频并立即下发。VAD(Voice Activity Detection)用于判断用户是否说完,直接决定"何时切断录音、何时触发推理",其灵敏度设置是延迟与误打断之间的权衡。此外还需引入打断机制:用户中途插话时,系统必须立即停止当前TTS播放并清空后续推理队列,否则会产生"自顾自说话"的糟糕体验。这些机制叠加起来,才能把原本相加的多段耗时压缩进接近0.2秒的可感知阈值内,也是该项目约2000行代码中最吃工程经验的部分。
适用场景与选型建议
对于希望快速搭建AI语音智能体的开发者,三明治架构的优势在于:模块解耦,STT、LLM、TTS可独立替换;智能体能力上限由所选中推理模型决定;工程实现简单,代码量可控。
需要注意的是,该路线对延迟工程优化要求较高,适合有一定并发与流式处理经验的团队。若追求极致低延迟且对智能体复杂度要求不高,可评估原生实时多模态方案;若需要复杂工具调用与多步推理,三明治架构配合强推理模型仍是当前更务实的选择。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。