VoxCPM2:无Tokenizer语音合成,多语言与克隆新突破

OpenBMB发布无Tokenizer架构TTS项目VoxCPM2,GitHub星标近4万,覆盖多语言生成、声音设计与高保真克隆。
OpenBMB团队开源的VoxCPM2在GitHub收获近4万星标,核心创新是去除传统TTS管线中的文本分词器与声学分词器,让模型在连续表示空间中直接完成文本到语音的映射。这一架构简化了推理链路、降低了多语言扩展的词表维护成本,并支撑起多语言语音生成、文本描述驱动的声音设计和高保真克隆三类能力。社区热度反映出开源TTS在多语言自然度与克隆相似度上的需求缺口。但项目目前以能力描述为主,缺少评测数据,无Tokenizer架构的实际推理效率与克隆客观指标仍需技术报告或社区实测验证。
开源TTS领域又迎来一个重量级项目。OpenBMB团队发布的VoxCPM2在GitHub上已收获近4万星标,其核心卖点——无Tokenizer架构——正在挑战传统语音合成管线的设计范式。
告别Tokenizer:VoxCPM2的架构转向
传统TTS系统通常依赖文本分词器和声学分词器(如离散codec)作为中间表示,再通过声码器重建波形。这种多阶段管线虽然成熟,但每一层都会引入信息损失,且分词器的设计往往与语言强绑定。
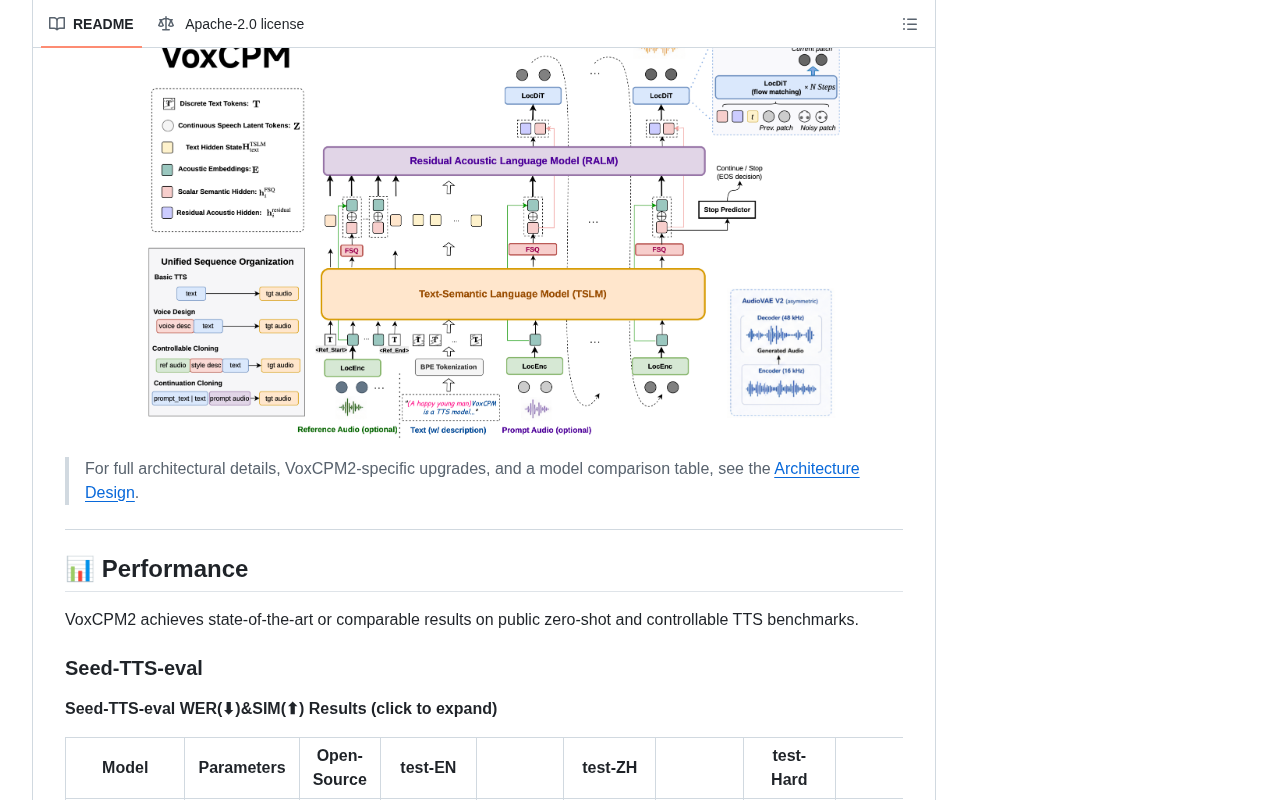
VoxCPM2选择了一条更直接的路径:去掉Tokenizer环节,让模型在连续表示空间中完成从文本到语音的映射。这一设计对多语言场景尤为友好——不需要为每种语言维护独立的分词词表,语言扩展的成本大幅降低。项目描述中强调的"Multilingual Speech Generation"正是这一架构优势的直接体现。
从工程角度看,无Tokenizer意味着推理链路更短、部署组件更少,这对希望快速集成TTS能力的开发者来说是一个实际利好。
声学分词器(discrete codec) 是传统TTS管线中的关键组件,其作用是将连续的语音波形压缩为离散的token序列,常见实现包括SoundStream、EnCodec等。这类模型通过残差矢量量化(RVQ)把音频逐层离散化,使语言模型可以像处理文本token一样处理语音。然而,量化过程本身会丢失细节信息(如高频泛音和微妙的韵律变化),且codec的训练数据分布会限制其泛化能力。VoxCPM2去掉这一环节,意味着模型需要直接在连续声学空间中建模,通常依赖扩散模型或流匹配(flow matching)等连续生成范式,这也解释了为何其推理链路能够更短。
无Tokenizer架构的核心挑战在于对齐:传统管线中文本与声学token的对应关系相对明确,而连续空间中需要模型自行学习文本到波形的映射。这类方案通常采用端到端的自回归或非自回归生成框架,配合预训练的文本编码器与声学解码器。其优势是减少信息瓶颈,但代价是对训练数据规模和质量的依赖更高。对于多语言场景,连续空间表示天然规避了词表膨胀问题,这也是VoxCPM2强调多语言能力的架构基础。
三大能力拆解:生成、设计与克隆
VoxCPM2的定位覆盖了语音合成的三个典型使用场景。
多语言语音生成是基础能力。去掉分词器后,模型对不同语言的文本输入具有更统一的处理方式,跨语言切换时的自然度衰减问题有望得到缓解。
创意声音设计(Creative Voice Design) 指向的是"描述即生成"的交互方式——用户通过文本描述音色特征,模型直接产出符合要求的语音。这类能力在游戏配音、有声内容制作中需求明确。
高保真克隆(True-to-Life Cloning) 则是当前TTS竞争最激烈的赛道。项目用"true-to-life"来修饰克隆效果,暗示其在音色相似度和韵律自然度上做了针对性优化。
零样本语音克隆(zero-shot voice cloning) 是当前TTS评测的核心指标之一,通常指模型仅凭几秒到几十秒的参考音频,即可合成目标说话人音色的新语音,无需针对该说话人进行微调。其技术基础一般包括说话人编码器(提取音色嵌入)和韵律迁移模块。业界常用的客观指标包括说话人相似度(如SECS,基于说话人验证模型计算嵌入余弦相似度)和词错误率(WER,衡量合成语音的可懂度)。VoxCPM2使用的“true-to-life”属于主观描述,实际效果需参考上述指标。
Creative Voice Design 依赖的是文本到音色的跨模态对齐能力,通常通过在训练中引入音色描述文本与音频的配对数据来实现。这类能力与语音克隆的区别在于:克隆以参考音频为条件,而声音设计以自然语言描述为条件,对模型语义理解与音色属性解耦的要求更高。
社区热度说明了什么
近4万星标、4500余次fork、单日新增144星——这组数据在GitHub的TTS类项目中属于头部水平。Python技术栈降低了使用门槛,而OpenBMB作为清华系开源团队,在模型开源和社区运营上有成熟经验。
热度背后是真实的需求缺口:现有开源TTS方案在中文等多语言场景下的自然度、克隆相似度仍难令人满意,而商业API又存在成本和数据隐私顾虑。VoxCPM2的出现恰好填补了这一空档。
值得关注的几个问题
项目当前披露的信息以能力描述为主,缺少具体的评测数据。无Tokenizer架构在推理效率上是否真的优于传统方案、克隆效果的客观指标如何、多语言覆盖的具体语种列表——这些都需要等待技术报告或社区实测来验证。
对于考虑采用的团队,建议先在目标语言和音色场景下做小规模对比测试,重点关注长文本合成的稳定性与克隆音色的跨语句一致性。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。