VTF900:900人可见光-热红外人脸识别基准发布

VTF900将跨光谱人脸识别基准注册库扩至900人,揭示小规模AUC无法代表部署性能。
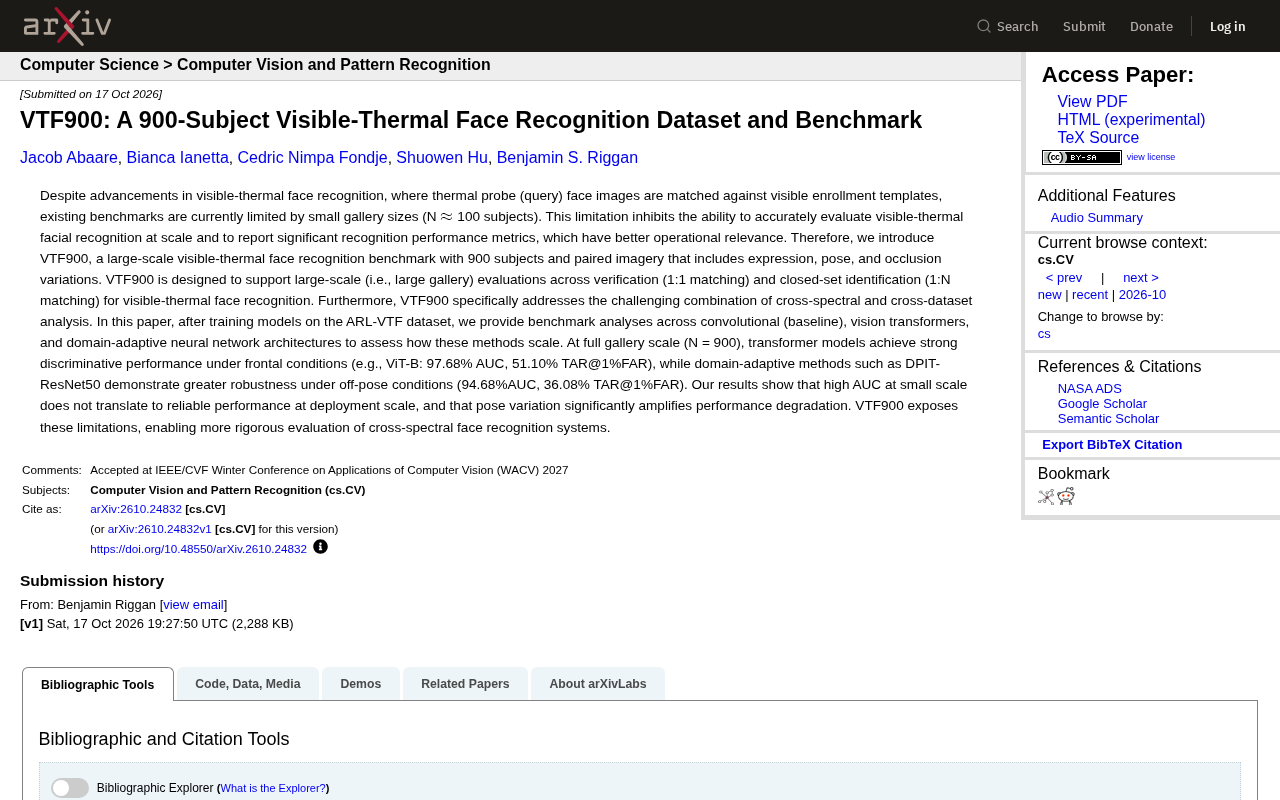
VTF900数据集将可见光-热红外人脸识别的评测注册库从约100人提升至900人,支持1:1验证与1:N闭集识别的大规模评测,并叠加跨光谱与跨数据集的组合挑战。研究者在ARL-VTF上训练卷积网络、视觉Transformer和域自适应模型,在VTF900上评测。结果显示,正面条件下ViT-B表现最佳(97.68%AUC、51.10%TAR@1%FAR),非正面姿态下DPIT-ResNet50更稳健(94.68%AUC、36.08%TAR@1%FAR)。核心结论是小规模下的高AUC不能转化为部署规模下的可靠性能,姿态变化会显著放大性能衰减,以往基于百人级注册库的模型排名在900人规模下可能实质性重排。
跨光谱人脸识别长期受限于评测数据集规模过小——多数基准的注册库(gallery)仅约100人,这让「小规模高精度」与「真实部署表现」之间横亘着一道难以量化的鸿沟。新发布的VTF900数据集把这一数字推到900人,并系统性揭示了规模化评测下不同模型架构的真实差异。
为什么需要更大规模的跨光谱基准
可见光-热红外人脸识别的典型场景是:以热红外图像作为查询(probe),与可见光注册模板进行比对。这一设定在夜间安防、无光照条件身份核验中具有明确价值,但现有基准的注册库规模(N ≈ 100 subjects)严重制约了评测的可信度。
小规模注册库带来的问题不只是统计功效不足。当候选集只有百人量级时,模型之间的差距容易被压缩,排名靠前的方案在实际部署中未必保持优势。VTF900的作者明确指出,这一限制使得「在大规模下准确评估可见光-热红外人脸识别、并报告具有运营相关性的性能指标」变得困难。VTF900因此被设计为支持验证任务(1:1匹配)与闭集识别任务(1:N匹配)的大规模评测,并特别针对跨光谱与跨数据集分析的组合挑战。
跨光谱人脸识别中的“光谱”指成像波段。可见光(VIS)相机捕获400–700 nm的反射光,依赖环境照明;热红外(LWIR,通常8–14 μm)相机捕获人体自发辐射,不依赖光照。两者成像机理不同,同一身份在两种模态下的纹理、对比度分布差异显著,导致在可见光上训练的模型直接用于热红外图像时性能骤降。跨光谱识别的核心挑战是学习模态不变的身份表征,常见手段包括模态对齐损失、生成式跨模态转换和域自适应。
数据集构成与测试设计
VTF900包含900名受试者的配对影像,覆盖表情、姿态与遮挡变化。这些变化维度并非随意选取——姿态和遮挡正是跨光谱识别在实际场景中最常见的失效来源。
在实验设计上,研究者在ARL-VTF数据集上训练模型,随后在VTF900上开展基准分析,覆盖卷积网络(基线)、视觉Transformer以及域自适应神经网络架构。这种「在A数据集训练、在B数据集大规模评测」的跨数据集设定,比同源同分布的评测更接近部署现实。
ARL-VTF是美国陆军研究实验室(ARL)发布的可见光-热红外人脸数据集,是跨光谱识别领域常用的训练与评测资源,但其注册库规模同样在百人量级。VTF900的实验采用“在ARL-VTF上训练、在VTF900上评测”的跨数据集协议,目的是检验模型对未见过受试者和不同采集条件的泛化能力。这种设定比在同一数据集内划分训练/测试更严格,因为两套数据在传感器、环境与人群分布上存在差异,能更真实地反映部署时的域偏移问题。
关键发现:小规模AUC不等于部署可用性
全库规模(N=900)下的结果呈现出清晰的架构分化。正面条件下,Transformer类模型表现突出,ViT-B达到97.68%的AUC和51.10%的TAR@1%FAR。但在非正面姿态下,域自适应方法展现出更强韧性,DPIT-ResNet50取得94.68%的AUC与36.08%的TAR@1%FAR。
更值得关注的是作者的结论性判断:小规模下的高AUC并不能转化为部署规模下的可靠性能,而姿态变化会显著放大性能衰减。这意味着以往基于百人级注册库得出的模型排名,在900人规模下可能发生实质性重排。TAR@1%FAR这类指标在51.10%与36.08%之间的差距,对应到真实门禁或布控系统中就是可用与不可用的区别。
AUC(Area Under the ROC Curve)衡量的是在所有“同人/异人”比对对中,模型将同人对的相似度排在异人对之前的概率,取值0–1,越接近1越好。它刻画的是全局排序能力,与具体阈值无关。TAR@1%FAR则是在误接受率(FAR)固定为1%时对应的真实接受率(TAR),直接对应“系统在可接受的误报水平下能认出多少比例的目标”,更贴近门禁、布控等运营指标。二者关注点不同:AUC高说明整体区分度好,但TAR@1%FAR低可能意味着在严格误报约束下可用性不足,这正是文中强调小规模AUC不能代表部署表现的原因之一。
对跨光谱识别研究的实际意义
VTF900的价值不在于刷新某个榜单数字,而在于提供了一个能暴露失效模式的压力测试环境。它把「跨光谱」与「跨数据集」两个难点叠加,同时把注册库规模提升近一个数量级,让研究者能够观察到性能随规模变化的衰减曲线。
对工程实践而言,这一基准提示选型逻辑需要调整:正面场景可优先考虑Transformer架构,而姿态变化频繁的开放环境则应关注域自适应方案。对学术研究而言,900人规模的公开基准填补了跨光谱识别在大规模评测上的空白,后续方法的比较有了更接近运营指标的参照系。
数据集的完整基准分析已在论文中给出,涵盖三类架构在全库规模下的验证与识别结果,为跨光谱人脸识别系统的严谨评估提供了新的基础设施。
相关推荐

花旗14000名工程师用Devin,技术外包账单砍掉30%
花旗集团14000名工程师使用AI编程智能体Devin,一年内将技术供应商账单削减30%,产品发布提速30-40%。但30%仅限单一成本项,摩根大通同期表示AI收益尚未体现在财报中,揭示企业AI落地的真实分化。

AI写代码,程序员要失业?Devin自主编程真相
Devin等自主AI编程代理正改变软件开发:从Copilot辅助编码到全自动工程代理,程序员角色从写代码转向系统设计与监督。本文分析AI编程对就业、代码安全、初级开发者培养的影响,以及效率悖论下程序员需求的真实走向。

AGENTS.md 实战指南:让编程 Agent 真正好用
AGENTS.md 和 CLAUDE.md 能显著提升编程 Agent 表现,但研究发现用错反而让成本上升 20%。本文详解该写什么、该删什么、200 行与 32KB 的硬边界、Monorepo 嵌套规则及安全提醒。