外部LLM文档可逆脱敏:开源双语基准与引擎
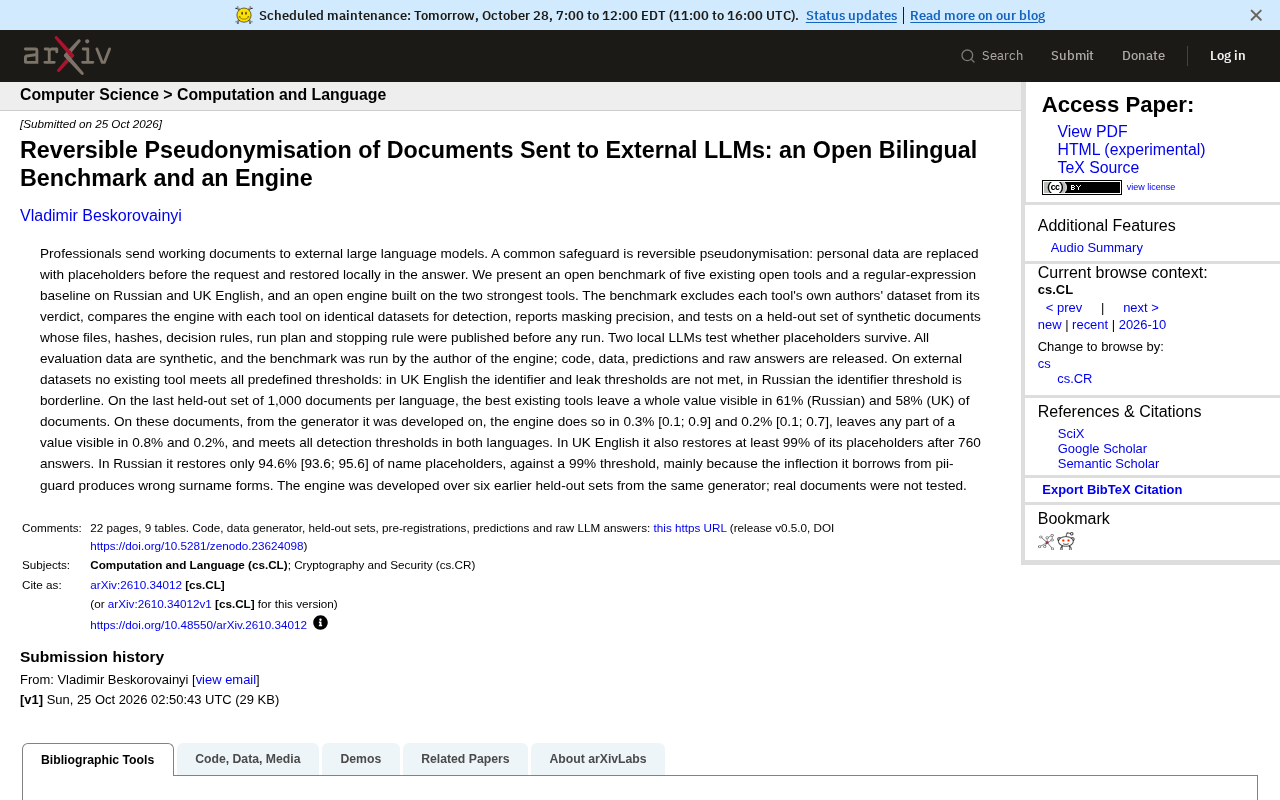
新研究构建开源双语基准,评估现有可逆脱敏工具并开发新引擎,显著降低泄露但俄语姓名还原仍需优化。
该研究针对将工作文档发送给外部LLM时的个人数据泄露风险,构建了一个开源双语(俄语和英式英语)基准,评估了五个现有开源工具和一个正则表达式基线。基准采用合成数据,排除工具作者自身数据集以避免偏见,并预先公布留出集规则以确保可复现性。结果显示,现有工具均未满足所有预定义阈值,最佳工具在61%(俄语)和58%(英式英语)的文档中至少泄露一个完整值。基于两个最强工具构建的新引擎将完整值可见比例降至0.3%和0.2%,并满足所有检测阈值;英式英语中占位符还原率超99%,但俄语姓名还原率仅94.6%,主要受词形变化规则缺陷影响。研究提供了首个开源双语基准和透明评估框架,但引擎尚未在真实文档上测试。
为什么需要可逆脱敏?
将工作文档发送给外部大语言模型时,个人数据泄露是首要风险。可逆脱敏(reversible pseudonymisation)是一种常见防护手段:在请求发出前,用占位符替换文档中的个人数据,待模型返回答案后,再在本地将占位符还原为原始信息。这一流程既保护了隐私,又不影响LLM对文档内容的理解和回答。
然而,现有开源工具能否可靠地完成这一任务?一项新研究给出了答案:作者构建了一个开源双语基准,评估了五个现有开源工具和一个正则表达式基线,并基于其中最强的两个工具开发了一个开源引擎。
可逆脱敏与不可逆脱敏、假名化的区别
可逆脱敏的核心在于“可还原”:它用占位符替换敏感信息,但保留一种映射关系,使得模型输出可以恢复原文。与之相对,不可逆脱敏(如哈希、泛化、噪声注入)会永久破坏原始值,无法还原;假名化(pseudonymisation)通常指用虚构标识符(如“张三”替换为“用户A”)替代真实值,但假名与真实值之间的映射表需要被安全保存,本质上与可逆脱敏同属一类,但假名化更强调替换后的值看起来像真实数据。可逆脱敏的工程挑战在于:既要让LLM理解替换后的文本(占位符不能破坏语义),又要保证映射表的安全存储,并在模型回答中准确识别和还原占位符,避免误替换或遗漏。
占位符设计对LLM理解的影响
占位符的形态直接影响LLM对文档的理解。如果占位符过于抽象(如“<PERSON_1>”),模型可能难以将其与上下文关联;如果过于具体(如保留部分真实字符),则可能泄露信息。常见做法是使用语义中性的占位符(如“[NAME]”“[EMAIL]”),并保持其在文档中的位置和语法角色不变。此外,占位符需要具备唯一性,以便在模型回答中精确匹配和还原。基准中评估的“掩码精确率”正是衡量工具能否正确识别并替换所有应脱敏的实体,而“完整值可见比例”则衡量还原后原始值是否被意外暴露——这两个指标共同构成了可逆脱敏工具的核心评价维度。
基准设计:严谨与透明
该基准的设计强调可复现性和公平性。它排除了每个工具自身作者的数据集,以避免偏见;在相同数据集上比较引擎与各工具的检测性能;报告掩码精确率;并在一个留出集上测试——该留出集由合成文档构成,其文件、哈希、决策规则、运行计划和停止规则均在运行前公布。
所有评估数据均为合成数据,且基准由引擎作者本人运行,但代码、数据、预测结果和原始答案全部公开,供社区审查。
现有工具的表现:未达阈值
在外部数据集上,没有现有工具满足所有预定义阈值。具体而言,在英式英语中,标识符阈值和泄露阈值均未达到;在俄语中,标识符阈值处于临界状态。
在最后留出的每语言1000份文档集上,最佳现有工具在61%(俄语)和58%(英式英语)的文档中至少有一个完整值可见。这意味着超过一半的文档存在隐私泄露风险。
标识符阈值与泄露阈值的定义
基准中提到的“标识符阈值”和“泄露阈值”是预先设定的验收标准。标识符阈值通常指工具在检测个人数据实体时的最低召回率或F1分数,即必须识别出文档中至少一定比例的真实个人数据;泄露阈值则指在还原后的文档中,允许出现的完整原始值或部分原始值的最大比例。这两个阈值共同约束了工具的两类错误:漏检(未替换敏感信息)和过度替换(破坏非敏感内容)。在英式英语中,两个阈值均未达到,说明现有工具要么漏检严重,要么在还原时暴露了原始值;在俄语中,标识符阈值处于临界状态,意味着检测能力勉强达标但不够稳定。这些阈值并非随意设定,而是基于隐私保护的实际需求——例如,泄露阈值通常要求完整值可见比例低于1%,因为即使少量泄露也可能导致个人数据被重新识别。
新引擎的突破:大幅降低泄露
基于两个最强工具构建的新引擎,在相同文档上表现显著提升:在俄语和英式英语中,完整值可见的比例分别降至0.3% [0.1; 0.9] 和0.2% [0.1; 0.7];任何部分值可见的比例分别为0.8%和0.2%。同时,引擎在两种语言中均满足所有检测阈值。
在英式英语中,引擎在760个答案后仍能还原至少99%的占位符。但在俄语中,姓名占位符的还原率仅为94.6% [93.6; 95.6],低于99%的阈值,主要原因是它从pii-guard借用的词形变化规则产生了错误的姓氏形式。
词形变化(inflection)与姓名还原的挑战
俄语姓名还原率偏低(94.6%)的核心原因在于词形变化。俄语是一种高度屈折的语言,名词、形容词和姓氏会根据格、数、性发生变化。例如,一个姓氏在主语位置可能是“Иванов”,在属格位置变为“Иванова”,在与格位置变为“Иванову”。当工具用占位符替换姓名时,它需要识别并保留这种形态变化,以便在还原时根据上下文恢复正确的形式。如果工具简单地将所有变体视为同一实体并统一替换为固定占位符,还原时就无法区分不同格的形式,导致错误。pii-guard的词形变化规则可能只覆盖了部分常见模式,对不规则的姓氏或罕见变体处理不足,从而产生错误的姓氏形式。相比之下,英式英语的姓名形态变化较少,因此还原率超过99%。这一缺陷提示,跨语言可逆脱敏需要针对目标语言的形态学特征设计专门的替换和还原策略,而不能简单套用英语规则。
局限与未来方向
引擎是在同一生成器产生的六个早期留出集上开发的,尚未在真实文档上测试。俄语姓名还原的缺陷也提示了词形变化处理的挑战。尽管如此,该研究为可逆脱敏领域提供了首个开源双语基准和透明可复现的评估框架,推动了隐私保护LLM应用的发展。
结论
可逆脱敏是保护外部LLM请求中个人数据的实用手段,但现有开源工具在检测和泄露控制上仍有不足。新引擎在合成数据上展示了显著改进,尤其在降低完整值泄露方面,但在俄语姓名还原上仍需优化。未来工作应聚焦真实文档测试和跨语言形态学处理。
相关推荐
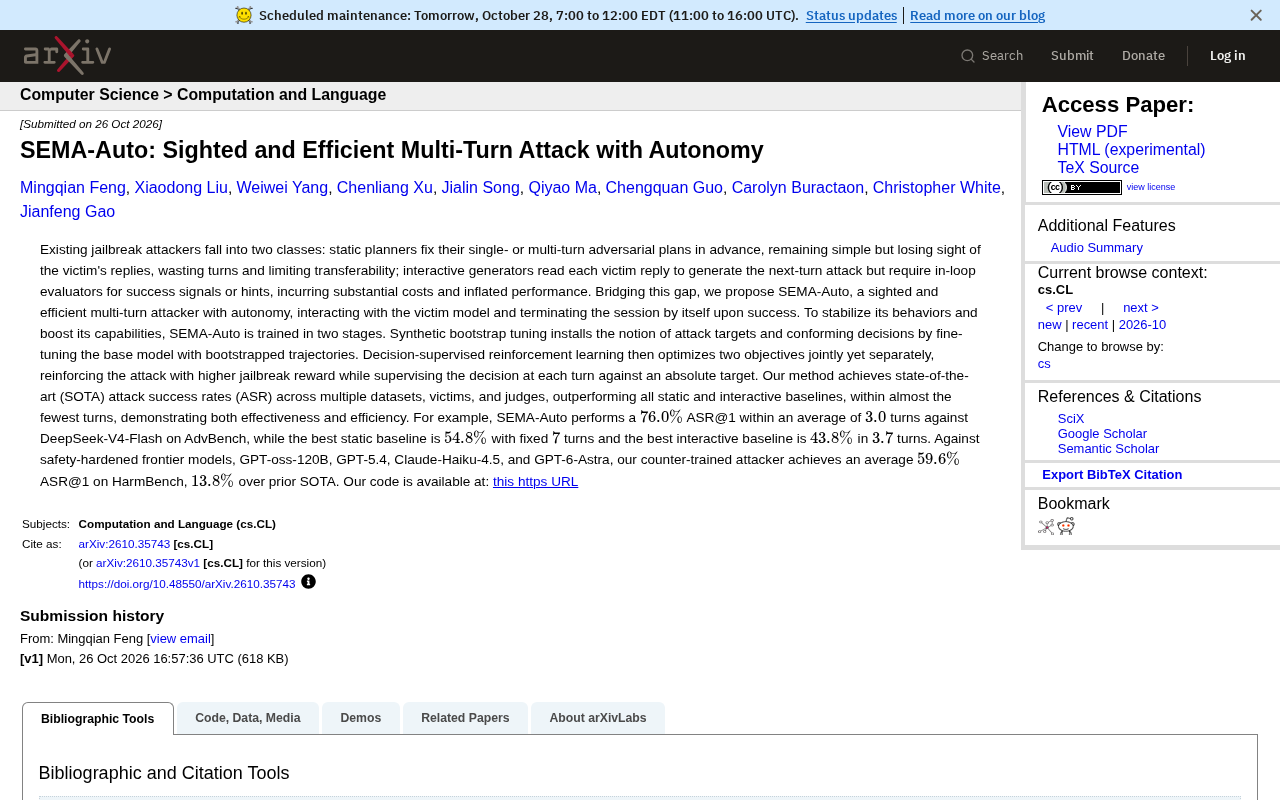
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
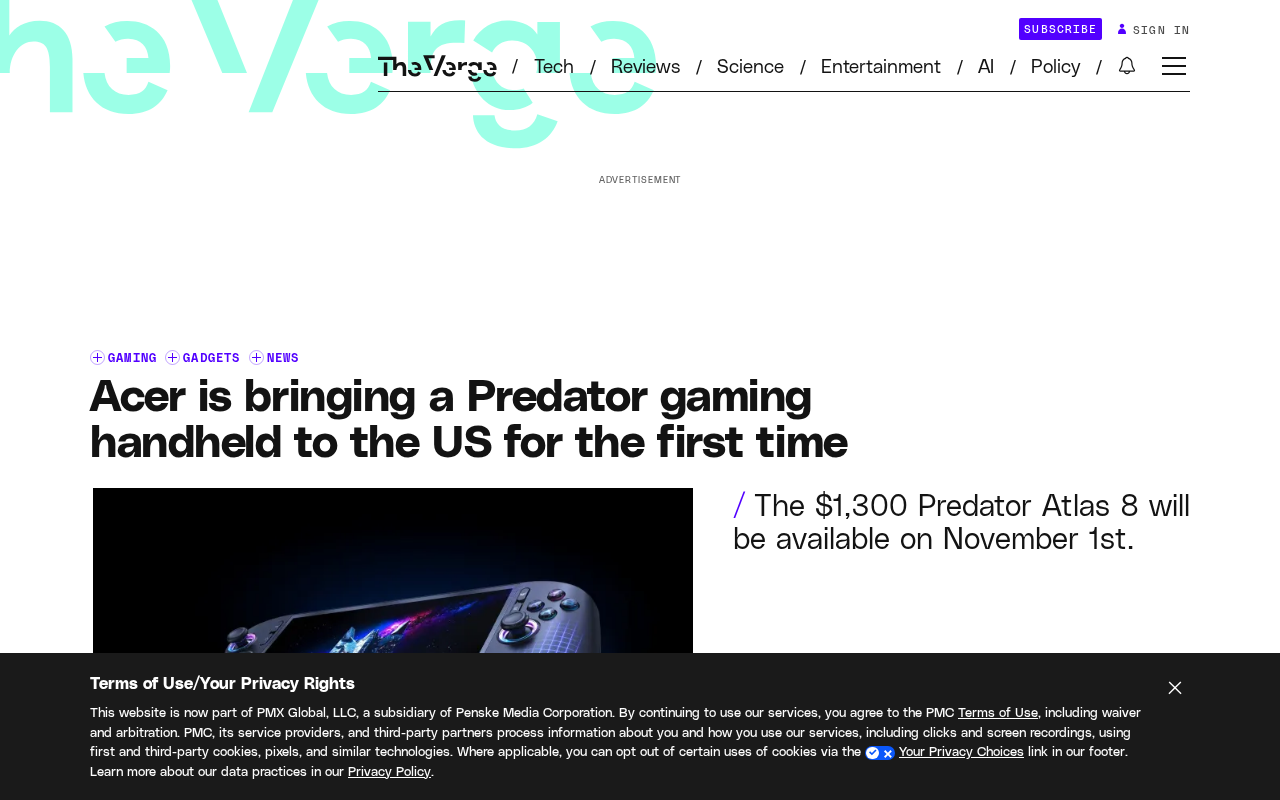
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。