外部状态引擎:让AI Agent从"宠物"变"牲畜"的架构设想
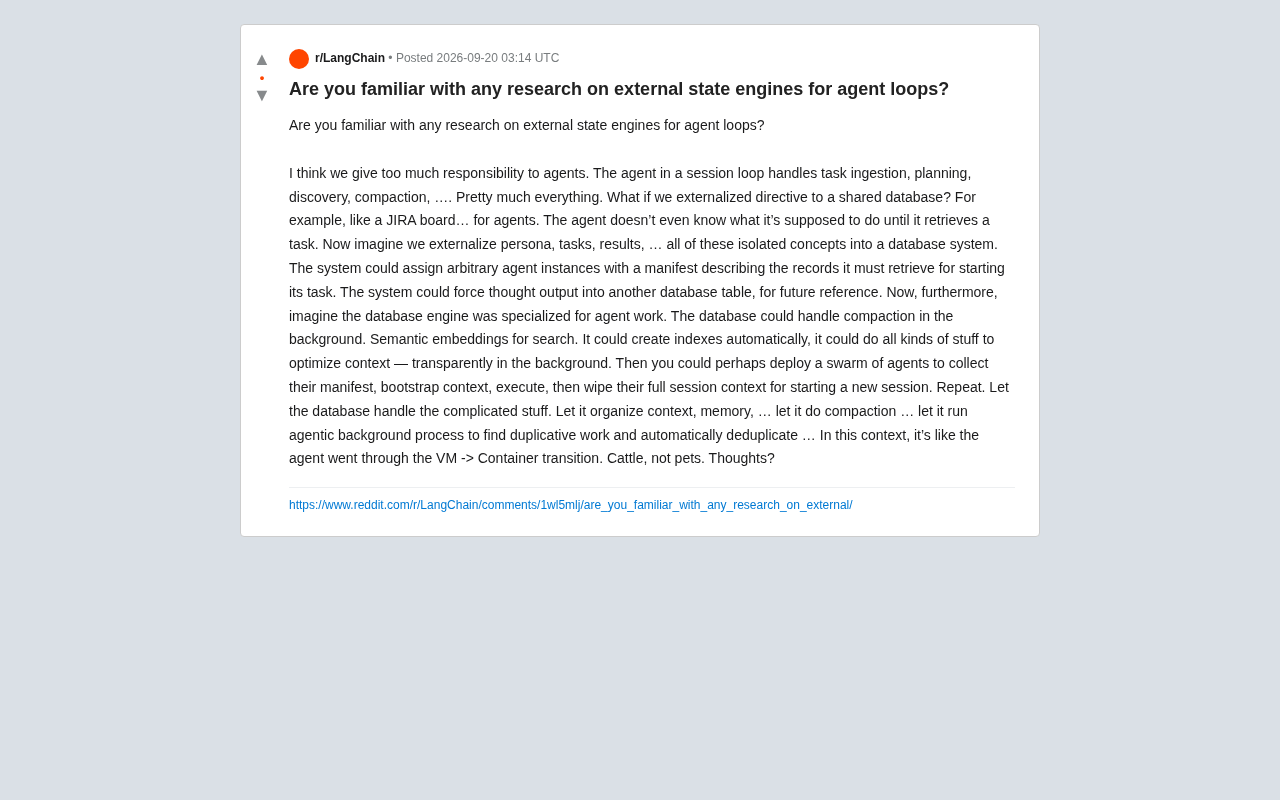
将Agent的状态、记忆与任务编排外化到专用数据库,让Agent退化为无状态、可随时销毁重建的执行单元。
一篇Reddit讨论帖提出:当前AI Agent设计让单个实例包揽任务摄取、规划、上下文压缩等全部职责,复杂度过高且难以维护。发帖者设想借鉴"JIRA看板"模式,将persona、任务、结果等概念全部拆解为数据库记录,Agent启动时通过manifest检索任务再执行,思考输出也强制写入外部存储。与此配套的是一个专为Agent优化的数据库引擎,能在后台透明地完成上下文压缩、语义嵌入检索、自动索引和任务去重。整体架构类比云原生的"Cattle, not Pets":Agent变为无状态的轻量执行单元,复杂的状态管理和记忆治理全部下沉至专用基础设施层,从而实现更好的可扩展性、可观测性与成本控制。
一个来自Reddit的架构追问
近期一篇Reddit讨论帖抛出了一个值得深思的问题:我们是不是给AI Agent赋予了太多职责?发帖者观察到,在典型的Agent会话循环中,单个Agent几乎包揽了所有工作——任务摄取(task ingestion)、规划(planning)、探索(discovery)、上下文压缩(compaction)等等,从头到尾一手包办。
这种"全能型"设计看似灵活,实则把复杂度全部压在了Agent这个不稳定的推理主体身上。发帖者提出的替代方案很有想象力:把这些职责从Agent内部"外化"到一个共享数据库中,让Agent回归纯粹的执行者角色。
为Agent设计的"JIRA看板"
发帖者用了一个形象的比喻:想象一个专门给Agent用的JIRA看板。在这套设想里,Agent在被启动时甚至不知道自己要做什么——它必须先从系统中检索任务才能明确目标。
具体机制是这样的:把persona(角色设定)、tasks(任务)、results(结果)等原本混在Agent上下文里的概念,全部拆解成数据库中相互隔离的记录。系统给任意一个Agent实例分配一份"清单"(manifest),描述它启动任务时需要检索哪些记录。Agent的思考输出也不再是转瞬即逝的会话内容,而是被强制写入另一张数据表,供未来引用。
这本质上是一种关注点分离(separation of concerns):Agent只负责推理和执行,状态、记忆、任务编排则交给外部系统托管。这样做的直接好处是Agent实例变得无状态、可替换,编排逻辑也从模型的"黑箱"里解放出来,变得可观测、可审计。
关注点分离(Separation of Concerns)是软件工程中的经典原则,指将系统的不同功能职责划分到相互独立的模块中,使每个模块只专注于单一问题域。在传统Web应用中,这体现为MVC架构将视图、业务逻辑和数据访问分层处理。将这一原则迁移到Agent设计,意味着模型只需负责推理和生成,而状态持久化、任务调度、记忆检索则由外部基础设施承担。当前主流Agent框架(如LangChain、AutoGen)虽提供了工具调用和记忆模块,但这些机制大多仍被封装在Agent的上下文窗口管理逻辑之内,并未真正实现"外化"。一旦上下文窗口接近上限,Agent往往需要自行决策压缩哪些信息,这种在推理过程中夹杂状态管理的设计,正是发帖者希望彻底解耦的核心问题。
一个懂Agent的专用数据库
这个设想中最有意思的部分,是对数据库本身的重新定义。发帖者构想的不是一个普通的存储层,而是一个为Agent工作专门优化的数据库引擎,它能在后台透明地处理大量脏活累活:
- 自动压缩(compaction):在后台整理和精简上下文,而不是让Agent在会话里手忙脚乱地做
- 语义嵌入检索:为记录生成embedding,支持语义搜索而非简单的关键词匹配
- 自动建索引:根据访问模式自动创建索引,优化上下文检索性能
- 智能上下文优化:透明地在后台完成各种上下文组织工作
更进一步,这个数据库还能运行"agentic"的后台进程——比如主动发现重复的工作项并自动去重(deduplicate)。换句话说,数据库不再是被动的存储,而是一个主动参与Agent协作治理的智能层。
**上下文压缩(Context Compaction)**是当前大语言模型工程中的核心挑战之一。由于LLM的上下文窗口有限(即便是支持百万token的模型也面临成本和注意力衰减问题),长时间运行的Agent必须周期性地将历史信息"压缩"成更精简的摘要,再继续推理。现有做法通常是让模型自身执行这一压缩过程,但这意味着:压缩的时机、粒度和信息取舍全部依赖模型的实时判断,既消耗推理资源,又难以审计。文中构想的"后台自动压缩"则将这一职责转移给数据库引擎,使其作为独立进程异步执行,不占用Agent的推理上下文。语义嵌入检索(Embedding-based Retrieval)则通过将文本转换为高维向量,使系统能够按语义相似度而非关键词精确匹配来检索相关记录,这是RAG(检索增强生成)架构的核心技术,将其内置于Agent专用数据库中,可显著降低Agent在检索阶段的工程复杂度。
"Cattle, not Pets":Agent的容器化时刻
发帖者用一个云原生领域的经典类比收尾:这套架构让Agent经历了从虚拟机到容器的转变——"Cattle, not Pets"(把服务器当牲畜而非宠物)。
在传统运维里,"宠物"是那些被精心照料、独一无二、出了问题要抢救的服务器;"牲畜"则是标准化、可随时销毁重建的实例。把这个理念套到Agent上:你可以部署一整群Agent,让每个实例领取自己的manifest、引导(bootstrap)出上下文、执行任务、然后彻底擦除整个会话上下文,再开始新的会话,如此循环。
复杂的东西全部交给数据库——它来组织上下文、管理记忆、执行压缩、去重。Agent本身则退化为轻量、无状态、随用随抛的执行单元。
这个方向的价值与开放问题
这套设想触及了当前Agent工程的一个真实痛点:上下文管理和长期记忆是目前多数Agent框架最脆弱的环节。把状态外化到专用引擎,理论上能带来更好的可扩展性、可靠性和成本控制(无状态实例更容易横向扩展和回收)。
不过它也留下了不少开放问题:把"智能"下沉到数据库层,是否只是把复杂度从一个地方搬到了另一个地方?后台自动去重、自动压缩如何保证不丢失关键信息?Agent与外部状态引擎之间的一致性和竞态问题又该如何处理?
发帖者本人也是在寻求相关研究("Are you familiar with any research..."),说明这更多是一个抛砖引玉的架构假设,而非成熟方案。但它清晰地指向了一个趋势——随着Agent系统规模扩大,把编排、状态与记忆从模型中剥离出来,交给专门的基础设施层,很可能是Agent工程演进的必经之路。
"Cattle, not Pets"这一比喻源自2012年云计算运维社区,最早由Randy Bias在OpenStack峰会上系统阐述。其核心思想是:传统物理服务器像宠物一样被命名、精心维护,一旦故障就要全力抢救;而现代云基础设施应像牲畜一样被批量管理,单个实例出问题直接销毁重建,而非修复。这一理念推动了不可变基础设施(Immutable Infrastructure)和容器化(如Docker/Kubernetes)的普及——应用状态与计算实例彻底分离,状态存入外部数据库或对象存储,计算节点本身保持无状态。将这套逻辑套用于Agent,其技术前提与容器化如出一辙:必须先有一个可靠的外部状态层(即文中构想的专用数据库),才能让Agent实例真正做到"随用随抛"。这也解释了为何文中对数据库引擎的设计要求如此之高——它扮演的角色,本质上就是Agent世界的Kubernetes etcd加持久化存储层。
结语
这篇讨论的核心洞察在于:与其让单个Agent背负所有责任,不如构建一个专为Agent设计的状态引擎,把任务编排、上下文压缩、记忆管理和去重等复杂工作外化并自动化。当Agent变成可随时创建和销毁的"牲畜",整个系统的弹性和可维护性都可能迎来质的提升。这个设想是否有对应的成熟研究和实现,仍值得社区持续探索。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。