外观模式:如何阻止第三方API污染你的代码
外观模式的真正价值不是简化调用,而是为第三方依赖筑起领域边界。
本文以集成 Stripe 支付为例,揭示了一个开发中极为普遍的问题:第三方 API 的实现细节(对象类型、错误类、字段名)会悄悄渗透进业务逻辑,造成强耦合。作者指出,许多人误以为引入外观模式只是为了"简化调用",但这只完成了一半——外观更重要的职责是充当边界,决定哪些数据结构、哪些错误、哪些操作可以越过边界进入领域层。正确的做法是定义自己的协议和返回类型(如 PaymentResult),将 Stripe 的细节彻底封装在实现层内部。这不仅让替换服务商变得轻松,也让测试大幅简化。文章还总结了三个常见陷阱:纯透传包装、"上帝外观"、以及隐藏调用方真正需要知道的行为,并厘清了外观与适配器模式的根本区别。
在集成 Stripe、OpenAI 这类第三方 API 时,开发者常常不知不觉让外部系统的设计悄悄渗透进自己的业务逻辑。等到需要替换服务商或升级版本时,才发现代码里到处都是第三方的实现细节,重构成本陡增。这篇内容围绕一个看似最简单、却最容易用错的设计模式——外观模式(Facade Pattern)——展开,讲清楚如何用它为代码筑起一道边界。
问题的根源:第三方细节无处不在
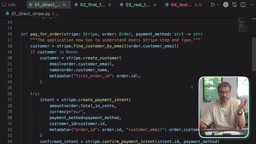
想象你要把 Stripe 支付集成到应用里。如果直接让 AI 生成代码,很可能得到这样一个 pay_for_order 函数:它拿到 Stripe 实例、订单和支付方式,先查找客户,没有就创建;接着创建 Payment Intent(Stripe 的支付流程对象),再根据不同的错误做分支处理。
这段代码本身能跑,但问题在于——如果每一处需要处理支付的地方都要写这种 Stripe 专属的复杂逻辑,代码很快会变成一团乱麻。更糟的是,系统中每个与支付相关的部分,都被迫去了解 Stripe 的实现细节:它有 customer、有 payment intent,这些对象长什么样、字段叫什么、错误类是哪些……
这就是典型的强耦合。你的设计被 Stripe 的设计方式牵着走。一旦要换掉 Stripe,或者升级到新版本,就变成一场大规模的重构工程。
第一步:用外观模式简化调用
外观模式的核心思路,是在复杂系统之上建立一个简化的接口,让业务逻辑不必再直接面对底层的复杂性。
具体做法是引入一个 PaymentService 外观类,它是对 Stripe 结算流程的封装,对外只暴露一个 pay 方法。创建客户、创建 Payment Intent 等逻辑全部收拢到这个服务内部。pay_for_order 不再直接接收 Stripe 对象,而是接收这个 service 作为参数。
这样一来,业务代码确实清爽多了——不用重复查找客户、创建 intent,也不用理解这些概念到底意味着什么。很多人到这一步就会说:"我们实现了外观模式,搞定!"
但这恰恰是最常见的错误。
外观模式(Facade Pattern)是"四人帮"(Gang of Four)在1994年《设计模式》一书中归纳的23种经典设计模式之一,属于结构型模式。它的名字来自建筑学中的"门面"概念——无论建筑内部结构多复杂,对外展示的只是一张整洁的立面。在软件工程中,外观模式通常表现为一个单独的类,将对多个子系统的调用序列封装起来,调用方只需与这个类交互,无需了解背后的协调细节。这个模式特别适合以下场景:分层架构中需要为每一层提供清晰入口、遗留系统需要对新代码屏蔽复杂性,以及集成外部库或服务时需要隔离第三方依赖。值得注意的是,外观并不阻止有需要的调用方绕过它直接访问子系统——它提供的是便利,而非强制封装。这也是为什么在第三方集成场景下,仅仅做到"简化"还不够,还必须有意识地管理边界。
关键误区:外观不只是"简化",而是"边界"
仔细看 pay 方法的签名,你会发现它仍然返回一个 Payment Intent 对象。也就是说,每个调用方拿到的还是 Stripe 专属的对象,还得去检查这个对象里的字段,还得了解 payment intent 的实现细节。更糟的是,Stripe 的错误(比如 card error)依然会抛到上层逻辑里。
换句话说,尽管表面上简化了流程,Stripe 的耦合依然存在。
真正要理解的是:外观应该像一道边界一样工作。简化只是其中一部分,更重要的是它要决定——哪些信息可以越过边界进入你的应用。
改进版的做法是定义一个 Payments 协议(protocol),其 pay 方法接收订单与支付方式,返回一个完全自定义的 PaymentResult 对象。这个对象与 Stripe 毫无关系,只包含你的领域真正关心的支付信息。业务逻辑依赖的是这个协议,而不知道具体实现。
底层则由一个 StripeGateway(或 payment service)去实现这个协议:创建客户、创建 payment intent、捕获错误,再把结果转换成 PaymentResult 返回。至此,Stripe 被彻底隐藏在服务内部,形成了一条清晰的边界。这才是外观模式最重要的价值。
文中提到的"协议"(Protocol)是 Python(尤其是3.8引入的 typing.Protocol)中实现结构化子类型(structural subtyping)的机制,有时也被称为"鸭子类型的静态版本"。与传统的抽象基类(ABC)不同,实现某个 Protocol 的类无需显式声明继承关系,只要具备所要求的方法签名,就被视为兼容——这与 Go 语言的接口机制非常相似。在本文的语境里,将 Payments 定义为 Protocol 而非具体类,意味着业务逻辑只依赖"能调用 pay 方法并返回 PaymentResult"这一契约,StripeGateway 和 FakeStripe 等具体实现可以随时替换,编译期(或类型检查时)即可发现不兼容问题。这种设计在依赖注入(Dependency Injection)场景下尤为有用,也是让测试中轻松替换为 fake 实现的技术基础。
这个问题无处不在
作者强调,Stripe 只是一个例子,同样的问题出现在任何类似外观的场景中:
- 天气 API:不要把 API 的原始响应到处传递,而是返回一个你自己创建的对象。
- 图形引擎(如 Pygame):别让引擎专属的向量、矩形对象混进你的领域模型。
- ORM(如 SQLAlchemy):别把 SQLAlchemy 的模型对象贯穿整个业务层传递。
- AI API:OpenAI 或 Anthropic 的响应对象,不要泄漏到应用的其他部分,而要在某处提取所需数据,封装成领域能接受的对象。
一句话总结:每当另一个系统的对象在你的代码库中扩散时,你其实就是在让那个系统塑造你的架构,引入大量耦合。
顺带的好处:测试变得简单
如果外观实现得当——不只是简化行为,还认真处理了错误和响应对象——测试会轻松很多。因为在测试里,你可以用一个 mock 对象整体替换掉外观。
作者演示了创建一个 FakeStripe,让它实现相同的接口,然后用几个测试类调用这个假类,运行 PyTest 即可通过,几乎不费力。而如果没有这层边界,让 AI 去生成这些测试会是一件相当繁重的工作。
实现外观时要避开的三个坑
第一,不要做纯粹的透传包装器。 如果外观里的方法是 create_payment_intent、confirm_payment_intent、cancel_payment_intent,这些依然是高度 Stripe 化的。外观应该真正简化,比如只暴露 pay 或 refund_order 这类有业务意义的方法。
第二,不要造"上帝外观"(God Facade)。 别把支付、发票、订阅、客户、优惠券全塞进一个巨大的 Stripe 外观对象。应该拆分成若干内聚、独立的服务或类。
第三,不要隐藏重要行为。 比如别假装支付永远是同步的;如果调用方确实需要知道客户认证是必需的,就应该把这个概念暴露出来,而不是藏起来。
外观与适配器的区别
人们常把外观(Facade)和适配器(Adapter)搞混。两者都是设计模式,都"包裹"了某个东西,但解决的问题不同。适配器的目标是让接口兼容;而外观的目标是简化对复杂子系统的访问,让你不必在应用各处面对那份复杂性。
除了外观和适配器,与"包裹某个东西"相关的设计模式还有几个容易混淆:**装饰器(Decorator)**同样包裹一个对象,但目的是在不改变接口的前提下动态添加职责,调用方与被装饰对象看到的是相同的接口;**代理(Proxy)**则与目标对象共享接口,用于控制访问、延迟初始化或添加缓存等横切关注点;**桥接(Bridge)**将抽象与实现分离,使二者可以独立演化,侧重的是维度扩展而非封装复杂性。理清这些区别有助于在实际项目中选择正确的模式:如果目标是"让现有接口能被复用",选适配器;如果目标是"向调用方隐藏子系统复杂度并建立领域边界",选外观;如果目标是"在运行时动态叠加行为",选装饰器。
结语
外观是你能遇到的最简单的设计模式之一,但也极易用错。一个好的外观会保护你的应用免受别人设计决策的影响——它决定哪些操作越过边界、哪些数据结构越过边界、你能看到哪些错误,甚至哪些"词汇"能进入你的领域。正是这些边界,让你的领域模型和业务逻辑在软件日益复杂时依然保持干净。
相关推荐

AI SDK 发布版本更新:sandbox-just-bash 组件信息速览
AI SDK 生态组件 @ai-sdk/sandbox-just-bash 发布 1.0.147 补丁更新,同步 @ai-sdk/harness 依赖。本文梳理该发布记录的版本信息与升级建议。

@ai-sdk/sandbox-vercel 1.0.147 发布说明
@ai-sdk/sandbox-vercel 1.0.147 版本发布,这是一次补丁级更新,主要同步升级内部依赖 @ai-sdk/harness 至相同版本,通过 GitHub 可信签名验证。

ChatGPT洗碗记:一支叉子引发的AI过度推理反思
一支洗碗机没洗净的叉子,引发AI启动"深度研究"、消耗海量算力甚至挑战纳维-斯托克斯千禧难题的荒诞实验。这则ChatGPT洗碗讽刺视频,折射出AI过度推理、算力成本与场景错配的真实困境。