WanderBench:视频世界模型能否探索动态世界?

WanderBench 基准揭示视频世界模型长时探索短板,WanderLand 免训练框架提升一致性。
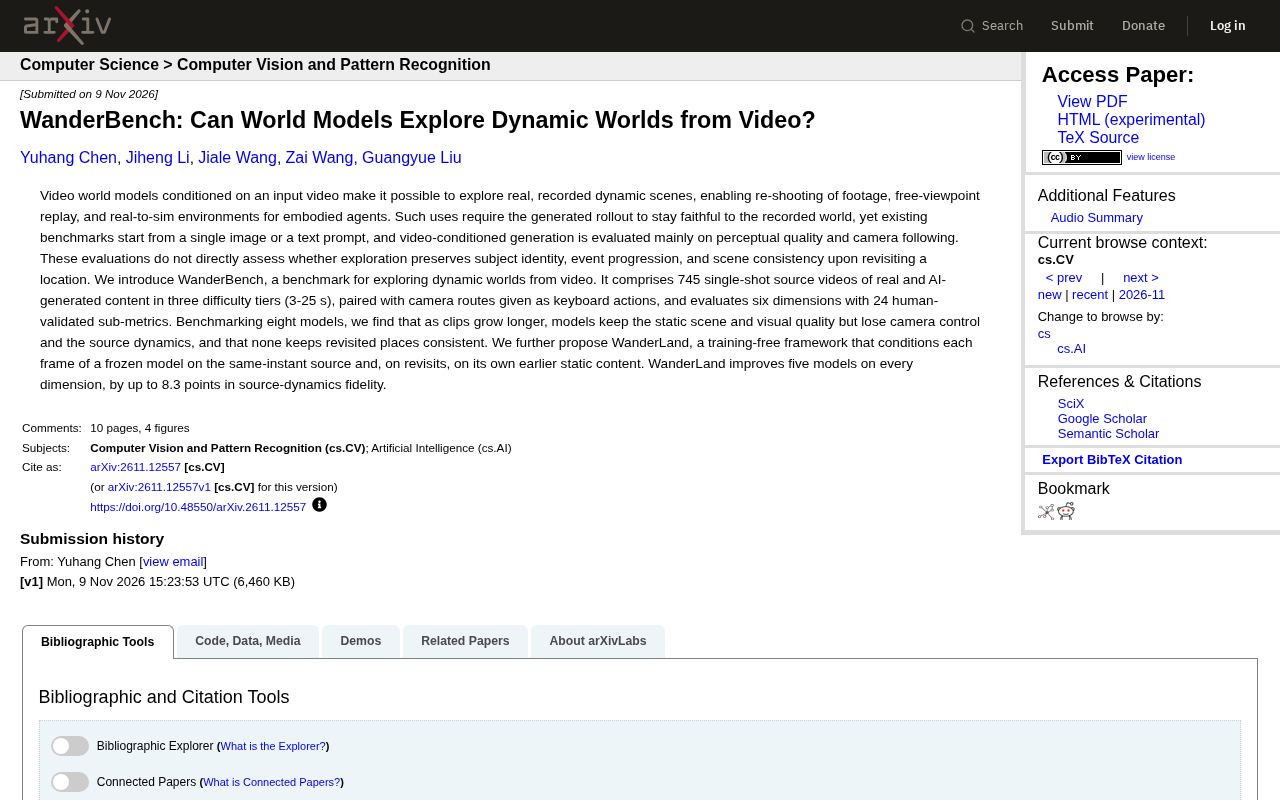
WanderBench 是首个专注于视频条件动态世界探索的评估基准,包含 745 段单镜头视频,分三个难度层级,用 24 个人工校验子指标评估六个维度的保真度。对八个模型的测试表明,随着片段变长,模型保持静态场景和视觉质量的能力尚可,但相机控制和源动态保真度下降,且无一能在重访地点时保持场景一致。针对此问题,研究者提出免训练框架 WanderLand,通过同时刻源视频条件和重访时自身静态内容条件,在五个模型上全面提升,源动态保真度最高提升 8.3 分。该工作将评估重点从感知质量转向动态一致性和场景记忆能力,为 real-to-sim 等应用提供了可复现的衡量标尺和低成本改进路径。
视频世界模型正从单一图像或文本提示走向以视频为条件的动态场景探索,但现有评估体系是否足以衡量其保真度?新基准 WanderBench 给出了答案。
视频世界模型的新战场:从静态生成到动态探索
以输入视频为条件的视频世界模型,让探索真实录制的动态场景成为可能。这类模型支持重拍、自由视角回放,以及为具身智能体构建 real-to-sim 环境。但要想真正实用,生成的 rollout 必须忠实于录制时的世界状态。
现有基准却大多从单张图像或文本提示出发,对视频条件生成的评估主要停留在感知质量和相机跟随层面。这些指标无法直接回答一个关键问题:探索过程中,主体身份、事件推进和重访场景时的一致性是否得以保持?
WanderBench 的提出正是为了填补这一空白。它专注于从视频探索动态世界这一任务,将评估重心从“画面好不好看”转向“世界是否一致”。
视频世界模型(Video World Model) 是一类以视频为输入或输出、旨在模拟动态环境演化的生成模型。与仅生成单帧图像或短视频片段的模型不同,视频世界模型强调对场景中物体运动、相机运动和事件因果关系的建模,从而支持交互式探索。其典型能力包括:给定一段真实录制的视频,模型能够生成从新视角观察同一场景的“重拍”(re-shoot),或允许智能体在生成的虚拟环境中自由移动。这类模型在具身智能(Embodied AI)领域尤为重要,因为构建 real-to-sim 环境需要将真实世界的动态过程忠实迁移到仿真中。
Real-to-sim 指将真实世界采集的数据(如视频、深度图、传感器读数)转化为可交互的仿真环境的过程。传统上,这依赖手工建模或三维重建,成本高且难以捕捉动态元素。视频世界模型提供了一条数据驱动的捷径:直接学习从视频到可探索动态场景的映射。在 real-to-sim 中,保真度不仅要求视觉逼真,更要求物理合理性和时序一致性,否则在仿真中训练的智能体策略难以迁移回真实世界。WanderBench 正是针对这一需求,将评估重点从画面质量转向世界状态的一致性。
WanderBench 的设计:多难度、多维度、人工校验
WanderBench 包含 745 段单镜头源视频,涵盖真实拍摄与 AI 生成内容,并按时长分为 3 秒至 25 秒三个难度层级。每段视频都配有关键盘动作定义的相机路线,用于指导模型在动态世界中的探索路径。
评估体系覆盖六个维度、24 个人工校验的子指标。这些维度系统性地考察模型在长时段探索中能否保持主体身份、事件进展和场景一致性。人工校验确保了指标的有效性,避免纯自动指标可能带来的偏差。
八大模型实测:长视频暴露短板,重访一致性全线失守
研究者对八个模型进行了基准测试,发现了一个清晰的趋势:随着片段变长,模型能够保持静态场景和视觉质量,却逐渐失去对相机控制的能力,同时源视频中的动态信息也在流失。更严峻的是,没有任何一个模型能在重访同一地点时保持场景一致。
这一结果揭示了当前视频世界模型的核心瓶颈——它们擅长“看起来真实”,却不擅长“记住并还原”。动态世界的探索不仅要求生成流畅的视频,还要求模型理解场景的持久结构,并在不同时间点访问同一位置时输出一致的内容。
重访一致性(Revisit Consistency) 是评估世界模型记忆能力的关键指标,指模型在探索路径中多次访问同一地理位置时,能否生成视觉和语义上一致的场景内容。在动态世界探索中,相机可能绕行一圈后回到起点,或沿不同路径经过同一房间。理想情况下,无论何时重访,该地点的静态结构(如墙壁、家具)和动态元素(如人物位置)都应保持合理一致。然而,现有模型往往在长时段生成中逐渐“遗忘”早前见过的场景,导致重访时出现物体消失、布局改变或纹理漂移。WanderBench 将重访一致性纳入核心评估维度,并发现所有测试模型均在此项上失败,这揭示了当前视频生成模型缺乏持久场景记忆的普遍缺陷。该指标对于 real-to-sim 应用至关重要,因为智能体在仿真中需要可靠的空间记忆来规划路径和操作物体。
WanderLand:免训练框架,五模型全面提升
针对上述问题,研究者提出了 WanderLand,一个免训练的框架。它的核心思路是:对冻结模型生成的每一帧,都以同一时刻的源视频帧作为条件;当模型重访某个地点时,则以其自身早前生成的静态内容作为条件。
这种双重条件机制在不重新训练模型的情况下,显著提升了探索的保真度。在五个模型上,WanderLand 在每一个评估维度都带来了改进,其中源动态保真度最高提升了 8.3 分。
这一结果说明,视频世界模型的探索能力并非只能依赖更大规模的训练,巧妙的推理时条件设计同样能释放潜力。对于需要 real-to-sim 环境的具身智能研究而言,这种免训练方案降低了落地门槛。
免训练框架(Training-free Framework) 指在不更新模型参数的前提下,通过推理时的条件设计、提示工程或外部记忆机制来提升生成质量的方法。这类方法成本低、即插即用,尤其适合已经部署的大模型。WanderLand 采用的双重条件机制即属于此类:对于每一帧生成,它同时以同一时刻的源视频帧和模型自身早前生成的静态内容作为条件,从而在不重新训练的情况下增强时序一致性和场景记忆。免训练方法的核心挑战在于如何设计条件信号,使其既能提供足够的信息又不干扰模型原有的生成能力。WanderLand 的成功表明,推理时条件设计可以成为提升视频世界模型探索能力的有效杠杆,为资源有限的研究者和开发者提供了实用路径。
对行业的意义:评估先行,推动世界模型走向可控
WanderBench 的价值不仅在于提供了一个新基准,更在于它重新定义了视频世界模型的评估标准。当行业从追求视觉逼真转向追求世界一致性,模型的设计目标也会随之调整。
从应用角度看,自由视角回放、重拍和 real-to-sim 环境都要求模型对场景有持久的记忆能力。WanderLand 的免训练思路为现有模型提供了一条低成本的改进路径,而 WanderBench 则为后续研究提供了可复现的衡量标尺。
视频世界模型的下一个突破点,或许不在于生成更漂亮的画面,而在于能否在探索中守住世界的规则。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。