WAS-PO:用白化优势解决多奖励强化学习的相关性陷阱

WAS-PO 通过白化优势修正多奖励相关性导致的权重扭曲,训练奖励提升但泛化未改善。
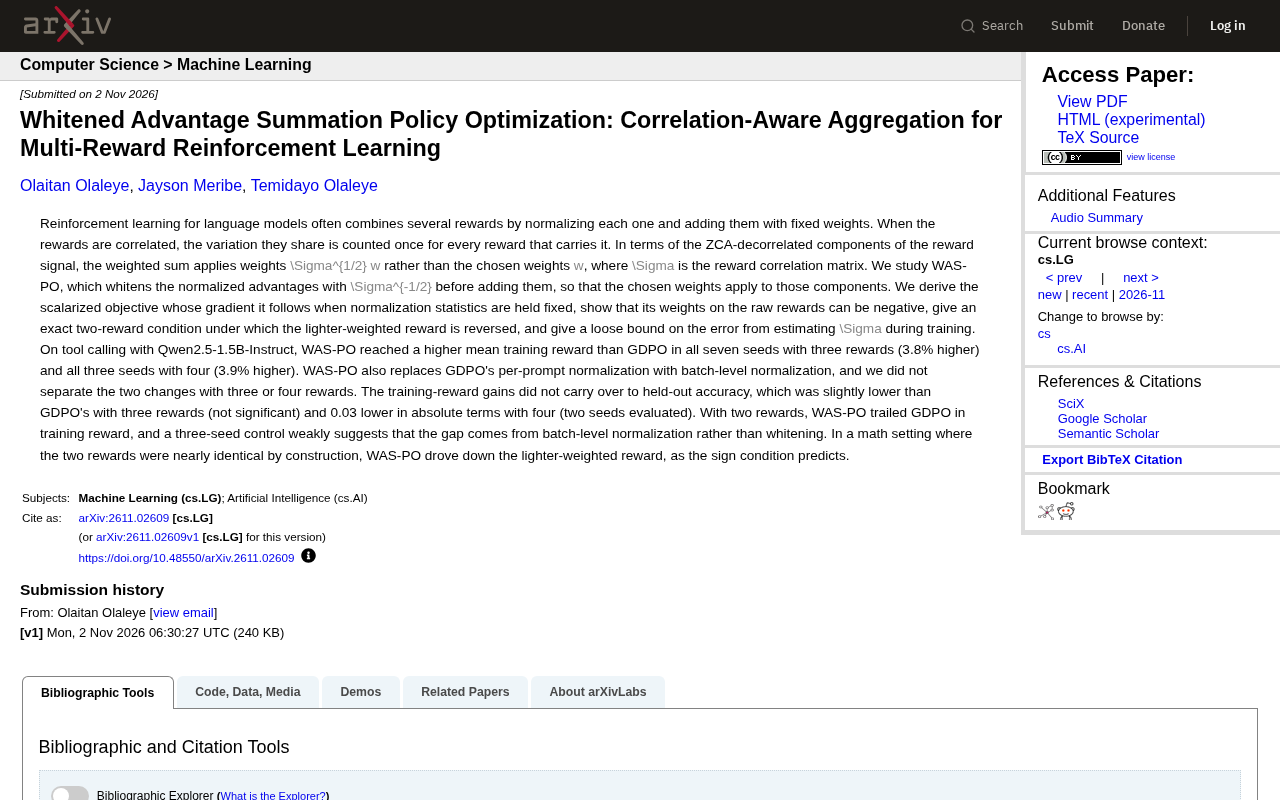
论文指出多奖励强化学习中,奖励相关性会使朴素加权求和的实际权重变为 Σ^{1/2}w,偏离设定值。WAS-PO 提出在归一化优势后、加权前用 Σ^{-1/2} 白化,使权重作用于去相关分量。理论推导表明等效权重可能为负,并给出两奖励下轻权重被反转的精确条件。工具调用实验中,三/四奖励下训练奖励分别高 3.8%/3.9%,但留出准确率未提升甚至略降;两奖励下落后于 GDPO,且白化与归一化改动未分离。论文价值在于揭示结构性问题并提供可检验预测,但实验效果有限。
多奖励强化学习(Multi-Reward RL)在语言模型对齐中越来越常见——一个模型可能同时需要优化工具调用的准确性、回答的有用性、以及安全性。标准做法是把每个奖励归一化后,用固定权重加权求和。但当这些奖励彼此相关时,这种朴素做法会系统性地扭曲你实际施加的权重。一篇来自 arXiv 的新论文提出了 WAS-PO(Whitened Advantage Summation Policy Optimization),从协方差结构出发重新审视了这个问题。
相关性如何悄悄扭曲你的奖励权重
论文的核心洞察可以用一句话概括:当奖励之间存在相关性时,加权求和会把它们共享的变异重复计算。假设你有两个奖励信号,它们高度相关——比如“回答准确性”和“工具调用成功率”在工具调用任务中往往同向变化。你给第一个奖励权重 0.7,第二个 0.3,直觉上你以为最终优化目标中两者的贡献比是 7:3。
但实际上不是。从奖励信号的 ZCA 去相关分量来看,加权求和实际施加的权重是 $\Sigma^{1/2} w$,而非你选定的 $w$,其中 $\Sigma$ 是奖励相关矩阵。当 $\Sigma$ 不是单位矩阵时,$\Sigma^{1/2} w$ 的各分量可能与你设定的权重方向大相径庭——某些分量的权重被放大,某些被压缩,甚至符号都可能翻转。
这解释了为什么在实践中,调好的奖励权重换一个任务或换一组奖励组合就“失灵”了:你调的是一组参数,模型优化的却是另一组。
ZCA 白化(ZCA Whitening) 是一种线性变换,用于将具有相关性的随机向量转换为各分量不相关且方差为 1 的向量,同时尽可能保持变换后的向量与原向量在欧几里得空间中的接近程度。给定协方差矩阵 $\Sigma$,ZCA 白化变换矩阵为 $\Sigma^{-1/2}$,变换后的数据协方差变为单位矩阵。在奖励聚合的语境中,原始奖励向量经过 $\Sigma^{-1/2}$ 作用后,其各分量变为去相关的“白化奖励”,此时再施加权重 $w$,权重便真正作用在独立分量上。与之相对,若直接对原始奖励加权求和,等价于在 ZCA 白化空间中使用权重 $\Sigma^{1/2}w$,这正是权重语义被扭曲的数学根源。ZCA 与 PCA 白化的区别在于,ZCA 不进行旋转,变换后的分量仍尽可能保留原始坐标轴的方向,因此更利于解释权重含义。
WAS-PO 的做法:先白化,再加权
WAS-PO 的方案直接针对上述问题:在归一化优势之后、加权求和之前,先用 $\Sigma^{-1/2}$ 对优势做白化(whitening),使得后续的加权作用在去相关后的分量上。这样,你选定的权重 $w$ 就真正作用在了 ZCA 去相关分量上,权重语义与优化目标对齐。
论文进一步推导了在归一化统计量固定时 WAS-PO 梯度所跟随的标量化目标,并给出了两个值得注意的理论结果:
- 原始奖励上的等效权重可能为负。 即使你给所有奖励设定的权重都是正数,白化后的聚合目标在某些原始奖励上的等效权重仍可能是负的。这意味着模型可能在“追求”某个奖励的反方向——这不是 bug,而是相关性结构在数学上的必然投影。
- 两奖励下的精确反转条件。 论文给出了一个精确的两奖励条件,在该条件下,权重较轻的那个奖励在等效目标中会被反转。这为调试多奖励设置提供了一个可检验的诊断信号。
此外,论文还给出了在训练过程中估计 $\Sigma$ 所引入误差的一个宽松上界。这个界比较松,但至少说明估计误差不会无界放大。
批量级归一化与逐提示归一化 是优势归一化的两种不同粒度。逐提示归一化(per-prompt normalization)对每个提示(即每组同源回答)内部的优势值单独进行标准化,消除提示间难度差异带来的尺度波动;批量级归一化(batch-level normalization)则对整个训练批次内的所有优势值统一计算均值和标准差,进行全局缩放。前者更注重局部可比性,后者计算更简单且能稳定全局梯度尺度。WAS-PO 用批量级归一化替换了 GDPO 的逐提示归一化,这一改动与白化操作在实验中未被分离,因此两奖励下 WAS-PO 的落后可能源于归一化粒度的变化而非白化本身。理解这一区别有助于判断方法改进的真正来源。
实验结果:训练奖励提升,但泛化未同步
论文在工具调用任务上用 Qwen2.5-1.5B-Instruct 做了实验,对比基线是 GDPO。结果呈现出一种值得警惕的分裂:
训练奖励上,WAS-PO 稳定占优。 三奖励设置下,七个随机种子全部取得更高的平均训练奖励,幅度为 3.8%;四奖励设置下,三个种子全部占优,幅度为 3.9%。这种全种子一致性说明提升不是噪声。
但训练奖励的提升没有传导到留出准确率。 三奖励下 WAS-PO 的留出准确率略低于 GDPO(不显著);四奖励下绝对低 0.03(仅评估了两个种子)。换句话说,模型在训练目标上得分更高,但在真正关心的任务指标上没有变得更好。
两奖励下 WAS-PO 反而落后。 在只有两个奖励的设置中,WAS-PO 的训练奖励低于 GDPO。论文用一个三种子对照实验弱弱地指向了原因:差距可能来自批量级归一化(batch-level normalization)而非白化本身。这里需要说明一个混淆因素——WAS-PO 同时用批量级归一化替换了 GDPO 的逐提示归一化(per-prompt normalization),论文明确表示在三或四奖励下没有将这两个改动分离开来。所以“白化贡献了多少”这个问题,实验设计尚未给出干净答案。
符号预测的验证。 在一个数学任务设置中,两个奖励按构造几乎相同。WAS-PO 如符号条件所预测的那样,压低了权重较轻的那个奖励。这是对理论分析的一个直接支持。
如何理解这组结果
这篇论文的价值有两层。理论层面,它把多奖励聚合中一个被长期忽视的结构性问题摆上了台面:奖励相关性会扭曲权重语义,而白化是一个有原则的修正方案,且附带了可检验的预测(符号反转条件)。
实验层面,结果诚实但不算亮眼。训练奖励的稳定提升与留出准确率的不变甚至微降并存,提示我们“更高的聚合训练奖励”未必等于“更好的模型”——这在多奖励 RL 中是一个反复出现的现象,WAS-PO 并未例外。两奖励下的落后以及归一化改动的混淆,也让方法的适用边界尚不清晰。
对于正在做多奖励 RLHF 或多目标对齐的实践者,论文的实用启示或许是:检查你的奖励相关矩阵。如果奖励之间相关性很低,白化带来的改变有限;如果相关性很高,那么你当前调的权重很可能根本没有作用在你以为的方向上——无论你是否采用 WAS-PO,这一点都值得警惕。
留出准确率(held-out accuracy) 指模型在训练过程中未见过、独立于训练奖励信号的评估数据集上的任务准确率。在多奖励强化学习中,训练奖励是优化目标的直接体现,但模型可能通过过拟合奖励信号的特定模式(如利用奖励模型的偏差)来提升训练奖励,而非真正提升任务能力。留出准确率作为外部指标,能更真实地反映模型的泛化性能。WAS-PO 实验中训练奖励提升但留出准确率未同步,正说明聚合训练奖励的优化可能与实际任务目标存在错位,这是评估多奖励 RL 方法时必须警惕的现象。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。