WASM数据处理实战:浏览器能跑大数据吗?

一个听起来离谱的问题
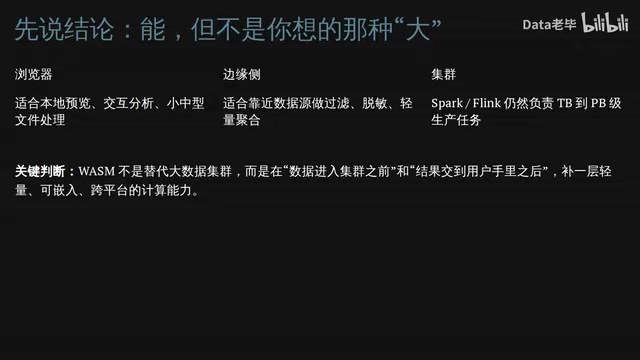
把大数据塞进浏览器里跑,这个想法乍一听确实有点离谱。但B站UP主Data老B在其大数据工程实战系列中给出了一个更务实的答案:能跑一部分,但绝不是把Spark塞进浏览器。
WebAssembly(WASM)真正有价值的地方,不在于替代分布式集群,而是在数据链路的前后两端补一层能力——把轻量计算下放到用户电脑、边缘节点、数据源附近,让数据在进入中心平台之前就先被处理一轮。
这是一个关于计算前移的故事,也是理解现代数据架构演进的重要视角。
WebAssembly究竟带来了什么能力
要理解WASM在数据处理中的定位,先得搞清楚它的核心背景与特性。
WebAssembly并非凭空出现,其诞生源于浏览器性能瓶颈的长期积累。早在2013年,Mozilla工程师就提出了asm.js——一种高度优化的JavaScript子集,通过静态类型标注让JS引擎能够预编译生成近原生效率的代码。asm.js证明了浏览器具备运行高性能计算逻辑的潜力,但仍受限于文本格式解析开销。2015年,Mozilla、Google、Microsoft和Apple四大浏览器厂商宣布联合推进WebAssembly标准,将二进制格式作为核心设计目标,彻底解决了asm.js的解析瓶颈。2017年,WASM MVP版本在主流浏览器同步落地,2019年正式成为W3C正式标准,成为继HTML、CSS、JavaScript之后的第四种Web原生技术。
它并非一门编程语言,而是一种低级字节码格式——由C、C++、Rust、Go等语言编译生成,可在浏览器虚拟机中以接近原生的速度执行。WASM的性能优势源于其静态类型系统和紧凑的二进制格式,使得JavaScript引擎无需动态类型推断即可高效运行计算密集型逻辑。
基于这一底层特性,WASM为数据工程带来三个关键能力:
- 运行性能接近原生代码:计算密集型任务不再是浏览器的短板;
- 沙箱隔离,默认不信任代码:安全性天然内建,适合运行第三方或不可信的计算逻辑;
- 一次编译,多端运行:同一份WASM模块可以跑在浏览器、服务端和边缘节点上。
值得特别说明的是,WASI(WebAssembly System Interface)规范进一步放大了这一潜力。WASI通过定义一套与操作系统无关的系统调用接口,使WASM模块能够以受控方式访问文件系统、网络套接字等宿主系统资源。Docker联合创始人Solomon Hykes曾表示:「如果WASM+WASI在2008年就存在,Docker就没必要被发明了。」这句话充分说明了WASI在跨平台部署领域的影响力——它提供了比容器更轻量、启动更快、隔离同样完善的运行时抽象,使WASM成为真正通用的跨平台运行时标准。
对数据工程来说,这几点的意义非常直接。很多用C++或Rust编写的数据库内核、压缩算法、格式解析器,都可以被包装成一个可移植、安全的计算单元,在任何支持WASM的环境里运行,而不必为每个平台单独适配。
DuckDB-WASM:浏览器端SQL的标杆
如果要为这个方向找一个标志性产品,那就是DuckDB的WASM版本。
DuckDB本身由荷兰CWI数据库研究中心开发,定位为"SQLite of OLAP"——专注列式存储和向量化执行引擎,单机可高效处理GB级数据分析查询,常被称为嵌入式OLAP数据库领域的里程碑。其核心竞争力在于向量化执行引擎:传统的火山模型(Volcano Model)每次调用next()只处理一行数据,函数调用开销极大;而DuckDB改为每次处理一批数据(通常1024至2048行),将同一列的数据连续存放在内存中,使CPU的SIMD指令能够并行处理多个数值,极大提升了缓存命中率和计算吞吐量。这一设计使DuckDB在聚合、过滤等分析场景下比行存数据库快出一到两个数量级。
DuckDB的WASM版本(duckdb-wasm)由MotherDuck团队维护,通过Emscripten工具链将C++内核编译为WASM模块,并支持SharedArrayBuffer多线程加速和OPFS(Origin Private File System)持久化存储,使浏览器内的SQL引擎具备相当完整的生产级能力。
需要注意的是,多线程模式的启用依赖SharedArrayBuffer——这一特性在2018年Spectre漏洞曝光后曾被各大浏览器暂时禁用,2020年起通过引入跨域隔离机制(Cross-Origin Isolation)才得以恢复。这意味着部署DuckDB-WASM多线程模式需要服务器响应头包含Cross-Origin-Opener-Policy: same-origin和Cross-Origin-Embedder-Policy: require-corp,是工程落地中容易被忽视的配置细节。
DuckDB的WASM版本可以直接在浏览器里读取CSV、Parquet、Arrow等格式的文件,然后用标准SQL做筛选、聚合、Join乃至窗口函数运算。
这带来的变化是范式级的:过去网页只是展示报表,现在网页可以自己读数据、跑SQL,再把结果直接交给前端图表组件。

浏览器从纯粹的"展示层",升级成了具备本地计算能力的"轻量分析引擎"。数据不必往返服务器,交互体验和数据隐私都能因此受益。
两个典型的落地场景
场景一:本地数据探索与预处理
设想一个常见需求:用户准备上传一个CSV或Parquet文件。传统做法是先把文件传到服务器,再由后端解析分析。
而借助浏览器里的WASM,系统可以在文件上传前就在本地完成初步分析——计算字段类型、空值比例、样本分布,甚至做敏感字段识别和脱敏。
好处有两点:一是隐私数据不必先传服务器,降低合规风险;二是小文件分析不必每次都打到后端SQL服务,减轻服务端压力。BI自助分析、数据目录、文件导入向导等场景,都非常适合这种模式。
场景二:边缘侧数据处理
第二个场景把WASM推向了更靠近数据源的边缘侧。边缘计算是指将计算能力部署在靠近数据源的网络边缘节点,而非集中在云端数据中心。
WASM在边缘计算领域的崛起,本质上是对传统容器技术冷启动瓶颈的一次颠覆。以AWS Lambda为代表的传统Serverless架构,冷启动时间通常在100ms至数秒之间,这对于延迟敏感的边缘场景是难以接受的。而原生WASM运行时(如Wasmtime、WasmEdge)的冷启动时间可低至毫秒级,且单一运行时可安全隔离运行多租户代码,非常适合高密度部署的边缘环境。Fastly的Compute@Edge、Cloudflare Workers、Fermyon Spin等平台均已将WASM作为一等公民的运行时,形成了与传统Serverless不同的技术路线。对于数据工程师而言,这意味着边缘侧的数据预处理逻辑可以用Rust或C++编写并编译为WASM,以极低延迟部署在全球数百个节点。
具体业务形态包括:
- IoT网关先过滤异常数据;
- 日志代理先做采样和字段提取;
- CDN或边缘函数先做格式转换。

WASM在边缘计算场景的优势是启动快、体积小、隔离强,且多种语言都能编译到统一运行时。未来不是所有数据都先丢进中心数仓,大量计算会前移到网关、代理和边缘节点,在进入中心链路之前完成初步清洗。
能力边界:WASM不擅长什么
技术布道最忌讳夸大能力。Data老B明确指出了WASM不擅长的领域:
- 不适合TB到PB级的全量批计算;
- 不适合长时间运行的复杂流处理;
- 不负责资源调度、失败重试、状态一致性——这些是分布式系统要解决的问题。
此外,浏览器环境本身还存在诸多约束:内存上限(通常为4GB)、文件读写权限、网络权限,以及多线程(需要SharedArrayBuffer和COOP/COEP响应头支持)和SIMD向量化指令的兼容性问题。
一句话总结:WASM很强,但它不是分布式系统。 真正的TB到PB级生产任务,仍然要交给Spark、Flink、数仓和调度系统。
三层架构:WASM如何融入大数据体系
WASM不是来颠覆现有架构的,而是来补位的。一个清晰的三层组合模型如下:
- 端侧:负责预览、校验、脱敏,让用户在上传前就了解数据质量;
- 边缘侧:负责过滤、聚合、转换,减少无效数据进入中心链路;
- 中心侧:仍然负责数仓、批流处理、数据治理和统一口径。

核心原则是:把WASM当作前置计算层和交互计算层,而不是主计算引擎。 它在数据洪流的上游拦截脏数据、无效数据,让流向中心的数据更干净、更精炼。
数据工程师如何跟进这一趋势
对于想要落地WASM数据处理能力的工程师,以下三步可以作为起点:
- 动手实践:先用DuckDB-WASM查询Parquet文件,亲身感受浏览器内SQL的能力边界;
- 理解Arrow格式:搞清楚Apache Arrow在前后端数据传输中的价值。Apache Arrow于2016年由Wes McKinney(pandas作者)主导发起,其核心设计目标是解决大数据生态中各系统间数据交换效率低下的问题。传统数据管道中,数据在Python、JVM、C++等不同运行时之间传递时,需要经历序列化-网络传输-反序列化的完整流程,这些步骤往往占据总处理时间的70%以上。Arrow通过定义统一的内存列式布局,使不同语言的运行时可以直接读取同一块内存中的数据,实现真正的零拷贝共享。在WASM场景中,当DuckDB-WASM完成查询后,结果可以直接以Arrow格式传递给JavaScript端的图表库(如Apache ECharts或Vega-Lite),无需额外格式转换,极大压缩了从查询到渲染的端到端延迟;
- 重新划分职责:思考哪些数据预检逻辑可以从后端迁移到端侧,系统性减轻服务端负担。
长期来看,WASM会让数据处理更靠近现场——小数据本地算,脏数据前面拦,重任务仍然交给数仓和集群。这不是一场颠覆,而是架构的自然演进:计算正在向数据流动的两端渗透,让整个数据链路更高效、更安全,也更贴近真实业务场景。
核心要点
核心要点
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。