Wasserstein空间信赖域优化:非凸能量最小化的二阶方法

将经典信赖域优化严格推广到Wasserstein空间,用于非凸势能-相互作用能量最小化,理论复杂度与粒子数及维度无关。
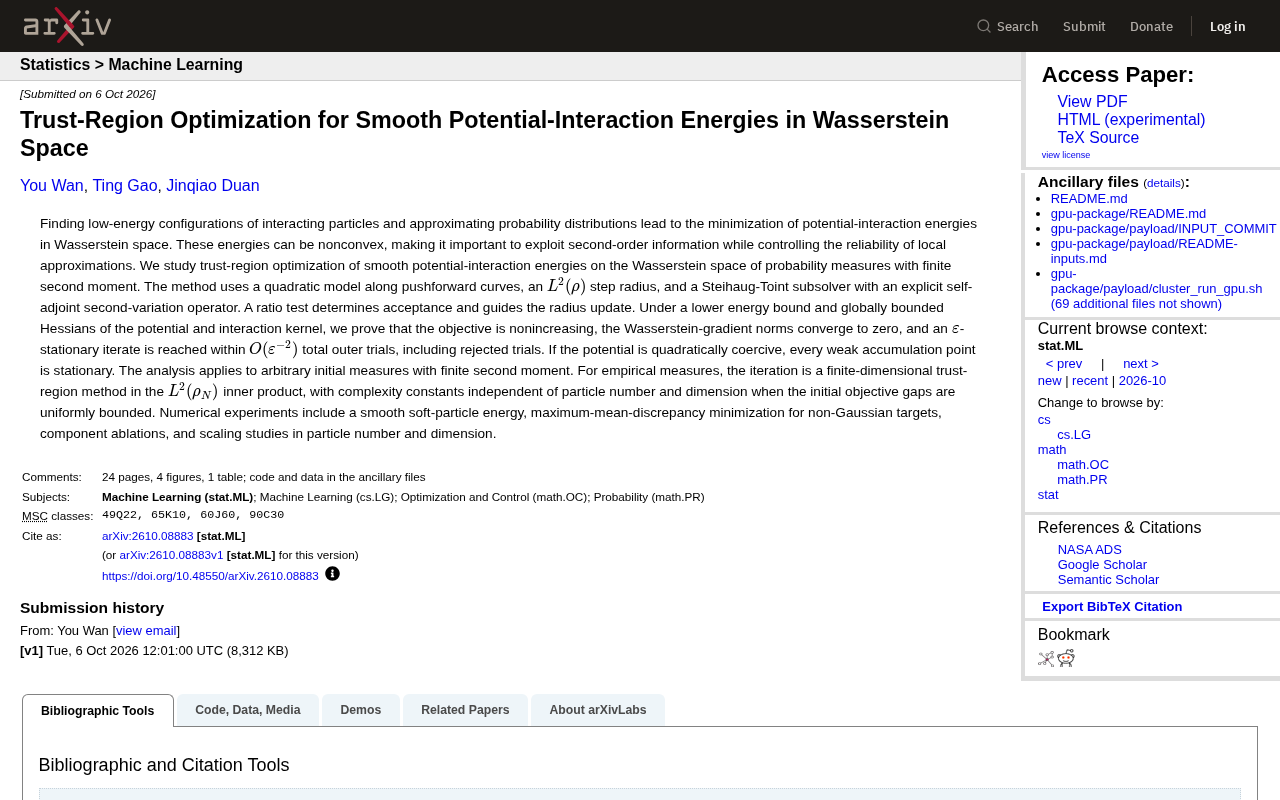
本文将数值优化中成熟的信赖域方法系统迁移至Wasserstein测度空间,以解决粒子建模与分布逼近中的非凸能量最小化问题。核心构造包括:沿推前曲线建立含显式二阶算子的二次模型、以$L^2(\rho)$范数定义信赖域半径、利用Steihaug-Toint求解器高效处理子问题,并通过比值测试动态更新半径。理论上,论文证明了目标能量单调不增、梯度范数收敛至零,以及在$O(\varepsilon^{-2})$次外层试探内达到$\varepsilon$-稳定点——与经典非凸优化结果一致。尤为重要的是,针对经验测度场景,复杂度常数与粒子数和维度均无关,为大规模应用提供了理论支撑。数值实验在软粒子能量、MMD最小化、消融研究及规模扩展等场景上验证了方法的有效性。
研究背景:为何要在Wasserstein空间做优化
在粒子系统建模与概率分布逼近这两类问题中,一个共同的数学内核是在Wasserstein空间上最小化势能-相互作用能量(potential-interaction energies)。无论是寻找相互作用粒子的低能构型,还是用一组样本去近似某个目标分布,本质上都归结为在具有有限二阶矩的概率测度空间上做能量最小化。
这类问题的棘手之处在于:能量函数往往是非凸的。非凸意味着一阶方法(如梯度流)容易陷入局部结构不佳的区域,收敛速度和可靠性都难以保证。要想突破这一瓶颈,自然的思路是引入二阶信息——也就是利用能量的曲率(Hessian)来加速并稳定迭代。但二阶模型只在局部可靠,如何控制这种局部近似的可信范围,正是本文的核心关切。
方法核心:信赖域框架的Wasserstein迁移
论文将经典数值优化中的信赖域方法(trust-region optimization)系统地搬到了Wasserstein测度空间。信赖域方法的基本哲学是:在当前点周围设定一个"信得过"的区域,在该区域内用二次模型近似目标函数并求解,再根据实际下降与预测下降的比值来决定是否接受这一步以及如何调整信赖域半径。
该方法在Wasserstein空间上的具体构造包含几个关键组件:
沿推前曲线的二次模型
方法沿推前曲线(pushforward curves)构造二次模型,用一个显式的自伴随二阶变分算子来刻画能量在测度空间中的曲率。这使得二阶信息能够以数学上严谨的方式嵌入迭代过程。
推前曲线(pushforward curves)是Wasserstein空间中连接两个测度的自然路径构造方式:给定参考测度 $\rho$ 和传输映射 $T$,可定义曲线 $\rho_t = ((1-t)\text{id} + tT)_# \rho$,即沿直线插值映射的推前(pushforward)测度族。在 $t=0$ 处,这条曲线的切向量恰好是 $T - \text{id}$,对应Wasserstein空间中的"位移"方向。沿此类曲线对能量做Taylor展开,可以提取出一阶梯度和二阶Hessian算子,从而为构造二次近似模型提供几何上一致的基础。与欧氏空间不同,这里的Hessian是作用在 $L^2(\rho)$ 函数空间上的自伴随算子,其谱性质直接影响信赖域子问题的求解难度。
L²步长半径与Steihaug-Toint子求解器
信赖域的"半径"用 $L^2(\rho)$ 范数定义,衡量步长的大小。子问题——即在信赖域约束下最小化二次模型——通过Steihaug-Toint子求解器求解。这是数值优化中处理大规模信赖域子问题的成熟工具,此处被适配到了测度空间的内积结构中。
Steihaug-Toint方法是求解大规模信赖域子问题 $\min_{|s| \leq \Delta} m(s) = g^\top s + \frac{1}{2} s^\top B s$ 的经典算法,其核心思想是在共轭梯度(CG)迭代过程中监测是否触碰信赖域边界:若CG方向遇到负曲率或步长越界,则沿当前方向做精确线搜索至边界后终止,否则继续迭代至收敛。这一方法避免了对Hessian做完整特征分解,每次迭代代价仅为一次矩阵-向量乘积,特别适合大规模或算子形式的Hessian。在Wasserstein空间中,"矩阵-向量乘积"被推广为二阶变分算子作用于 $L^2(\rho)$ 中的函数,从而保留了该算法的计算高效性。
比值测试与半径更新
每一步迭代都通过一个比值测试(ratio test)判断:若实际能量下降与模型预测下降足够吻合,则接受该步并可能扩大信赖域;否则拒绝并收缩半径。这一机制保证了即便二次模型在某些区域失真,整体迭代仍然可控。
Wasserstein空间(又称最优传输空间)是由具有有限二阶矩的概率测度构成的度量空间,其距离由最优传输代价(即2-Wasserstein距离)定义:$W_2(\mu,\nu)^2 = \inf_{\gamma \in \Pi(\mu,\nu)} \int |x-y|^2 , d\gamma(x,y)$,其中下确界取遍所有边际分布为 $\mu$ 和 $\nu$ 的耦合。这一空间天然携带黎曼流形结构——切空间由 $L^2$ 梯度向量场构成,梯度流对应偏微分方程(如Fokker-Planck方程)。正是这种几何结构使得经典欧氏空间的优化理论可以向测度空间迁移,但曲率、约束等概念需要仔细重新定义,这也是将信赖域方法推广至此的技术难点所在。
理论保证:收敛性与复杂度分析
论文在两类假设下给出了严格的收敛结果,这是该工作最具分量的部分。
在能量存在下界且势能与相互作用核的Hessian全局有界的条件下,作者证明了三条关键性质:目标能量单调不增、Wasserstein梯度范数收敛至零,以及在 $O(\varepsilon^{-2})$ 次外层试探(包含被拒绝的试探在内)之内即可达到 $\varepsilon$-稳定点。这个复杂度量级与经典非凸优化中信赖域方法的结果一致,说明Wasserstein空间的推广没有付出额外的收敛代价。
更进一步,若势能满足二次强制性(quadratically coercive)条件,则每一个弱聚点都是稳定点。这一分析对任意具有有限二阶矩的初始测度都成立,适用范围相当宽泛。
一个值得关注的结论是针对经验测度(empirical measures)的情形:此时整个迭代退化为 $L^2(\rho_N)$ 内积下的有限维信赖域方法,而当初始目标间隙一致有界时,复杂度常数与粒子数和维度均无关。这意味着方法在大规模粒子系统或高维问题中具备良好的可扩展性潜力,不会因为粒子增多或维度升高而显著劣化。
数值实验:从软粒子能量到MMD最小化
论文的实验部分覆盖了多个有代表性的场景,用以验证方法的实际表现:
- 光滑软粒子能量(smooth soft-particle energy):这是粒子相互作用建模的典型测试问题;
- 最大均值差异(MMD)最小化:针对非高斯目标分布的逼近任务,MMD是机器学习中常用的分布距离度量;
- 组件消融实验:逐一验证二次模型、信赖域半径、子求解器等各组件对整体性能的贡献;
- 规模扩展研究:在粒子数和维度两个方向上测试方法的扩展性。
这些实验的设计思路清晰——既有物理建模背景的能量最小化问题,也有机器学习语境下的分布逼近任务,同时通过消融与扩展研究印证了理论分析中关于复杂度不依赖粒子数与维度的论断。
最大均值差异(Maximum Mean Discrepancy,MMD)是一种基于再生核希尔伯特空间(RKHS)的概率分布距离度量,定义为 $\text{MMD}^2(\mu,\nu) = \mathbb{E}{x,x'\sim\mu}[k(x,x')] - 2\mathbb{E}{x\sim\mu,y\sim\nu}[k(x,y)] + \mathbb{E}_{y,y'\sim\nu}[k(y,y')]$,其中 $k$ 为正定核函数(如高斯核)。MMD最小化在生成模型(如MMD-GAN)、变分推断以及粒子方法中被广泛用作分布逼近目标。对于经验测度,MMD具有可微的封闭形式梯度,天然契合粒子系统中的势能-相互作用能量框架,因此成为验证Wasserstein信赖域方法在机器学习场景下适用性的典型基准。
意义与定位
这项工作的价值在于,它把成熟的二阶优化技术与Wasserstein几何这一现代概率建模的核心工具做了严谨的结合。相比纯一阶的Wasserstein梯度流方法,信赖域框架提供了对局部近似可靠性的显式控制,在非凸能量景观中更具稳健性。而理论上关于复杂度与粒子数、维度无关的结论,则为该方法应用于大规模采样、生成建模和粒子系统模拟留下了想象空间。
对于关注最优传输、变分推断以及粒子方法的研究者而言,这是一篇在算法设计与收敛理论两方面都做得较为完整的工作。
相关推荐

Rysh Forge 实测:一份 OpenAPI 规范自动生成 Claude 可调用的 Agent 工具
Rysh Forge 用一条命令把 OpenAPI 规范自动转换成 Claude 可调用的 Agent 工具,同时生成 MCP server、Python SDK 和文档,并对写操作强制人工确认,实现全链路可观测。本文解析其工作流与价值。

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。