WavePrune:RoPE只用一个旋转周期,长文本性能反而更好

WavePrune将RoPE每通道限制在首个旋转周期内,无需微调即可消除位置混叠并提升长文本性能与推理速度。
WavePrune是一种针对旋转位置编码(RoPE)的改进方法,其核心发现是:RoPE的周期性旋转结构会导致"位置混叠"——相差整数个旋转周期的位置对在注意力计算中难以区分,形成噪声干扰。为此,WavePrune将每个频率通道的注意力范围限制在其第一个旋转周期内,从结构上消除这种混叠。该方法无需重新训练,即插即用;在HELMET长文本基准上,五个测试模型中四个性能提升,Qwen3-8B提分达4.3点。从零预训练时同样改善了长度外推能力。此外,通道级滑动窗口引入的细粒度稀疏性,配合专用CUDA内核,在32K上下文下实现了相比FlashAttention-2约1.15倍预填充和1.24倍解码加速。这项工作挑战了"RoPE周期结构不可或缺"的共识,为位置编码研究提供了新视角。
RoPE的周期性问题被重新审视
旋转位置编码(Rotary Position Embedding,RoPE)是当前大语言模型处理位置信息的主流方案。它的核心思路是把查询(query)和键(key)向量的每个二维通道按照特定频率进行旋转,从而让注意力分数对位置的整体平移保持不变。这种设计优雅地解决了相对位置建模的问题,也被业界普遍认为是不可或缺的。
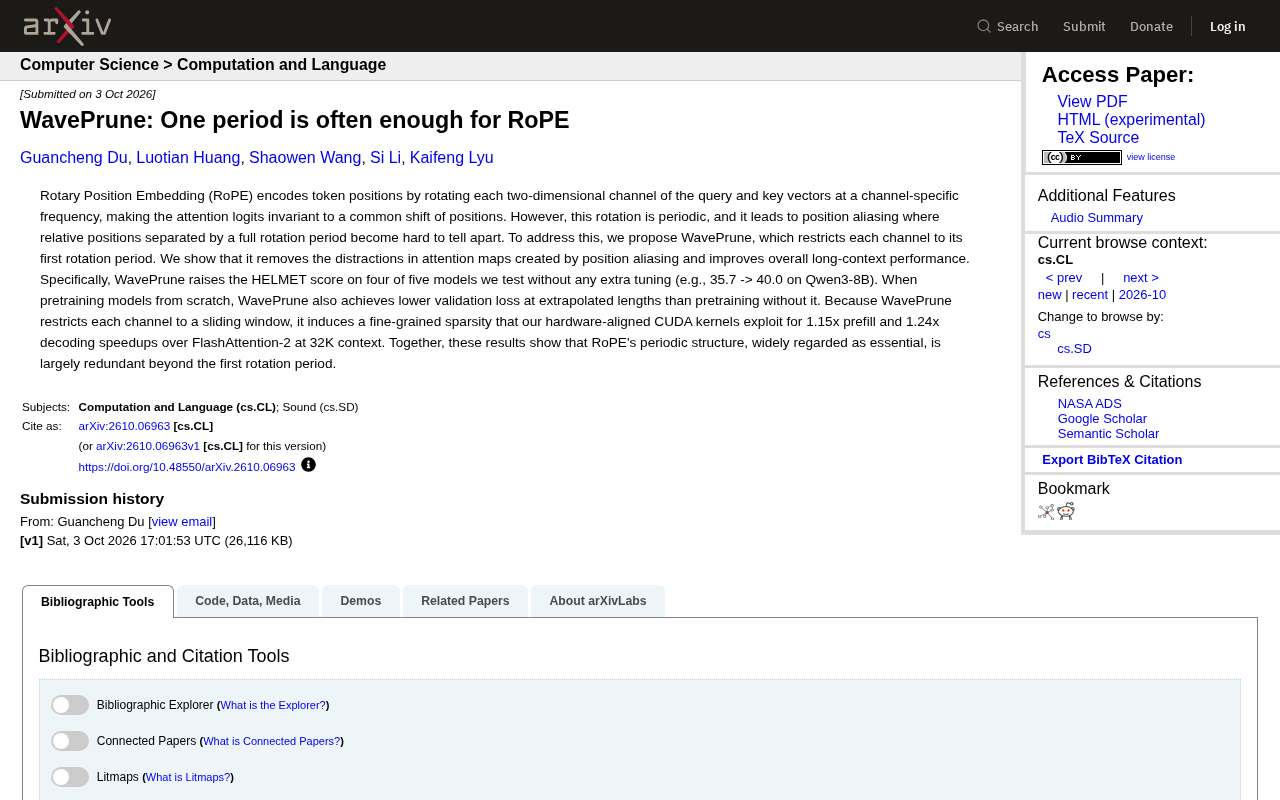
但一篇名为《WavePrune: One period is often enough for RoPE》的arXiv新论文提出了一个值得深思的观点:RoPE的旋转是周期性的,这会带来一个被忽视的副作用——位置混叠(position aliasing)。当两个相对位置恰好相差一个完整的旋转周期时,它们在旋转后的表现会变得难以区分,模型因此会在注意力图中产生干扰。
换句话说,RoPE引以为傲的周期结构,可能在第一个旋转周期之外是冗余甚至有害的。
RoPE最早由Su等人在2021年提出,其数学本质是将位置信息编码为复数域上的旋转操作。具体而言,对于位置 $m$ 处的查询向量,每个二维通道 $(q_{2i}, q_{2i+1})$ 会被乘以旋转矩阵 $\begin{pmatrix}\cos(m\theta_i) & -\sin(m\theta_i)\ \sin(m\theta_i) & \cos(m\theta_i)\end{pmatrix}$,其中 $\theta_i = 10000^{-2i/d}$ 是与维度相关的频率参数。当查询与键做点积时,两者的绝对位置抵消,仅保留相对位置 $(m-n)$ 的信息,这正是RoPE能建模相对位置的根源。由于不同通道使用不同频率,低维通道旋转快(高频),高维通道旋转慢(低频),形成类似傅里叶分析的多尺度结构。这套机制被LLaMA、Qwen、Mistral等主流模型广泛采用,并衍生出YaRN、LongRoPE等长度外推变体,是当前大语言模型架构中位置编码的事实标准。
WavePrune的核心思路:裁掉多余的周期
论文提出的方法叫WavePrune,思路相当直接:把每个通道限制在它的第一个旋转周期内。
这背后的逻辑是,既然超过一个周期之后会出现位置混叠,不如干脆只保留第一个周期的信息。对于高频通道来说,它们的旋转周期短,意味着只能覆盖较近的相对位置;而低频通道周期长,能覆盖更远的距离。通过为每个通道设置对应其周期长度的有效窗口,WavePrune实际上为不同频率的通道分配了不同的"可见范围"。
这样做带来的直接效果是,注意力图中由位置混叠造成的干扰被消除了,模型对长上下文的整体理解能力随之提升。
不需要额外微调的性能提升
论文给出的实验数据颇具说服力。在HELMET长文本评测基准上,WavePrune在测试的五个模型中有四个取得了分数提升,而且完全不需要任何额外的调优。其中一个典型例子是Qwen3-8B,HELMET分数从35.7提升到40.0,提升幅度相当可观。
这种"即插即用"的特性意味着现有模型可以在推理阶段直接应用WavePrune,无需重新训练,实用价值很高。
位置混叠(position aliasing)是一个来自信号处理领域的概念。在采样理论中,若采样频率不足,不同频率的信号会叠加混淆,导致无法区分——这被称为混叠(aliasing)。RoPE中的类似问题是:假设某通道的旋转周期为 $T$,那么相对距离为 $d$ 和 $d+T$ 的两个位置对,其旋转角之差完全相同,注意力分数因此无法区分这两种情况。对于高频通道(周期短),这一问题在较近的距离内就会发生;对于低频通道(周期长),则要在非常长的序列中才会出现。WavePrune的关键洞察在于,与其让模型在训练中自行学会忽略这种周期性混淆,不如从结构上阻止超出一个周期的注意力计算,从根本上消除混叠噪声的来源。
从零预训练也能受益
除了对现有模型的增强,论文还验证了WavePrune在从头预训练场景下的表现。结果显示,使用WavePrune预训练的模型,在**外推长度(extrapolated lengths)**上的验证损失低于不使用它的基线模型。
长度外推一直是长文本建模的难点——模型在训练长度内表现良好,但面对更长的序列时性能往往迅速下降。WavePrune通过限制通道的有效范围,似乎缓解了这一问题,让模型在超出训练长度时也能保持更稳定的表现。
长度外推(length extrapolation)是指模型处理超过其训练时最大序列长度的文本的能力。由于Transformer的注意力机制本身不限制序列长度,理论上可以处理任意长度的输入,但实践中性能往往在超出训练长度后急剧下降。这主要源于两方面原因:其一,训练中未见过的位置编码值会使模型产生分布外(out-of-distribution)的输入;其二,超长距离的注意力权重在训练中从未得到有效学习。为此学界提出了ALiBi、YaRN、动态NTK缩放等多种改进方案,通过修改位置编码的频率或衰减方式来改善外推能力。WavePrune从另一个角度切入——通过消除通道内的周期冗余,使每个通道的有效作用范围更加明确,从而减少模型在处理超长序列时面临的歧义,这与现有外推方法的思路形成了有趣的互补。
顺带带来的硬件加速
一个有趣的副产品是性能加速。由于WavePrune把每个通道限制在一个滑动窗口内,这天然引入了一种细粒度的稀疏性(fine-grained sparsity)——每个通道只需要关注窗口内的位置,窗口外的计算可以直接跳过。
论文作者为此设计了硬件对齐的CUDA内核来充分利用这种稀疏结构。在32K上下文长度下,相比FlashAttention-2,WavePrune实现了1.15倍的预填充(prefill)加速和1.24倍的解码(decoding)加速。
这意味着WavePrune不仅提升了模型质量,还顺带降低了推理成本,这在长文本推理日益普遍的今天是一个相当实在的收益。
FlashAttention-2是目前工业界最广泛使用的注意力计算加速方案,由Tri Dao等人提出,通过将注意力矩阵分块(tiling)计算并利用GPU高速缓存(SRAM)减少HBM显存读写,从而在不改变计算结果的前提下显著降低内存占用和提升吞吐量。它是密集注意力(dense attention)的高效实现,对于全局注意力模式已经足够优化。WavePrune引入的细粒度稀疏性则提供了FlashAttention-2无法利用的进一步优化空间——由于不同通道的有效窗口大小不同且较小,大量注意力位置对的计算可以被直接跳过,而非像稀疏注意力(sparse attention)那样以固定步长跳过整行/整列。这种通道级别的非均匀稀疏结构需要专门设计CUDA内核才能充分发挥,这也是论文额外贡献的工程工作的意义所在。
对RoPE设计思路的重新思考
这篇论文最有价值的地方,或许不在于具体的性能数字,而在于它对一个"常识"提出的挑战。RoPE的周期性结构长期被视为其设计的精髓,但WavePrune的实验表明,这种周期性在第一个旋转周期之外在很大程度上是冗余的。
这为位置编码的研究提供了一个新的视角:与其追求更复杂的位置建模机制,也许更应该关注如何去除现有机制中的干扰因素。对于关注长文本能力和推理效率的研究者和工程师来说,WavePrune提供了一个值得尝试的方向。
需要说明的是,本文基于论文摘要整理,具体的实现细节、消融实验以及在更广泛模型上的泛化能力,还需参考完整论文和后续的社区验证。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。