Weave Router 2.0:跨订阅智能路由的编程助手调度器
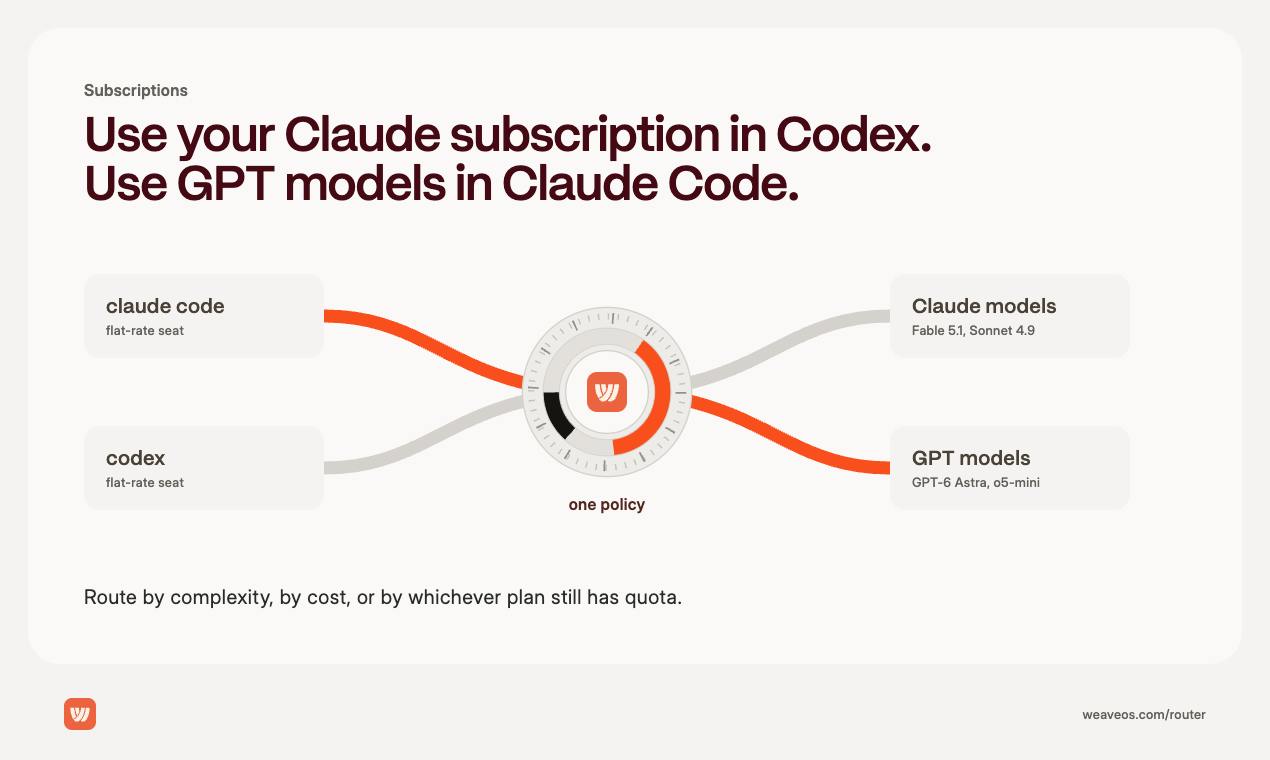
Weave Router 2.0 可跨 Claude/Codex/GPT 订阅智能调度编程请求,官称成本减半、速度翻倍。
Weave Router 2.0 是一款「订阅感知」的 AI 编程助手路由器,登顶 Product Hunt 榜首。它的核心价值在于打通多家 AI 服务的订阅壁垒,通过任务复杂度分类器为每个请求匹配「能把它做对的最便宜模型」,同时利用「ache-aware 代价感知切换」机制,只有在切换收益超过上下文重建成本时才真正执行模型切换,避免无谓中断工作流。官方宣称在 Terminal-Bench 4.0 和 SWE-Atlas 上可对标 GPT-6 Astra,且成本减半、速度翻倍,但这些数字尚无第三方独立验证。该工具以开源形式发布,最适合同时订阅多家 AI 服务、对成本敏感的重度开发者,采用前需额外评估数据流向与隐私合规风险。
在 AI 编程助手日益普及的今天,开发者往往同时持有多个订阅——Claude、Codex、GPT 各有其长,但配额和成本的管理却成了新的痛点。刚刚登上 Product Hunt 榜首(127 票、排名 #1)的 Weave Router 2.0,正试图解决这个问题:它是一款「订阅感知」的编程助手路由器,能把每一次编码请求自动分发到当前最划算、且能把任务做对的模型上。
核心思路:让模型选择变成一个路由问题
Weave Router 2.0 的定位是「Subscription Aware Coding Agent Router」。它的关键能力在于打通不同厂商的订阅壁垒——你可以在 Codex 中调用 Claude 模型,也可以在 Claude Code 中调用 GPT 模型,全部基于你现有的付费计划,并被路由到「还有剩余配额」的那一个。
换句话说,它把「用哪个模型」从开发者的手动决策,变成了一个后台自动完成的路由问题。对于同时订阅多家服务、又经常撞到配额上限的重度使用者来说,这种跨订阅的弹性调度确实能减少中断和浪费。
性能主张:对标 GPT-6 Astra,成本减半、速度翻倍
据官方描述,Weave Router 2.0 在 Terminal-Bench 4.0 和 SWE-Atlas 两个基准上的表现,可以匹敌 GPT-6 Astra,但成本只有一半、速度快一倍。
这个「同等智能、更低成本」的组合,是它最核心的卖点。逻辑并不复杂:如果一个简单任务可以由更便宜的模型完成,就没必要动用最昂贵的旗舰模型;而只有在真正复杂的任务上,才把请求送给能力最强的模型。整体上,路由器通过为每个请求匹配「能把它做对的最便宜模型」,来压低平均成本。
需要提醒的是,这些性能数字目前来自厂商单方面的宣传,尚无第三方独立评测佐证,实际效果仍有待社区验证。
Terminal-Bench 和 SWE-Atlas 是近年兴起的面向「真实工程任务」的编程能力基准,有别于传统的代码补全准确率测试。Terminal-Bench 侧重在终端环境中完成多步骤命令行任务的能力,SWE-Atlas(以及其前身 SWE-bench)则聚焦于在真实 GitHub 仓库中定位并修复 issue 的端到端能力,被视为衡量编程 Agent 实际可用性的重要指标。值得注意的是,厂商自报基准成绩存在「评测集过拟合」或「有利条件设置」的风险——评测时选用的模型组合、温度参数、上下文长度等均可影响结果。GPT-6 Astra 目前也并非被广泛测试的公开可用模型,这使得对标数字的可复现性存疑,读者在参考时应保持审慎。
两项关键技术:复杂度分类器与「ache-aware」切换
Weave Router 2.0 的路由决策由两个机制驱动:
任务复杂度分类器
一个新的分类器会为每个编码任务的复杂度打分。分数决定了这个请求「配得上」哪个档位的模型——简单的改动交给轻量模型,架构级或高难度的问题才升级到更强的模型。这是实现「按需分配算力」的前提。
任务复杂度分类(Task Complexity Classification)在 LLM 路由领域并非全新概念。学术界和工业界此前已有 RouteLLM、FrugalGPT 等研究,核心思路都是训练一个轻量级的「门控模型」,在真正调用大模型之前先对输入进行难度评估。常见的特征维度包括:token 数量、涉及的编程语言或框架、是否包含跨文件依赖、需要推理的步数等。分类器本身通常是一个小型分类网络或经过微调的小参数量模型,推理成本极低。Weave Router 2.0 的分类器具体训练数据和架构尚未公开,这也是外部难以验证其路由决策质量的原因之一——分类器的准确率直接决定了「把简单任务误判为复杂任务」或反向误判的概率,进而影响最终的成本与质量表现。
Ache-aware 切换
更有意思的是它所谓的「ache-aware switching」(可理解为「代价感知切换」)。路由器不会盲目地为了省钱而频繁切换模型,只有当切换带来的节省超过重建上下文的成本时,才会真正执行切换。
这一点直击了多模型协作的现实难题:切换模型意味着丢失原有的上下文,需要重新建立对话状态,这本身是有代价的。Weave Router 把这种「重建成本」纳入决策,避免了为省小钱而反复打断工作流的短视行为,是设计上比较克制、务实的一笔。
「上下文重建成本」是多模型协作中被低估的隐性开销。在对话式编程助手场景下,模型的有效工作依赖于已积累的上下文窗口——包括代码库结构、当前任务目标、已完成步骤以及中间产生的文件变更。切换到另一个模型时,这些状态需要通过 prompt 重新注入,不仅消耗额外 token,还可能因新模型对上下文的理解偏差而引入错误。「ache-aware」(代价感知)这一命名借鉴了操作系统调度领域「cache-aware」的思想:就如同进程切换会导致 CPU 缓存失效(cache miss),模型切换也会导致「上下文缓存」失效。将这种切换代价量化并纳入路由决策,是让路由器在实际工程场景中真正可用的关键设计,而非仅在孤立的单次请求上做成本优化。
谁适合用,谁需要谨慎
Weave Router 2.0 归属于 Product Hunt 的 Open Source、Developer Tools 与 Artificial Intelligence 分类,由 Adam Cohen、Andrew Churchill、Brennan Lupyrypa、Drew Bailey 和 Steven 等人打造。作为开源工具,它对愿意折腾配置、且手握多个 AI 订阅的开发者尤其友好。
它最能打动的人群,是那些:
- 同时订阅了 Claude、Codex、GPT 等多家服务,经常撞配额的人;
- 对 AI 编程支出敏感、希望自动化控制成本的团队;
- 愿意接受「模型由路由器决定」而非手动指定的工作方式。
而对成本不敏感、或坚持只用单一顶配模型的用户来说,这类路由器的价值就会大打折扣。此外,把请求在不同厂商模型间转发,也涉及数据流向与隐私合规问题,团队在采用前应做好评估。
小结
Weave Router 2.0 代表了 AI 编程工具的一个新方向:当模型越来越多、订阅越来越碎片化,「智能调度」本身就成了一种价值。它用复杂度分类和代价感知切换,把「省钱」和「做对」这两个常常矛盾的目标结合起来。至于官方宣称的「成本减半、速度翻倍」是否经得起真实项目的检验,还需要更多开发者上手后给出答案。
相关推荐
AI Agent审批工作流:如何处理编辑与重试
详解AI Agent人工审批工作流的设计要点:如何审阅精确请求、恢复执行,以及处理编辑与重试。以Airlock为例,探讨Agent走向生产环境所需的安全与可控机制。
MCP授权治理:为什么工具调用需要超越OAuth的安全防线
MCP工具调用为何需要超越OAuth的授权治理?本文解析工具权限的执行位置、请求内容检查与数据泄露测试,并介绍Airlock如何为AI代理的工具调用建立分层安全防线。
如何区分AI Agent流量与真实用户流量
AI Agent流量正被访问日志误记为真实用户行为。本文解读如何通过身份声明机制区分Agent流量与用户流量,帮助开发者与平台还原真实数据、优化风控策略。