微调LLM还需要人类可读文本吗?DASA给出否定答案
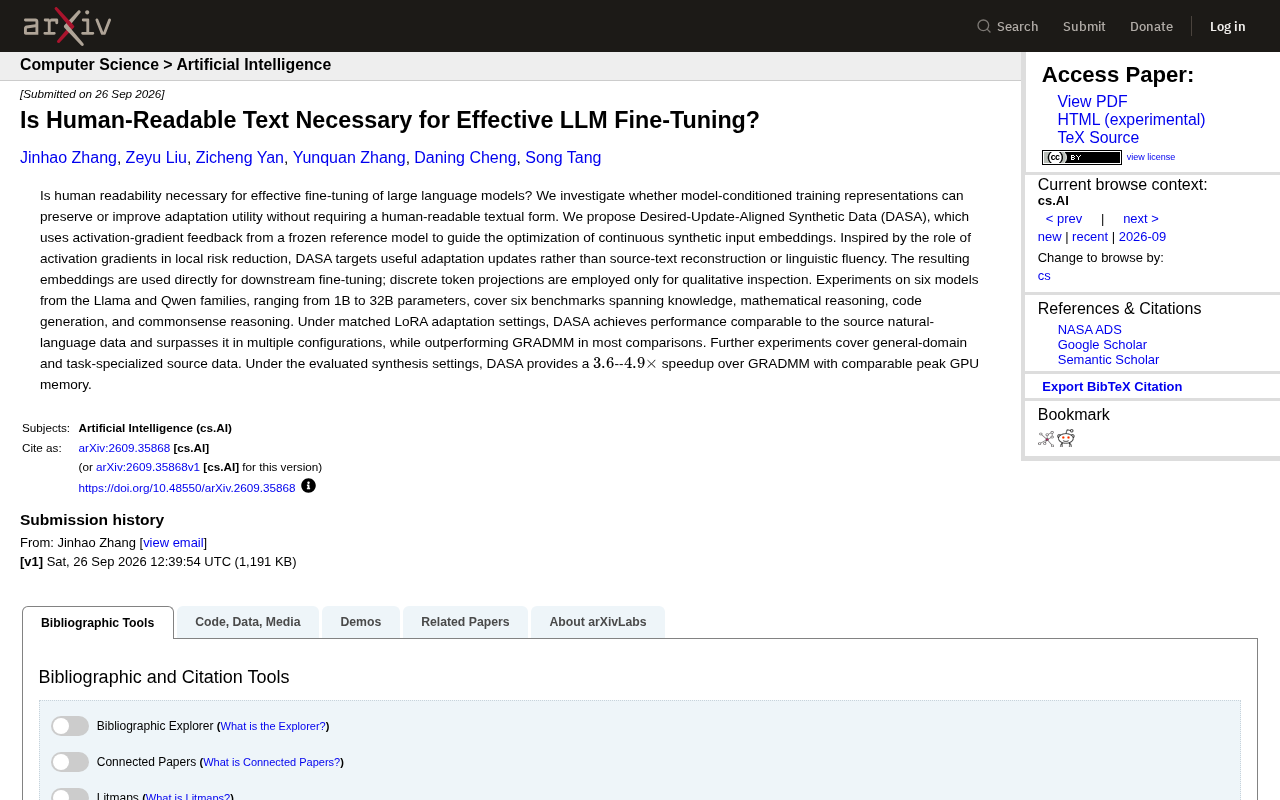
DASA用连续合成嵌入替代自然语言文本进行LLM微调,效果追平甚至超越原始文本数据,速度提升近5倍。
DASA(Desired-Update-Aligned Synthetic Data)是一种颠覆传统假设的LLM微调方法。它放弃了"训练数据必须是人类可读文本"的默认前提,转而在连续嵌入空间中直接优化合成输入——以冻结参考模型的激活梯度反馈为导向,让合成数据对齐"期望的参数更新方向",而非追求语言流畅性。在Llama与Qwen两大模型家族的6个模型(1B至32B参数)、6类基准任务上,DASA在统一的LoRA适配框架下性能追平甚至多次超越原始自然语言数据,并相比基线方法GRADMM实现3.6–4.9倍加速。这项研究的深层意义在于:它挑战了LLM工程实践中长期沿袭的数据形式默认设定,同时也暴露出合成数据可解释性不足、治理难度增加等新挑战。
一个被忽视的假设:微调数据必须是文字吗?
长期以来,大语言模型(LLM)的微调建立在一个默认前提之上——训练数据应当是人类可读的自然语言文本。无论是指令微调还是领域适配,我们都在用一句句可理解的句子喂给模型。但一篇新发布的 arXiv 论文(arXiv:2609.35868)提出了一个尖锐的问题:人类可读性对于有效的微调而言,真的是必要的吗?
研究者的答案是:不一定。他们提出的方法名为 DASA(Desired-Update-Aligned Synthetic Data,期望更新对齐的合成数据),直接绕开了"文本必须能被人读懂"这一约束,转而优化一组连续的合成输入嵌入(embeddings),并将其直接用于下游微调。
DASA 的核心思路:对齐"期望更新"而非重建文本
从文本重建转向梯度对齐
传统的合成数据方法(例如文中作为对比基线的 GRADMM)往往试图重建源文本,或追求语言的流畅性。DASA 的设计哲学完全不同——它不关心生成的内容是否像人话,只关心这些数据能否驱动模型产生有用的适配更新。
具体来说,DASA 借助一个冻结的参考模型(frozen reference model)提供的激活梯度反馈(activation-gradient feedback),来引导连续合成输入嵌入的优化。这一思路受到激活梯度在"局部风险降低"中作用的启发:与其让合成数据去还原源文本,不如让它直接瞄准那些能带来性能提升的更新方向。
激活梯度(activation gradient)是理解这一方法的关键概念。在神经网络反向传播过程中,梯度描述了损失函数相对于各层参数或激活值的变化方向。当我们说某组数据能够产生"有用的梯度",意味着用这些数据训练时,模型参数会朝着降低目标损失的方向移动。DASA 的核心洞察是:既然微调的本质是通过梯度更新参数,那么合成数据的好坏应直接以"产生的梯度是否与期望更新方向对齐"来衡量,而非以"文本是否流畅可读"来衡量。冻结参考模型(frozen reference model)在此充当"方向标"——它的激活梯度代表了理想的更新信号,优化过程让合成嵌入不断逼近这一信号,整个流程完全在连续向量空间中进行,跳过了将嵌入解码为离散词语的步骤。
嵌入直接参与训练,文本只用于"看一眼"
在 DASA 的流程中,优化得到的嵌入被直接用于下游微调。而将这些连续嵌入投影回离散 token 的操作,仅仅用于定性检查(qualitative inspection)——也就是让研究者看看这些嵌入"长什么样",而非作为训练输入。这意味着人类可读的文本形式在整个训练链路中被彻底解耦出去。
连续嵌入(continuous embeddings)与离散 token 的区别值得在此说明。大语言模型的输入通常经过两步处理:先将文字切分为离散的 token(如词或子词),再通过嵌入层映射为连续的高维向量。传统微调的数据始于离散 token,而 DASA 直接在嵌入空间中优化,跳过了"必须先有离散词语"这一环节。这些优化后的嵌入向量在数值上合法,模型可以正常处理,但它们未必对应任何真实词语,或者即使强行投影回最近邻 token 也可能呈现为语义混乱的字符串。正因如此,"投影回离散 token 仅用于定性检查"这一设计选择揭示了方法的本质:可解释性从一开始就不在优化目标之内。
实验规模与结果:追平甚至超越自然语言数据
覆盖 6 个模型、6 类基准
这项研究的实验设计相当扎实。作者在 Llama 和 Qwen 两大模型家族的 6 个模型上进行验证,参数规模从 1B 一直覆盖到 32B。评测基准同样广泛,涵盖六个方面:
- 知识类任务
- 数学推理
- 代码生成
- 常识推理
在统一的 LoRA 适配设置下,DASA 展现出令人意外的表现。
LoRA(Low-Rank Adaptation)是本文实验的统一适配框架,理解它有助于评估结果的适用范围。LoRA 是目前最主流的参数高效微调(PEFT)方法之一:它冻结预训练模型的原始权重,仅在特定层的权重矩阵旁注入低秩可训练矩阵,从而大幅降低微调所需的可训练参数量(通常仅为全量微调的 0.1%–1%)。在 LoRA 框架下评估 DASA 意味着:合成嵌入数据驱动的是这些低秩适配矩阵的更新,而非全部参数。这一设置的普遍性较好——LoRA 及其变体(QLoRA 等)在学术界和工业界的 LLM 微调中被广泛采用,使得 DASA 的结论具有较强的现实参考价值。
性能与效率的双重优势
结果层面有两点值得关注:
性能上,DASA 达到了与源自然语言数据相当的水平,并在多个配置中反超了原始文本数据;同时在大多数对比中优于基线方法 GRADMM。换句话说,抛弃人类可读性不仅没有损失效果,某些情况下反而更好。
效率上,在所评估的合成设置下,DASA 相比 GRADMM 提供了 3.6 到 4.9 倍的加速,且峰值 GPU 显存占用相当。对于计算资源紧张的微调场景,这一效率提升具有实际意义。
此外,论文还补充了在通用领域数据和任务专精数据上的实验,进一步验证了方法的适用范围。
这项研究意味着什么?
重新审视"数据"的定义
DASA 最具启发性的地方,在于它挑战了一个几乎从未被质疑的假设。当我们谈论"训练数据"时,脑海中浮现的总是文本、句子、语料库。但从模型优化的本质看,模型学习的是参数更新的方向,而承载这一方向的载体未必需要是人类语言。连续嵌入或许是一种更"贴近模型"的信息表示形式。
潜在价值与开放问题
如果这一方向成立,可能带来若干实际影响:合成数据的生成效率更高、可能规避部分与文本版权或隐私相关的问题、以及为数据蒸馏提供新思路。
不过也需保持审慎。将嵌入投影回 token 仅用于"定性检查",恰恰说明这些合成数据缺乏可解释性——我们难以直观理解模型到底学到了什么。在需要审计和可控性的场景中,这种"黑箱式"的合成数据可能带来新的治理挑战。此外,论文的结论限定在"所评估的合成设置"之下,其泛化性仍有待更大范围的复现。
总体而言,这是一篇提出了好问题并给出扎实初步证据的工作。它提醒我们,在 LLM 的工程实践中,许多沿袭已久的默认设定或许都值得重新推敲。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。