微调嵌入模型没那么难:EmbeddingGemma 2 实战全解

用LoRA对EmbeddingGemma 2微调,几分钟内让多模态检索在自有数据上显著提升,但泛化能力有限且影响共享主干。
本文通过两个实际实验,系统演示了如何用多重负样本排序损失和LoRA对开源多模态嵌入模型EmbeddingGemma 2进行低成本微调。核心发现是:同批次其他样本可自动充当负样本,无需人工标注;用不到2%的可训练参数,在A100上训练约7分钟,日常声音分类准确率从25%提升到66%,YouTube字幕搜索首位命中率从约67%提升到约75%。但实验也揭示了两个重要局限:模型学到的是具体标签而非通用能力(从未训练的10种声音完全未改善),以及多模态共享主干导致通用文本搜索下降约4分。文章总结了三条实用建议:整理数据对并避免批内重复、按来源切分测试集、微调后全面检测其他模态。
开箱即用的嵌入模型只认识它训练时见过的通用数据,对你的内部文档、产品命名或应用场景里的特定声音一无所知。而 EmbeddingGemma 2 作为一个优秀的多模态检索开源模型,最大的价值在于——你可以用自己的数据对它进行微调。一位 YouTube 技术创作者在实测中证明:几分钟的微调,就能让模型在你自己的数据上明显变好,而且几乎不破坏它原有的能力。
嵌入模型微调与 LLM 微调的本质差异
理解微调嵌入模型,先要搞清楚它和微调大语言模型的根本区别。微调 LLM 时,你给模型一个输入和一段你希望它逐字写出的目标文本,训练数据里已经包含了「正确答案」。
但嵌入模型什么文字都不输出,它只是把输入转换成一串数字(向量),而这些数字唯一的意义在于它们彼此之间的相对关系——这就是人们常说的「嵌入空间」。因此根本不存在一个可以当作目标写下来的「正确向量」。你能告诉模型的,只有「哪些东西应该彼此靠近」。
这就改变了训练数据的形态。假设你为一家智能家居公司做客服,想做一个能从帮助中心回答客户问题的搜索框。每条训练样本就是一对:一个客户问题,和一段能回答它的文档。你不需要打分,也不需要标注错误答案,只需要「属于彼此」的问题和段落。
「嵌入空间」(embedding space)是理解这一切的基础概念。嵌入模型把任意输入——文字、图片、声音——映射成一个高维向量,通常是几百到几千维的浮点数数组。这个向量本身没有可读意义,但它在空间中的位置编码了语义:意思相近的内容被映射到相邻区域,意思无关的内容被推到远处。衡量两个向量是否「靠近」,通常用余弦相似度——计算两个向量夹角的余弦值,1 表示完全一致,0 表示正交,-1 表示完全相反。微调嵌入模型的本质,就是在不破坏整体空间结构的前提下,把你关心的那部分数据的聚集方式调整得更符合你的业务逻辑。
免费的负样本:多重负样本排序损失
仅仅把问题拉向它对应的段落还不够,因为模型可以把所有东西都塞到同一个点上照样得高分。关键在于模型如何学会「推开什么、拉近什么」。
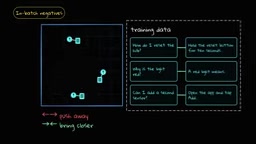
训练时模型一次处理一批数据对,比如一批 32 对。对每个问题来说,它对应的段落是正确答案,而这一批里其他所有段落都被当作错误答案。这意味着你根本不用手动收集负样本——负样本自动就有了。损失函数把每个问题拉向自己的段落,同时推开其余所有段落,于是你不用标注一个负样本就免费获得了「错误答案」。
最直观的类比是一道选择题,同一批里的其他数据对就是干扰项。在 sentence-transformers 里,这叫「多重负样本排序损失」(multiple negatives ranking loss),和 CLIP 把图像与文本放进同一空间用的是同一个思路。
别踩重复样本的坑
这里有个陷阱:如果两个客户都问同一个重置流程,两对数据恰好落进同一批,损失函数会把第二份相同段落当成第一个问题的错误答案——等于在教模型「正确答案是错的」。解决办法是用一个永远不把同一段文本放进同一批的批次采样器,sentence-transformers 称之为 no-duplicate sampler。
提示词模板必须训练与推理一致
第二个要点是提示词。EmbeddingGemma 2 要求搜索查询前加一个简短的任务提示,文档则用「标题+正文」格式。你训练时用什么格式,生产代码就必须用什么格式——就像用于大语言模型的 prompt 模板一样,训练时的模板和推理时的模板必须完全一致。
多重负样本排序损失(Multiple Negatives Ranking Loss,MNRL)的数学直觉源自对比学习(contrastive learning)框架。给定一批 N 对数据,每个查询 q_i 和其对应文档 d_i 构成正例,而同批内其余 N-1 个文档 d_j(j≠i)则构成「批内负例」(in-batch negatives)。损失函数要求模型给正例打出高于所有负例的相似度分数,具体实现上通常用交叉熵:把相似度得分做 softmax,要求正例的概率最大化。这与 OpenAI CLIP 的训练目标完全同构——CLIP 同时在图像→文本和文本→图像两个方向上对称地计算损失。批次越大,负例越多,监督信号越强,这也是为什么大批量训练对嵌入模型效果格外显著。
LoRA 让训练又快又省
真正被训练的是什么?这是最有意思的部分。作者没有更新全部权重,而是用 LoRA——在现有层旁边加入小的可训练矩阵,原始权重保持冻结。LoRA 适配器训练极快,无需重训整个网络。在作者的实验里,可训练参数不到总权重的 2%,所以你只需保存一个很小的适配器文件,而不是整个模型的副本。
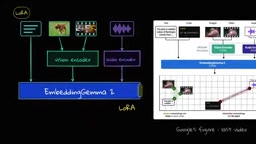
但有个值得警惕的点:EmbeddingGemma 2 的文本、图像、视频、音频都共用同一个主干网络。所以如果你在音频上训练主干,也会改变其他模态的表现——这个代价后面会用实验验证。
LoRA(Low-Rank Adaptation)的核心思想是:大模型预训练后,在下游任务微调时权重的实际变化量往往是低秩的(low-rank)。与其直接更新原始权重矩阵 W(维度可能是 4096×4096),不如在旁边插入两个小矩阵 A(4096×r)和 B(r×4096),其中 r 远小于 4096(如 r=8 或 r=16)。前向传播时输出变为 Wx + BAx,原始权重 W 保持冻结,只有 A 和 B 参与梯度更新。由于 r 很小,可训练参数量可以压缩到原来的 0.1%~2%,显存占用和训练时间大幅降低。训练完成后,LoRA 适配器可以与基础模型分开保存,也可以合并进原始权重,合并后推理速度与原模型完全相同,没有额外开销。
用对的方式衡量效果
训练损失下降只说明模型在它见过的样本上变好了,而你真正该关心的是它在没见过的问题上的搜索质量,否则就是过拟合。
做法是留一个测试集,并且按来源切分。如果同一篇文章的段落同时出现在训练集和测试集里,模型其实已经见过答案了。所以要按文章、按视频、按录音来切分。这也引出一个核心问题:模型究竟学到了一种通用技能,还是只记住了你给的标签?
实验一:日常声音分类从 25% 提升到 66%
作者在 Colab 的 A100 GPU 上,基于 Unsloth 的 EmbeddingGemma 2 notebook 跑了实验。第一个例子修复了上一期视频的弱项——识别日常声音。数据集用的是 ESC-50,包含 50 种日常声音的短片段,比如狗叫、下雨、电锯。
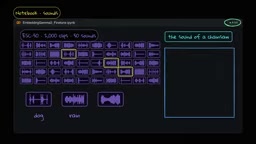
这里分类变成了搜索:模型对声音片段做嵌入,对标签句子做嵌入,训练后选最接近的那个。训练前,模型只有约四分之一的概率把正确声音排在第一,也就是 25% 左右的准确率,而模型自带的分类提示词表现更差。
训练对由「标签句子 + 音频片段」组成,这正是重复样本陷阱要命的地方——每个标签对应很多片段。作者给音频编码器和主干加上 LoRA,在 A100 上训练约七分半钟,模型在从未听过的片段上的首位命中率从约 25% 提升到了约 66%,像「刷牙」这类声音几乎每次都能正确识别。
它学会了「听」还是只记住了标签?
作者又做了一个关键实验:这次把 10 种声音完全从训练中剔除,再在这 10 种上测试。结果是——训练过的声音照常提升,但从未见过的 10 种声音完全没有变好。结论很清楚:模型学的是你给的标签,而不是通用的听觉能力。这意味着如果你微调自己的应用,每一个你在意的标签都必须出现在训练数据里,它不会自动泛化。
共享主干的代价与一个隐蔽的 Bug
微调付出了什么代价?作者加载带与不带适配器的完整模型,跑了三项检查:图片搜索、语音搜索、通用文本搜索。图片搜索和语音搜索完全没动,但通用文本搜索下降了约 4 分——这正是改动共享主干的代价。如果你的应用也依赖通用文本搜索,建议每次微调后都测一遍。
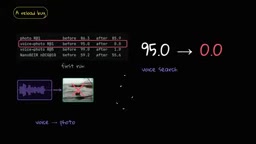
还有一个值得记录的坑:第一次检查时语音搜索几乎掉到零,看起来像模型彻底忘了语音。逐步排查后发现,适配器权重加载完全正确,问题出在和适配器一起保存的 processor——它把每段音频裁成了几毫秒,导致所有声音听起来都一样。修复只需一行代码:复用基础模型的 processor。所以如果你保存并重新加载音频适配器,重载后一定要再测一次。
实验二:把 YouTube 字幕变成可搜索的知识库
第二个例子更贴近实用。作者取了自己 120 个视频的字幕,切成短段落。由于没有现成问题,他用 Gemini 3 Flash 为每个段落生成一个「观众风格」的问题,得到了「问题—段落」数据对,正是前面讲的格式。然后按视频切分,测试问题来自模型没训练过的视频。
训练前,正确段落排在首位的概率约为三分之二;经过不到三分钟的训练,提升到约四分之三。通用文本搜索同样下降约 4 分,和声音实验的代价一致。最终效果就是视频开头演示的那个搜索框:你输入一个问题,它返回视频里讲到这件事的确切时刻,附带可点击的时间戳。要用在自己的数据上,你只需要一份同样格式的「问题 + 段落」文件。
用语言模型自动生成训练问题的做法,通常被称为「合成数据生成」(synthetic data generation)或「查询生成」(query generation),是嵌入模型微调中缓解标注成本的常见策略。其逻辑是:如果你有大量文档但缺乏真实用户查询,可以让一个能力较强的生成模型扮演「潜在用户」,为每段文档写出一个自然语言问题。生成质量越接近真实用户的表达习惯,微调效果越好。实践中需要注意生成问题的多样性——避免模型反复生成句式相同的问题,否则训练数据实际覆盖的语言模式会非常单一。此外,合成问题本身的质量上限受限于生成模型的理解能力,对于高度专业化的领域,仍建议混入一部分真实用户查询作为校准。
给想微调 EmbeddingGemma 2 的人的三条建议
答案很明确:几分钟的微调确实让模型在作者自己的声音和视频上明显变好,但它学到的是标签而非通用技能,并且在通用文本搜索上付出了几分代价。
如果你打算微调 EmbeddingGemma 2,作者建议聚焦三件事:
- 把数据整理成数据对,并确保同一批里没有重复,用 no-duplicate sampler 避免「教模型正确答案是错的」。
- 在它没见过的数据上测试,按来源切分训练集与测试集,才能分辨泛化与过拟合。
- 检查训练后还有什么被改变了,因为主干被所有模态共享,一个模态的微调可能影响其他模态。
这或许是你能对嵌入模型做的最实用的事情之一——用很小的成本,换来模型在自己专属数据上的显著提升。
相关推荐
实测Jev:只做决策不写文字的AI模型,比GPT便宜65倍
深度实测AI决策模型Jev:它不生成文本,只返回带概率的结构化决策,运行成本比GPT-5.5低65倍。通过工单路由、命令守卫、千条真实消息四项测试,解析其优势、局限与模型级联省钱策略。

MWE Emperor S2 评测:高度可调的全能工作站座椅
MWE Emperor S2 全能工作站座椅深度评测:电动可调显示器支架、多轴向人体工学调节、零重力后仰与多屏支持,适合长时间游戏与办公的重度用户。

田纳西州死刑执行失败:Christa Pike案与死刑制度之殇
田纳西州死刑犯Christa Pike在接受两剂致死注射后幸存,成为有史以来首例。Vox记者Pamela Koloff剖析这起执行失败案例背后,死刑制度在技术执行与司法公正上的深层问题。