大语言模型为何在表格预测上不敌XGBoost

引言:LLM并非万能预测工具
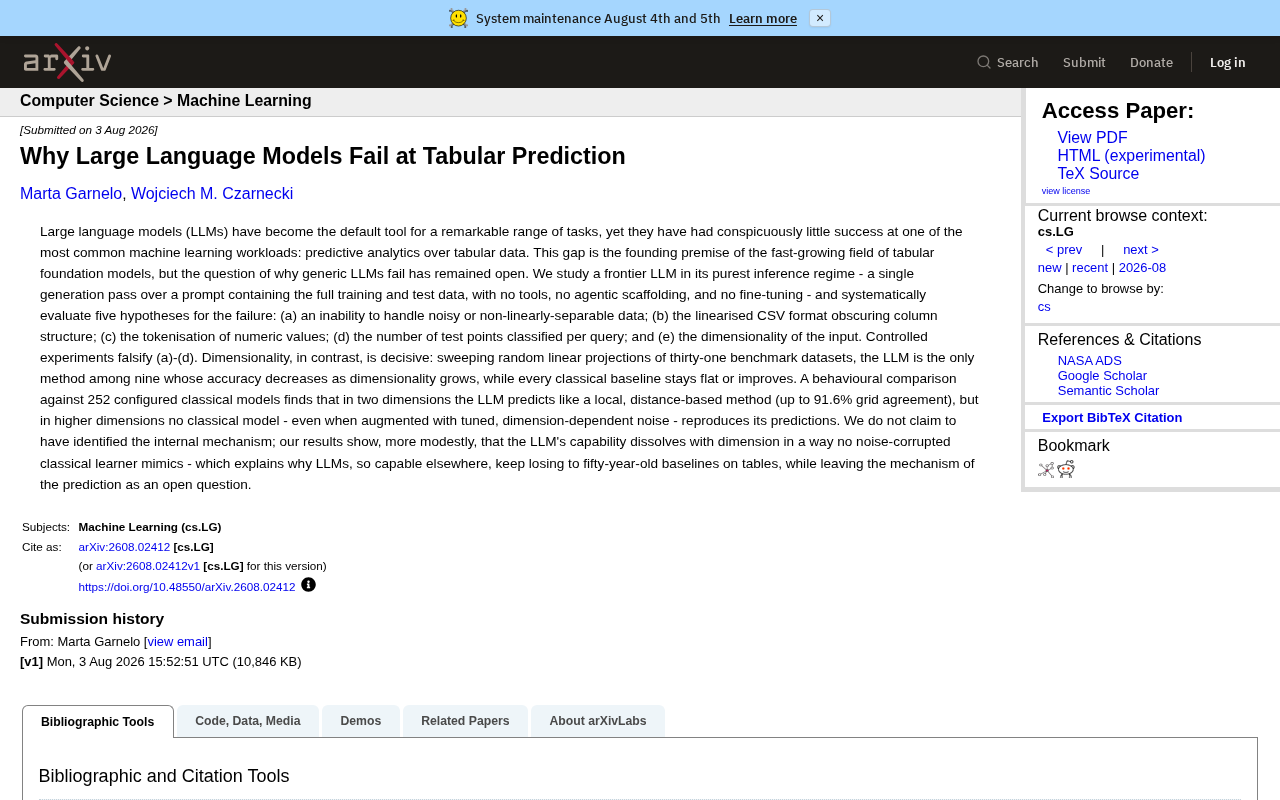
随着大语言模型(LLM)在自然语言处理、代码生成、多模态理解等领域展现出惊人能力,业界普遍产生了一种乐观预期:只要模型足够大、训练数据足够多,它就能胜任几乎所有预测任务。然而,一个反直觉的现实正在被越来越多的研究和实践所证实——在结构化表格数据(tabular data) 的预测任务上,动辄千亿参数的大语言模型往往不敌传统的梯度提升树(如 XGBoost、LightGBM)等经典机器学习方法。
这一话题近期在 Hacker News 上引发讨论。虽然讨论热度不高,但它触及了一个被长期忽视的技术盲区:语言模型的架构本质,决定了它并不适合处理表格这类高度结构化、数值密集的数据形态。
表格数据的特殊性:为什么它对LLM如此困难
结构化与数值主导的数据形态
表格数据是企业世界中最普遍的数据形态:金融风控、用户画像、销量预测、医疗诊断记录,绝大多数都以行列结构存储。它的核心特征包括:
- 列之间语义异构:一列可能是年龄(整数),另一列是收入(浮点),再一列是类别标签(枚举)。
- 特征间无固定顺序关系:与文本的序列性、图像的空间连续性不同,表格列的排列顺序通常不携带信息。
- 数值精度敏感:很多预测依赖于精确的数值大小比较,如「收入是否超过阈值」。
这些特征与自然语言有本质区别。语言是一维序列,具有强上下文依赖和语法结构,而表格是「无序特征集合」,其信息更多蕴含在数值分布和特征交互中。
XGBoost等树模型为何在表格任务中称霸
以 XGBoost 为代表的梯度提升树通过递归地在特征值上进行分裂,天然擅长捕捉数值阈值、非线性交互和缺失值处理。它们对表格数据的归纳偏置(inductive bias)恰好匹配——这也是为什么在 Kaggle 等数据竞赛中,树模型至今仍是表格任务的绝对王者。
梯度提升树(Gradient Boosted Decision Trees, GBDT)的核心思想是通过迭代地训练多棵弱决策树,每棵新树拟合前面所有树的残差(预测误差),最终将所有树的输出加权求和得到最终预测。XGBoost 在此基础上引入了正则化项、列采样和高效的分裂点搜索算法(如直方图加速),LightGBM 则进一步采用了 Leaf-wise 生长策略和 GOSS(Gradient-based One-Side Sampling)采样技术来提升训练速度。树模型天然支持混合类型特征(数值+类别)、自动处理缺失值、对特征尺度不敏感(无需归一化),这些特性与表格数据的异构性完美契合。Grinsztajn 等人 2022 年在 NeurIPS 发表的基准研究系统性地证明,在中等规模表格数据集上,GBDT 类模型持续优于深度学习方法。
LLM处理表格数据失灵的三大根本原因
分词器对数值语义的破坏
LLM 处理输入的第一步是分词(tokenization)。当一个数值如 12345.67 被送入模型时,分词器往往会将其拆解为多个不相关的 token(如 123、45、.、67)。这种切分彻底破坏了数字的连续性和大小语义——模型看到的不再是一个「量」,而是一串符号碎片。
LLM 使用的分词器(如 BPE、WordPiece、SentencePiece 等)最初是为自然语言设计的。BPE(Byte Pair Encoding)通过统计语料中高频字符对来迭代合并构建词表,这意味着词表的构建完全基于文本分布,而非数值语义。例如,数字 "12345" 可能被拆分为 "12""34""5" 三个 token,而 "12346" 可能被拆分为 "123""46" 两个 token——两个数值仅差 1,但其 token 表示完全不同,模型难以从中推断出它们的接近关系。这种表示方式使得模型无法建立数值的连续性映射,也无法可靠地执行简单的大小比较操作。
这直接导致 LLM 在数值比较、算术运算上表现脆弱。对于严重依赖数值大小关系的表格预测,这是致命缺陷。
Transformer架构与表格任务的归纳偏置错配
Transformer 架构为序列建模而生,其自注意力机制擅长捕捉 token 之间的长程依赖。但表格数据并不需要这种能力——它需要的是对特征交互和数值分裂的高效建模。将表格「序列化」为文本喂给 LLM,本质上是用错误的工具解决问题,模型不得不花费大量参数去「重新发现」树模型天生就具备的能力。
归纳偏置(Inductive Bias)是模型架构内建的假设,决定了模型在有限数据下倾向于学习什么样的函数。Transformer 的核心归纳偏置包括:位置不变的注意力权重计算(适合序列中的长程依赖)、通过 softmax 实现的稀疏注意力分配。而表格数据需要的归纳偏置截然不同:轴对齐的分裂边界(axis-aligned splits,即沿单一特征的阈值切分)、对特征排列顺序的不变性(permutation invariance)、以及对局部数值区间的敏感性。Transformer 的注意力机制倾向于学习特征之间的平滑加权组合关系,而非阶梯状的分段常数函数(这正是决策树擅长的)。实验表明,Transformer 需要极大的数据量才能逼近树模型天生具备的分段决策能力。
数据效率与推理成本的严重失衡
树模型在几千条样本上就能训练出不错的效果,而 LLM 即便通过微调或上下文学习(in-context learning)来处理表格,也需要更多样本、更高的推理成本,且结果往往仍不及基线。在生产环境中,这种「高成本、低回报」的组合缺乏吸引力。
具体而言,一次 XGBoost 训练在普通 CPU 上仅需数秒到数分钟,推理单条样本的延迟在微秒级别;而将表格序列化后送入 LLM 进行推理,每条样本可能消耗数百毫秒并占用昂贵的 GPU 资源。当面对百万级样本的批量预测场景(如每日信用卡欺诈检测),LLM 的推理成本可能比树模型高出三到四个数量级,这在商业上完全不可接受。此外,上下文学习(ICL)方式还受限于 LLM 的上下文窗口长度,无法将大规模训练集完整纳入提示词中。
改进方向:弥合LLM与表格预测的差距
专用数值编码方案
学界已在探索改进方向。例如,为数值设计专门的编码方式(而非依赖通用分词器),或引入连续值嵌入层,让模型能理解数字的真实量级。这类方法在部分基准上缩小了差距,但尚未撼动树模型的领先地位。
代表性方案包括:将数值转换为科学计数法表示(使模型能分别感知数量级和有效数字)、使用 xVal 等方法将数值作为连续标量直接乘以嵌入向量(绕过离散 token 化)、以及分位数编码(将数值映射为其在训练集中所处的百分位区间)。Google Research 的研究也探索了为每个数位分配独立 token 并附加位值信息的方案。这些方法的共同目标是让神经网络能够像感知「大小关系」一样处理数值,而非将其当作符号序列。
TabPFN等表格专用基础模型
另一条路径是设计专门面向表格的基础模型,如 TabPFN 等。它们借鉴 Transformer 的部分思想,但在架构上针对表格特性做了深度改造,而非直接套用语言模型。这类「表格专用基础模型」代表了更务实的方向——不是让 LLM 学会表格,而是为表格设计合适的模型。
TabPFN(Tabular Prior-Data Fitted Network)由 Hollmann 等人于 2023 年提出,其核心思想是在大量合成表格数据集上预训练一个 Transformer,使其学会「如何做表格预测」这个元任务(meta-learning)。在推理时,它将训练集作为上下文输入,直接输出对测试样本的预测,无需梯度更新,类似于一个学会了贝叶斯推断的神经网络。TabPFN 在小规模数据集(<1000 样本、<100 特征)上已展现出与 XGBoost 竞争甚至超越的性能。此外,还有 FT-Transformer(将每个特征独立嵌入后送入 Transformer)、SAINT(结合行注意力和列注意力的双重注意力机制)等架构,它们都针对表格数据的特性做了定制化设计,代表了「为数据形态设计架构」而非「强迫数据适应架构」的正确思路。
LLM在表格场景中的合理定位
这并不意味着 LLM 在表格场景毫无价值。它更适合承担辅助角色:自动生成特征工程代码、解释预测结果、处理表格中的文本字段、辅助数据清洗。将 LLM 的语言理解能力与树模型的预测能力结合,往往比单纯依赖任一方更有效。
例如,微软的 FLAME 框架和多个开源项目已经展示了这种组合范式:LLM 负责理解业务语境、建议有意义的特征组合(如将「出生日期」转换为「年龄」再转换为「年龄段」)、自动编写数据预处理管道代码,甚至为模型预测生成人类可读的解释报告。而最终的预测建模仍由 XGBoost/LightGBM 等树模型承担。这种「LLM as data scientist copilot + 树模型 as predictor」的协作模式,既发挥了 LLM 的语义理解优势,又保留了树模型在数值预测上的精度和效率,是当前产业界最务实的最佳实践。
结语:为任务选择正确的工具
LLM 在表格预测上的「失灵」,并非模型能力不足,而是架构与任务错配的典型案例。它提醒我们,在 AI 技术狂飙突进的当下,仍需保持工程上的清醒:没有任何一种模型是万能的。
对于结构化表格数据,成熟的梯度提升树依旧是首选方案;对于需要语义理解的场景,LLM 才能发挥所长。真正高效的系统,往往来自于对不同工具优势的精准把握与组合,而非盲目追逐参数规模。这也呼应了机器学习中一个经典但常被遗忘的原则——「没有免费的午餐」定理(No Free Lunch Theorem):不存在在所有问题上都最优的算法,每种方法的优势都建立在特定假设之上。在 LLM 热潮中重新审视这一原则,对于避免技术选型中的盲目跟风,具有重要的现实意义。
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。