未来四年AI将面目全非:从GPT-3.5到超级智能的跃迁
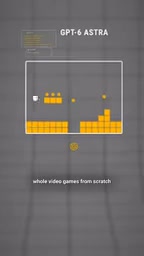
AI四年从玩具跃升为专家实习生,可验证领域将率先被全面超越。
文章回顾了过去四年AI的质变:从GPT-3.5只能写打油诗、补全简单函数,到Aster这类模型能独立构建完整电子游戏、产出可发表级别的数学成果。作者强调关键在于“可验证领域”——数学证明、代码生成、芯片设计、金融交易等有明确成功标准、可自我验证与快速迭代的方向,AI进步速度远超艺术创作等难以量化的领域。若未来四年发生同等幅度跃迁,到2030年前后AI可能在芯片设计上超越NVIDIA、交易收益碾压顶级对冲基金、并在接入实验设备后于室温超导体等材料搜索上超越全人类。作者提醒,下次跃迁的起点已是专家实习生,其结果不是辅助人类,而是在可验证领域替代甚至超越人类。
从“玩具”到“专家实习生”:四年间的质变
四年前,GPT-3.5 能写一首勉强通顺的打油诗,能自动补全一个简单的 Python 函数,但除此之外,它更像一个无用的玩具。而今天,像 Aster 这样的模型已经能从零构建完整的电子游戏,并产出大量值得发表在顶级期刊上的数学贡献——多到我们对此完全麻木。
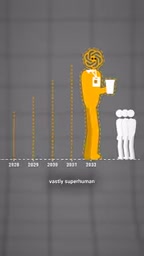
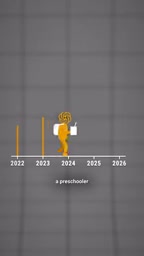
据 YouTube 科技频道分析,过去四年里,AI 从“幼儿园水平”跃升为“专家级实习生”。这种进化速度本身就是一个信号:如果从 2026 年开始,再发生一次同样幅度的跳跃,四年后我们将面对一个在任何稍微可验证的领域都远超人类的智能体。
什么是“可验证领域”?为什么它如此关键?
原文强调了一个关键限定词——“稍微可验证的领域”。数学证明、代码生成、芯片设计、金融交易策略,这些领域有明确的成功标准,AI 可以自我对弈、自我验证、快速迭代。在这些领域,AI 的进步速度会远超那些难以量化的领域,比如艺术创作或情感理解。
换句话说,AI 的能力边界并不均匀:在可验证的领域,它可能以数月为单位迭代;在不可验证的领域,它仍然笨拙。这种不对称性,正是未来四年最值得关注的变量。
“可验证”这一限定在强化学习语境中对应的是可自动验证的奖励信号(verifiable reward)。它的核心要求是:给定一个输出,存在一个低成本、确定性的程序能判断其正确性,例如编译器检查代码能否通过单元测试、证明助手(Lean、Coq)检查数学证明是否闭合、回测引擎评估交易策略的历史收益。与之相对的是“不可验证”任务,其质量只能靠人类偏好打分或主观判断,反馈信号稀疏、噪声大,因而难以支撑大规模自我迭代。这一区分之所以关键,是因为当前模型能力的提升高度依赖强化学习与合成数据生成——奖励信号越可靠、越廉价,模型就能在越短周期内完成越多次“生成—验证—改进”的循环。DeepMind 的 AlphaGo/AlphaZero 正是这一范式的原型:规则明确的棋盘提供了完美验证器。由此可以推断,AI 能力的边界会沿着“验证器是否容易编写”这条线展开,而非沿着“任务对人类是否困难”展开。
三件可能被 AI 彻底改写的事
如果未来四年的跃迁幅度与过去四年相当,那么到 2030 年左右,我们可能看到以下场景:
第一,AI 芯片设计超越 NVIDIA。 一个在“可验证领域”内超人的 AI,能在芯片架构搜索空间里比人类工程师更快找到更优解。它不需要休息,不需要会议,可以并行探索人类从未考虑过的设计路径。
第二,金融交易收益碾压顶级对冲基金。 如果 AI 拥有同等的市场准入,它可能比 Citadel 和 Jane Street 的人类团队赚得更多。原因很简单:交易策略在历史数据上可回测、可验证,属于典型的可验证领域。
第三,材料科学突破,比如室温超导体。 如果 AI 能远程接入材料实验实验室,它可能比全人类加起来更擅长找到室温超导体。材料搜索本质上是高维组合优化问题,而 AI 在可验证的搜索任务上具备天然优势。
“芯片架构搜索”指的是在一个由总线宽度、缓存层级、流水线深度、算子单元数量等参数构成的高维设计空间中寻找性能、功耗、面积最优的组合,其搜索空间通常大到无法穷举。传统上这类工作依赖资深工程师的经验与 EDA 工具链的迭代。若将硬件描述语言(如 Verilog/Chisel)的生成与仿真、综合、时序分析结果作为验证器,AI 便可以把架构设计转化为一个可自动评判的优化问题——生成了一个设计,就跑一遍仿真与综合,根据时序裕量、功耗和面积得到反馈并改进。这与人类工程师的关键差别在于并行度:人类团队一次只能推进少数几个方案,而 AI 可以同时探索成百上千条人类出于直觉或惯例从未考虑过的路径。
从“幼儿园”到“专家实习生”:我们身在何处?
原文用了一个精准的比喻:四年前是幼儿园水平,今天是专家实习生。这个实习生已经能独立完成游戏开发、数学证明等复杂任务,但它仍然需要人类设定目标、提供验证标准、把控方向。
问题在于:下一次跃迁的起点不再是幼儿园,而是专家实习生。从专家实习生再往上跳一个数量级,得到的将是一个在可验证领域全面超越人类的系统。这种能力差异不是线性的,而是质的断裂。
“专家实习生”这一比喻的准确之处在于它刻画了一种能力与自主性不对称的状态:在具体任务的执行上已经达到甚至超过熟练人类,但在目标设定、任务分解、结果验收与责任承担上仍依赖人类。这一状态与“智能体”(agent)概念密切相关——智能体指的是能够自主规划、调用工具、在多步环境中持续推进目标的系统。从实习生迈向“全面超越人类”,关键不只是单步能力的提升,更是长程自主性的提升:能否在数小时乃至数天的任务中自行发现错误、调整策略、申请所需资源。因此在评估下一次跃迁时,单看基准测试分数会低估变化,更值得关注的是模型在开放环境中自主运行的长度与可靠性。
结语:未来四年,比过去四年更陌生
过去四年的 AI 进步已经让很多人感到措手不及。但真正的冲击可能还在后面:当模型从“专家实习生”再向前跳一步,它在数学、芯片、金融、材料等可验证领域的表现,将不再是对人类的辅助,而是替代甚至超越。未来四年,AI 的样子可能和过去四年毫无相似之处——而我们最好提前理解这种不对称性。
相关推荐

普朗克长度是最小距离吗?物理学家为何存疑
普朗克长度常被称为宇宙最小距离,但科普视频指出这一说法从未被实验证实。本文解析普朗克长度的来源、显微镜思想实验的障碍,以及它真正告诉我们的——量子引力变得不可回避的尺度,而非时空像素。

AI代理驱动支出管理,Payhawk获2.8亿美元融资
Payhawk宣布完成2.8亿美元融资,估值达20亿美元。这家成立于2018年的企业财务管理平台以AI代理追踪和管理费用与采购,本文分析其产品定位演进、估值信号及对企业支出管理赛道的影响。

Snapchat开放AI助手构建AR滤镜:支持Claude Code与Cursor
Snapchat 宣布 Lens 创作者可用自然语言描述 AR 滤镜需求,由 Claude Code、Cursor 等 AI 助手完成从构建到完成的整个开发流程,AR 创作门槛大幅降低。