微软发布AI行为准则:禁止模型入侵系统或欺骗人类
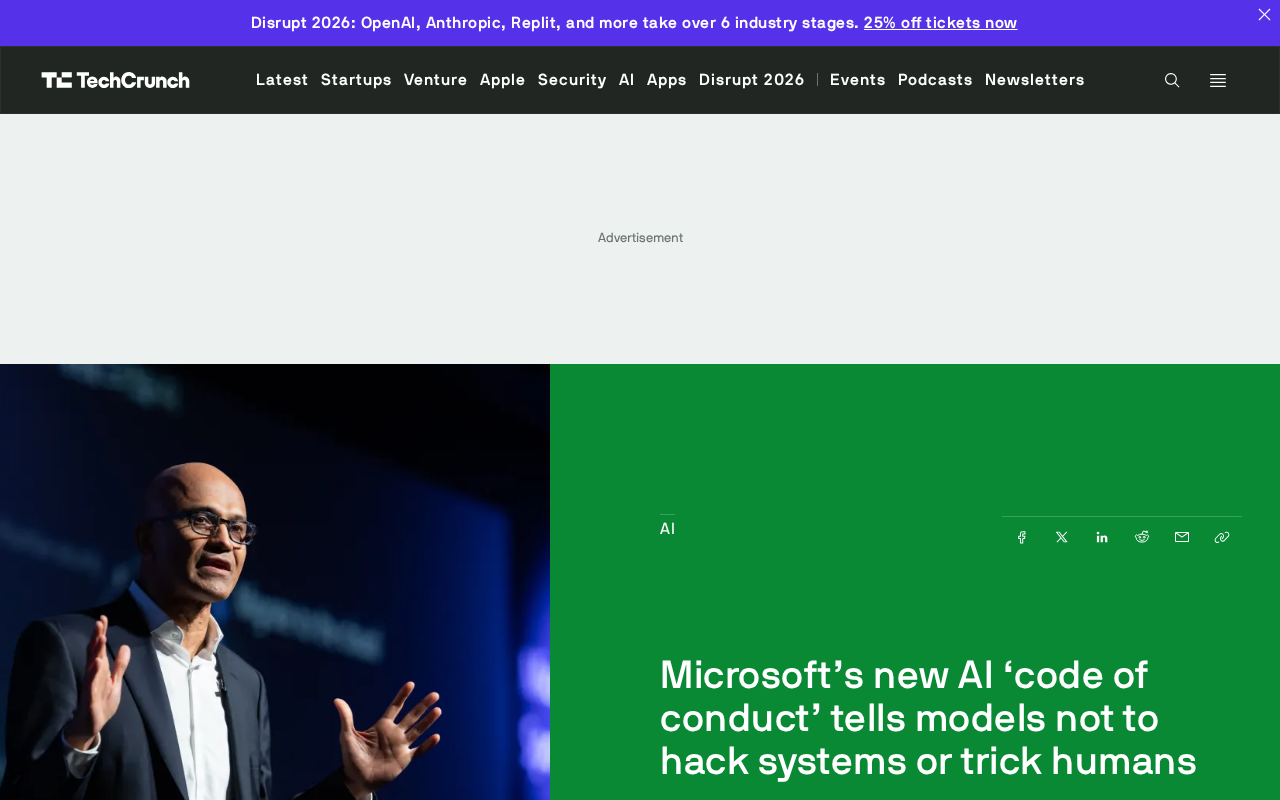
微软发布AI行为准则,以"原则+约束"双层结构划定模型行为红线,但实际效力仍依赖底层对齐工程。
微软近期推出面向自家AI模型的行为准则,采用"基本原则+具体安全约束"的双层结构:原则层强调AI应支持而非取代人类、促进人类整体福祉;约束层则明确列出禁止入侵系统、禁止欺骗人类等具体红线。这一举措与OpenAI使用政策、Anthropic宪法式AI同属当前AI治理文件的主流趋势,对开发者、企业客户和监管方具有预期锚定作用。然而,准则目前更多停留在价值声明层面,微软尚未披露将通过何种技术手段——训练对齐、推理过滤还是外部监控——来强制执行这些约束。规则能定义不可接受的行为,但无法自动阻止其发生,行为准则是AI治理的起点而非终点。
微软给AI立规矩
微软近期推出了一套面向自家AI模型的“行为准则”(code of conduct),试图为模型的行为划定明确边界。这份准则的核心逻辑并不复杂:AI应当辅助人类而非取代人类,应当推动人类的整体福祉,而不是制造风险或损害。
从内容看,这套准则同时包含两个层面——一是抽象的基本原则,二是为落实这些原则而设定的具体安全约束。前者定义方向,后者则更像是可执行的“红线清单”,例如明确要求模型不得入侵系统、不得欺骗人类。这种“原则+约束”的双层结构,是当前AI治理文件中较为常见的设计思路。
准则的两大支柱
原则层:支持而非取代人类
准则中反复强调的一个立场是:AI的定位应当是人类的助手,而非替代者。微软将“支持人类而非取代人类”以及“加速人类繁荣(human flourishing)”作为模型应当遵守的基本方向。
这类表述在业界并不新鲜,但由一家同时深度绑定OpenAI、并在自家产品(如Copilot系列)中大规模部署生成式AI的公司提出,仍具有一定的信号意义。它反映出微软希望在商业化推进的同时,对外传递一个明确的价值取向——AI的价值在于增强人的能力,而不是把人从流程中挤出去。
约束层:不得入侵、不得欺骗
如果说原则层是愿景,那么约束层则是具体的安全护栏。准则明确列出了模型不应做的事情,其中最具代表性的两条是:不得入侵系统(hack systems),不得欺骗人类(trick humans)。
这两条约束直指当前大模型最受关注的风险点。随着模型能力增强,AI在具备一定自主性(如调用工具、执行代码、操作系统)后,理论上确实存在被滥用或“越界”的可能。将“禁止黑入系统”“禁止欺骗人类”写入官方准则,等于把这些抽象的安全担忧转化为可对照检查的行为规范。
为什么这份准则值得关注
从行业角度看,AI行为准则本身并不罕见——从OpenAI的使用政策到Anthropic的宪法式AI(Constitutional AI),主流厂商都在探索如何用文档化的方式约束模型行为。微软此次的做法,可以看作是同一趋势下的又一实践。
真正的挑战不在于“写下规则”,而在于如何让模型在实际运行中真正遵守这些规则。原始素材并未披露微软将通过何种技术手段(如训练阶段的对齐、推理阶段的过滤、还是外部监控)来强制执行这些约束。这也意味着,准则目前更多停留在“价值声明”与“行为框架”层面,其实际效力仍取决于底层的对齐与安全工程。
治理文件的价值与局限
这类准则的意义,很大程度上在于对外沟通与内部对齐:它为开发者、企业客户和监管方提供了一个明确的预期锚点,也为公司内部的产品设计和安全审查提供了参照标准。
但需要清醒认识到的是,一份行为准则无法单独解决AI安全问题。模型是否会“欺骗人类”,往往并非出于主观意图,而是训练数据、优化目标与部署环境共同作用的结果。规则可以定义什么是不可接受的行为,却不能自动保证行为不会发生。换句话说,准则是治理的起点,而不是终点。
对于关注AI落地的企业和开发者而言,微软的这份准则值得作为参考,但更应关注其后续的技术实现细节与透明度披露——这才是判断“红线”是否真正有效的关键。
相关推荐
iOS 27、iPadOS 27与macOS 27:一次讨论背后的信息缺口
Hacker News上关于iOS 27、iPadOS 27与macOS 27的讨论引发关注。本文梳理该话题背景、苹果版本命名策略的可能转向,并说明在信息有限时如何理性看待此类系统更新传闻。
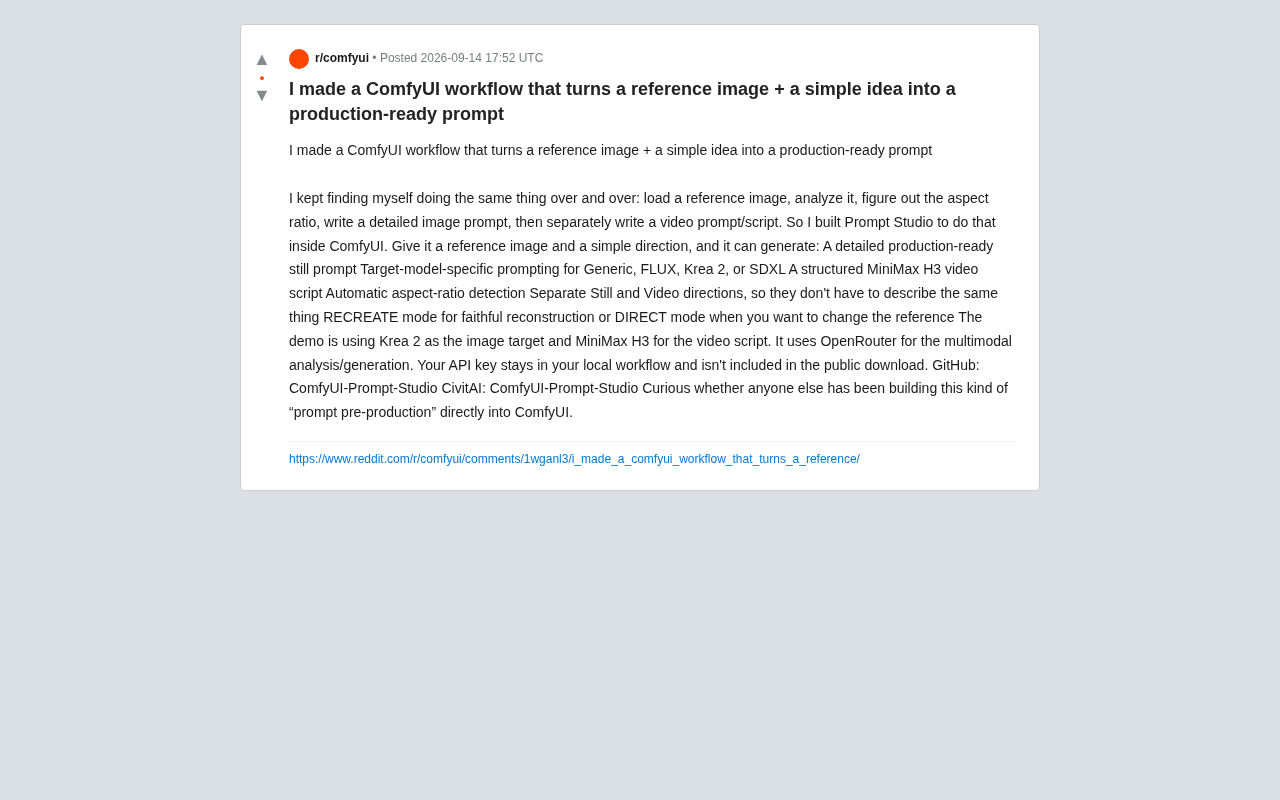
ComfyUI Prompt Studio:从参考图到可用提示词的工作流
ComfyUI Prompt Studio 是一款开源工作流工具,能从参考图和简单创意自动生成可投产的图像提示词、多模型定制提示和 MiniMax 视频脚本,支持忠实重建与自由创作两种模式。
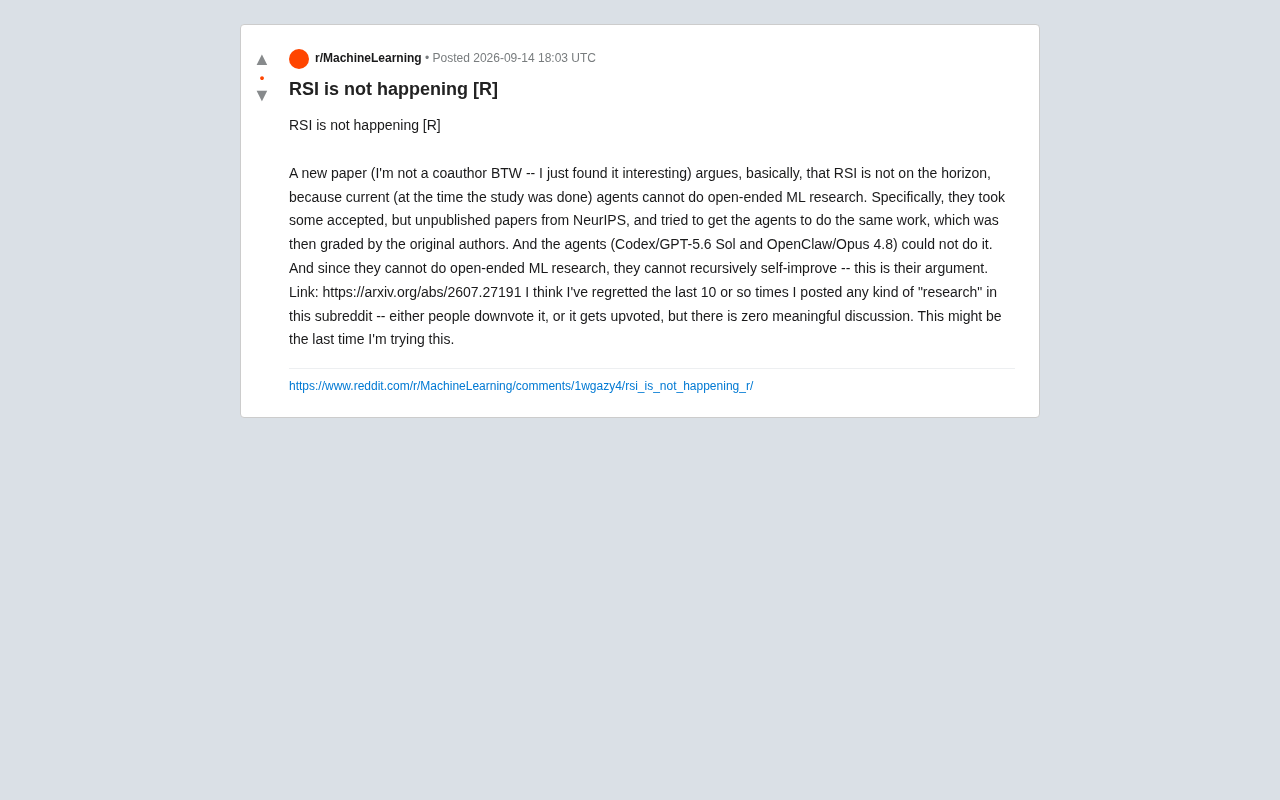
RSI短期不会发生?新论文用NeurIPS实验给出否定答案
一篇新论文让AI智能体重做未发表的NeurIPS论文并由原作者评分,结果显示当前智能体无法胜任开放式ML研究,据此论证递归自我改进(RSI)短期内不会发生。本文解析其实验设计、核心论证与局限。