微软开源Token Economizer:为AI编程代理省下18%-31%成本

微软开源插件 Token Economizer 通过让代理记住教训,将 AI 编程成本降低 18.4% 至约 31%。
微软近期开源免费插件 Token Economizer,在不更换模型或代理的前提下,将 Claude Code、Codex 等 AI 编程代理的平均成本降低 18.4% 至约 31%,且节省已扣除插件自身开销。其三大机制为:微技能从历史会话中提取仓库知识并在新会话直接注入、工具剪枝停止加载闲置工具定义、失败循环干预用裁判模型识别卡死并提示换思路。微软与 UC Berkeley 的联合测试覆盖 6 个仓库、1777 个 SWE-bench 任务和 5 种代理模型组合,4/5 组合任务成功率不降反升,全部 30 个组合成本均更低。但收益高度依赖同一仓库的重复使用,频繁切换项目或面对全新任务时效果明显减弱,且每个代理独立学习、知识不互通。
AI 编程代理的 token 消耗问题,终于有了一个不靠“换便宜模型”的解法。微软近期开源了一款名为 Token Economizer 的免费插件,据 Better Stack 在 B 站发布的视频介绍,在微软与 UC Berkeley 的联合测试中,该插件将 AI 编程代理的平均成本降低了 18.4% 到约 31%,且测试中并未使用更便宜的模型或更换代理,而是直接作用于 Claude Code、Codex 等主流工具。
它解决的是什么问题
用过 Claude Code 这类工具的人大概都见过这样的场景:让它修一个 bug,它尝试一条命令、报错、再换个写法继续试,token 就在反复试错中烧掉了。更糟的是,下次开新会话,它可能把同样的错误再犯一遍,你为同一个教训重复付费。
Token Economizer 的思路是让代理“记住”这些教训。它从历史会话中学习仓库的运作方式,移除用不到的工具,并在代理陷入重复失败时介入。官方定位很明确:不压缩 prompt、不降级模型,而是消除代理反复浪费掉的那部分工作。
SWE-bench 是理解本文测试数据的关键背景。它是由普林斯顿大学等机构提出的软件工程基准,从真实 GitHub 仓库中抽取 issue,要求 AI 在代码库中定位问题、修改代码并通过测试,最终以“任务解决率”衡量能力。本文测试使用的 1777 个任务即出自该基准。SWE-bench 的价值在于它贴近真实开发流程:代理需要多轮读写文件、运行命令、根据报错调整策略,因此 token 消耗远高于单轮问答,这也正是 Token Economizer 所针对的成本结构。理解这一点,才能明白为何测试要在多个仓库和多种代理组合上展开,而非单一场景。
三个核心机制
微技能:把踩过的坑变成开场知识
每个仓库都有自己的“潜规则”——测试该用哪条命令、需要哪些环境变量、文件放在哪里。代理一开始并不知道,只能靠试错摸索。微技能(micro skills)会分析过往会话,一旦某个细节被反复确认,就在新会话开始时直接喂给代理。代理不必再为同一个命令浪费一轮 token。
需要说明的是,微技能默认关闭,视频作者在演示时手动开启了它。
工具剪枝:不用的工具就别加载
代理启动时会往上下文里塞入一批工具定义,这些定义本身就要消耗 token,哪怕代理一次都没调用过。工具剪枝(tool pruning)统计仓库中工具的实际使用情况,对持续闲置的工具停止加载,需要时再恢复。
失败循环干预:卡住时推它一把
当代理反复执行几乎相同的命令、只改一个微小细节时,Token Economizer 会调用一个裁判模型判断是否陷入循环。若确认卡死,它会给代理发一条简短指令,建议换个思路;如果仍然无法恢复,它会告诉用户如何终止本轮。作者特别指出,它的做法是提示而非粗暴中断,不会直接“撂挑子”。
裁判模型(judge model) 在这里扮演的是一个轻量、独立的判断者,而非主代理本身。它不负责写代码,只接收代理近期命令序列的摘要,判断“是否在原地打转”。这种设计的好处是把“识别异常”与“执行任务”解耦:主代理的上下文不被额外诊断逻辑挤占,裁判模型也可以选用更小、更便宜的模型来降低成本。代价是它需要额外的模型调用,这部分开销已计入官方公布的净节省中。裁判模型只做提示、不强行终止,也避免了误判导致任务中断的风险。
实测数据说明了什么
微软与 UC Berkeley 的测试覆盖了 6 个仓库、1777 个 SWE-bench 任务、5 种代理与模型组合,单轮成本约 200 美元。结果是:平均成本下降 18.4% 至约 31%;在 5 种组合中有 4 种任务成功率不降反升,另有 1 种小幅下滑;全部 30 个“仓库 × 代理模型”组合中,启用插件后都比不启用更便宜。
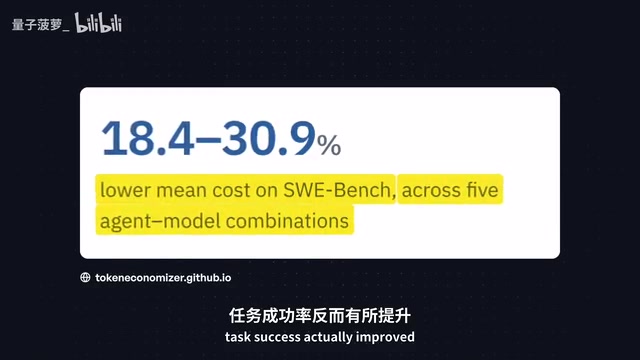
一个容易被忽略的细节是:这些节省已经扣除了插件自身的开销。部分功能需要额外的模型调用,并非零成本运行,官方给出的降幅是净收益。
不是所有人都能拿到同样的数字
这是全文最需要冷静看待的部分。Token Economizer 的收益高度依赖“重复”。它的价值来自同一仓库上多轮会话的积累,用得越久,学到的越多,省下的越多。
如果你每天在一两个核心项目上反复使用代理,它大概率能帮上忙;但如果你频繁在互不相关的项目之间跳转,或者代理每次面对的都是全新任务,可供学习与消除的重复工作本就不多,效果会明显打折。作者的建议很务实:先在最常用的仓库上装一周,然后看状态报告,对比同类任务的实际成本,再决定去留。
另外两点需要注意:每个代理独立学习,Claude Code 学到的东西不会自动迁移到 Codex;第一次会话的表现在统计上说明不了问题,别拿单次体验下结论。
微技能与工具剪枝的收益曲线并非线性,而是随同一仓库的会话轮次增加而逐步显现。首轮会话时,插件几乎没有可供学习的样本,微技能默认关闭、工具使用统计也尚未成形,因此节省接近于零,甚至因插件自身运行而产生轻微额外开销。通常需要数轮乃至十余轮同类任务后,反复出现的命令、环境变量与闲置工具才会被稳定识别。这也是原文强调“别拿单次体验下结论”的技术原因——评估周期应以周为单位,而非以次为单位。
与其他省钱路线的区别
市面上主打降 token 的工具不少,多数走的是压缩 prompt 或切换小模型的路子。Token Economizer 走的是另一条道:它不改变你写 prompt 的方式,也不动模型选择,而是从代理的行为模式里抠成本。这带来的一个附带好处是透明度——学到的仓库信息全部保存在本地的 token economizer 文件夹内,不上传云端;项目本身开源,安装只需克隆仓库并从市场安装插件。
这种“从行为里省钱”的思路,本质上是把代理的试错成本当作可优化的对象,而不是接受它作为使用 AI 编程的固定税。对长期在固定代码库上工作的开发者来说,这可能是比换模型更可持续的降本方式。
(本文基于 Better Stack 视频内容整理,数据与结论均引自该来源。)
相关推荐
AI替你写代码,还要学Git吗?五个理由
AI编程代理能自动处理Git操作,还有必要学Git吗?本文提炼五个理由:与团队沟通、审阅代理提交的PR、监督代码改动、在AI宕机时兜底,以及学习本身的乐趣,并分析代理时代Git学习重心的转移。

Anthropic据报以每股83美元定价IPO,估值达1.5万亿美元
Anthropic据报以每股83美元定价IPO,高于预期发行区间,完全稀释估值达1.5万亿美元。本文分析此次定价的信号意义及其对AI行业融资环境的影响。

纳德拉预言:AI代理将重塑网络经济规则
微软CEO纳德拉预测AI代理将重新洗牌网络经济,冲击广告驱动模式,并迫使亚马逊等平台重新思考客户争夺方式。本文解析代理经济对广告、电商与平台竞争逻辑的影响。