微软Meta同日发布新模型,为何企业级AI才是真正焦点
微软与Meta同日发布基座与开源权重模型,指向企业AI的成本与主权之争。
文章指出,本周真正值得企业关注的不是Muse Wonder或Gemini 4 Argon,而是微软与Meta两场低调发布。微软MAI Base 2是2.8万亿参数、800亿激活参数的MoE基座,称以四分之一算力超越驱动GPT-5.6 Sol的预训练基座,并配合Frontier Tuning让企业微调自有模型,回应智能层主权问题。Meta的MuseSpark Open为8160亿总参数、100万token上下文的开放权重模型,在Artificial Analysis开源榜排第7,被视为美国开源权重模型的回归,回应成本与私有部署问题。两者共同指向企业正从单一供应商转向多模型混用架构。文末还梳理了Anthropic第三方安全评估、Cognition的token信用分、白宫AI工作组会议与vibe-coding游戏开发等动态。
微软Meta同日发布新模型,为何企业级AI才是真正焦点
本周AI圈的热闹属于Muse的Wonder系列和Google的Gemini 4 Argon,但据AI Daily Brief在视频中的判断,真正值得企业关注的,反而是周四微软和Meta那两场几乎没登上热搜的发布。没有刷新SOTA的基准测试,也没有引发X上的狂欢,它们解决的却是当下企业用AI最现实的两个问题:成本与主权。
微软MAI Base 2:一次"迟到"的前沿预训练
微软AI CEO Mustafa Suleiman在内部town hall上透露,新发布的MAI Base 2是一个2.8万亿参数的基座模型,采用MoE架构,激活参数800亿,与Kimi K3规模相当。这是一次完全从零开始的预训练,没有蒸馏任何其他模型。
Suleiman的说法相当直接:"我们现在拥有的预训练基座模型,比驱动GPT-5.6 Sol的模型更强,而我们只用了OpenAI训练该模型四分之一的算力。"这一对比基于微软作为投资方获得的非公开信息,并未对外披露细节。公开层面,微软将MAI 2与所有参数超过万亿的开源模型对比,称在各项预训练基准上全面领先,预训练效率是DeepSeek广告 v4 Pro的12倍以上,训练使用了16000块GB200 Blackwell GPU,耗时38天。
对微软而言,这次预训练的意义不止于模型本身。从2019年起向OpenAI投入130亿美元,到2023年Altman被罢免又复职的动荡,微软管理层逐渐意识到,无论合作多紧密,从受托责任的角度都需要更多独立性。2024年3月招来DeepMind联合创始人Suleiman执掌新AI部门后,外界看到的多是摩擦报道,直到MAI-1系列面世,新策略才浮出水面。
MAI-1在基准上并不惊艳,但它承载的商业模式叫Frontier Tuning——允许客户在微软基座模型上微调自己的模型。这个产品踩中的时间点很关键:企业正陆续发现,把所有智能需求都交给最顶尖的模型并不划算,尤其在agentic时代,token账单的增长速度远超预期。Nadella反复强调,企业必须拥有模型之外的"智能层",而不是把这一层交给模型供应商。
MoE架构与激活参数:混合专家(Mixture of Experts)模型将前馈层拆分为多个"专家"子网络,每次前向计算只激活其中一小部分。因此"总参数"与"激活参数"是两个不同概念——总参数决定模型容量与显存占用,激活参数决定单次推理的计算量。MAI Base 2的2.8万亿总参数、800亿激活参数意味着它在存储上属于超大规模模型,但每次token运算的算力成本接近一个800亿参数的稠密模型。这也解释了为何"参数规模相当"的模型之间推理成本可能相差数十倍,是企业评估token账单时必须区分的关键指标。
预训练与蒸馏:预训练指在大规模无标注语料上从随机初始化开始训练基座模型,成本最高、周期最长;蒸馏则是让新模型模仿已有强模型的输出分布,成本低但上限受教师模型约束。Suleiman强调MAI 2"完全从零预训练、未蒸馏任何模型",意在说明其能力来自自有数据与算力投入,而非借用竞争对手的模型输出,这对企业客户的合规与供应商独立性叙事很重要。
Meta MuseSpark Open:美国开源权重模型的回归
Meta本周的另一条线是Muse的Wonder系列回归前沿,但真正被Smart Money盯上的是MuseSpark Open。Meta称之为"美国迄今最强的开源权重模型":总参数8160亿,激活420亿,上下文窗口100万token,面向编码和长周期agentic任务。
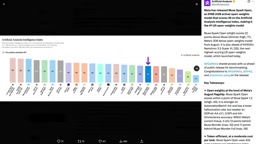
Artificial Analysis给MuseOpen打出39分,总榜并列第17,开源模型中排第7,距离开源SOTA约7分,但领先Nemotron和Inkling约13分。在JobBench、MCPAtlas等agentic基准上,Meta声称达到开源SOTA。开源模型研究者Nathan Lambert的评价颇能代表社区情绪:"我等美国开源权重模型重新变得重要等了太久。"他指出,在此之前美国模型仍落后于中国模型,而MuseOpen"至少把差距缩短了一半"。
Meta的开源路线走过一段弯路。Llama 3时代Meta曾在开源前沿紧咬OpenAI,Llama 4的失利和Behemoth的缺席则直接触发了扎克伯格对AI部门的彻底重建。当Meta重新发布模型时,外界一度以为开源已成往事,Alexander Wang承诺回归开源时也有人怀疑。MuseSpark Open算是兑现了承诺。
一个容易被忽略的细节是Apple的第一方支持。这两家公司向来算不上朋友,但Apple更新了MLX工具包以确保Spark Open在自家硬件上顺畅运行,扎克伯格发布Muse在Mac Studio上运行的视频并致谢Apple的John Ternus,Ternus则回应"这是宣布新任Apple CEO要换个做法的好方式"。当然,完整版模型需要1TB内存,大致相当于两台顶配M5 Ultra Mac Studio,售价约4万美元——对个人用户遥不可及,对在意私有推理的小型初创公司却并非不可承受。
开源权重(open-weight)与开源模型:业界所称的"开源模型"多数只开放模型权重,训练数据、训练代码与数据配比往往不公开,因此严格意义上属于"开放权重"而非OSI定义的开源。这一区别对企业很实际:开放权重允许本地部署、私有推理和微调,满足数据不出域的要求,但无法让企业完整复现或审计训练过程。MuseSpark Open、Llama系列与中国开源模型均属此类,衡量其价值的关键指标包括许可证条款(商用限制、用户规模门槛)、上下文窗口与部署硬件门槛。
MLX与本地推理硬件:MLX是Apple为自研芯片设计的机器学习框架,针对统一内存架构优化,使大模型可以直接在Mac的内存空间中加载与推理,无需独立显卡显存。统一内存的优势是容量大(顶配Mac Studio可达数百GB),劣势是带宽低于高端数据中心GPU。因此"1TB内存、约4万美元两台顶配Mac Studio"这类配置,面向的是对数据主权敏感、吞吐需求不高的小型团队,而非大规模生产推理。
企业AI的真正分水岭:成本与主权
把微软和Meta的发布放在一起看,指向的是同一个趋势。企业正在变成"模型杂食动物",希望根据任务需要在不同模型之间进出,而不是被锁定在单一供应商的生态里。Box的Aaron Levy认为,这会进一步加速AI扩散:企业可以用前沿模型做编排和高端任务,用低成本、定制化的后训练模型处理重复性工作流,整体token消耗和工作负载都会显著上升。
微软的Frontier Tuning给出了主权问题的答案,Meta的开源权重模型给出了成本问题的答案。开源阵营本来就有中国模型可选,但考虑到微软在企业生态中的既有嵌入程度,不少公司会更愿意找微软微调,而不是自己去搭一套基于中国基座的本地部署基础设施。如今Meta补上了美国开源权重这一块拼图,企业的选择面比几个月前宽了不少。
短期内,大多数企业仍会选择订阅Claude或ChatGPT这种"交钥匙"方案,这不现实被推翻。但具备一定技术能力的公司,正在设计更复杂的模型架构,依据性能、能力、成本或效率约束灵活切换。这是本周两场低调发布最值得跟踪的信号。
模型路由与"模型杂食":多模型混用架构通常由一个编排层(router/orchestrator)根据任务类型、难度、延迟与成本预算,把请求分派给不同模型:高价值、开放式任务交给前沿闭源模型,重复性、结构化任务交给成本更低的后训练或开源模型。这一模式的技术前提是各模型接口趋于标准化,以及企业能够对不同模型的单位token成本与质量做可比较的评估。其副作用是运维复杂度上升——需要统一的可观测性、缓存、评测与成本归因体系,这也是"智能层"成为独立产品品类的原因。
后训练与Frontier Tuning:后训练(post-training)指在基座模型之上通过监督微调、偏好优化等手段注入领域能力,成本远低于预训练,但效果高度依赖基座质量与数据质量。Frontier Tuning这类托管微调服务的核心卖点不是模型本身,而是让企业在不掌握训练基础设施的前提下拥有一个专属模型,并把领域数据与提示工程沉淀在可控边界内,从而在"用最强模型"与"拥有自己的智能层"之间取得折中。
其他值得关注的动态
Anthropic引入第三方安全评估
Anthropic已将首批第三方评估者嵌入组织,来自METR的六人团队获得"类员工权限",包括公司电脑、办公空间和内部工具的使用权。SecureBio和Accenture也在评估者之列,与Hugging Face等的早期洽谈正在进行。争议集中在独立性上:Anthropic称不资助METR,但双方共享不少EA领域的金主。Anthropic设定了三级审计者权限,METR独占最高级,评估者"不能否决发布",但可要求对客户数据、法律特权信息和模型架构信息做删减,并可公开评价删减是否合理。Embroidery创始人Zach Korman直言这是"安全剧场",但也有观点认为这至少是个风险管理原型,最终会演化为四大会计师事务所的一门生意。
Cognition用"信用分"管理token预算
Cognition为使用Devin的工程师设计了动态token预算:系统用AI估算会话相当于人类多少小时的工作量,工程师触达上限时会被评估token使用效率,评分合格则自动提高限额。VP Calvin Giroud把这比作信用卡提额。开发者反应普遍负面,有人称软件工程变成了工厂岗位,有人指出"人类需要多少小时"衡量的是错误的东西,会激励人们造最复杂而非最有价值的东西。但也有观点认为,无论这套方法是否合理,token分配终将成为一项核心技能。
白宫AI工作组首次会议
白宫AI工作组周四召开首次会议,首要任务是监督120天内发布的AI安全报告,覆盖AI风险与网络安全、关键基础设施、生物安全与两用应用、模型控制与问责。工作组还设立小组落实各前沿实验室签署的白宫协议,内容包括董事会层面的安全监督和与外部审计方合作。协议是自愿性的,如何执行仍悬而未决,一位白宫官员对Semafor表示,出口管制可能成为施压手段之一。
用Opus 5.5"蜂巢式"开发游戏
YouTuber Max Blade和主播朋友们用vibe-coding做出了名为Kong Royale的百人竞技游戏,号称"全球首款AAA级vibe-coded大逃杀"。他此前尝试过但模型能力不足,这次借助Opus 5.5和两个Claude Max账号,花几周时间完成。他称这套方法为hive-coding:把多个agent放进直播聊天,夜间review观众提出的改动建议,挑选最好的合并进次日晨间构建。开发过程本质上由观众众包完成。
相关推荐

AI红利仅限科技圈?非科技行业难见回报
Apollo分析指出,AI的经济回报目前高度集中在科技行业,非科技领域尚无可量化收益迹象。本文梳理其核心论点、Hacker News上的分歧观点,以及对企业AI投入与衡量的实际启示。

AI时代,BBC《蓝色星球III》为何刻意保留“不完美”镜头?
BBC《蓝色星球III》在AI时代反其道而行,刻意保留不完美镜头以证明画面真实性。本文分析这一策略背后的信任逻辑,以及它对内容创作者在AI时代的启示。

FreeDNS:免费动态DNS服务的经典之选
FreeDNS 是一个提供免费动态 DNS 托管服务的平台,支持共享域名池和 HTTP 更新。本文介绍其核心功能、社区评价、适用场景及与其他 DNS 方案的对比。