微软QDK for Chemistry:量子与经典融合的化学计算开源框架

微软开源QDK for Chemistry,以模块化设计打通量子化学模拟的经典-量子混合工作流。
微软量子团队推出开源库 QDK for Chemistry,目标是消除领域化学家与量子算法开发者之间的软件鸿沟。该库将完整的量子化学计算工作流模块化:从分子结构输入、几何优化、自洽场计算、活性空间选择,到费米子-量子比特编码、量子电路构造,再到调试与硬件执行,每个阶段都作为独立自定义点通过标准化数据接口耦合。这种设计实现了关注点分离——不同背景的研究者可以只深入自己负责的环节,而无需掌握整个软件栈。微软应用团队尤其看好量子相位估计(QPE)在容错量子硬件上的潜力。整体思路是将量子计算机定位为经典高性能计算工作流中的特定加速器,而非通用替代,反映出对当前硬件能力边界的务实判断。
微软量子团队推出了一款名为 QDK for Chemistry 的开源库,试图在领域科学家与量子算法开发者之间架起一座桥梁。作为微软量子开发套件(Quantum Development Kit)的扩展,它把化学领域的专有功能直接整合进更广泛的量子开发工具链中。这背后反映的,是微软量子对于「实用量子计算如何落地」的一套明确判断。
为什么要做一个化学专用的量子开发库
微软量子首席量子软件架构师 David Williams-Young 在介绍中给出了核心动机:量子计算机在化学、材料科学以及其他物理模拟领域确实具备变革性潜力,但真正可用的量子应用不会凭空出现,而是要通过量子技术与现代高性能计算、机器学习、人工智能的深度融合才能实现。
这里体现出一个关键的立场——混合计算模型(hybrid model)。在这个模型中,量子计算机并不是通用计算的替代品,而是作为一个「关键加速器」,专门处理它最擅长的那部分问题,其余工作仍交由经典计算完成。这种定位相对克制,也更贴近当前量子硬件的实际能力边界。
问题在于,领域科学与量子算法开发各自的软件生态是割裂的。虽然两边都有成熟稳健的软件方案,但彼此之间的互操作性(interoperability)尝试稀少且难以维护。QDK for Chemistry 要解决的正是这个痛点:把互操作性当作一项核心设计特性,而非事后补丁。
一个典型工作流:从分子结构到量子电路
要理解这个库的价值,最好的方式是看一个同时包含经典与量子计算组件的典型工作流。
从领域描述出发
化学研究者通常从一个领域专有的问题描述入手——在化学里,这往往是来自实验、数据库或其他量子化学流程的 2D 或 3D 分子结构。这种形式能描述问题本身,但距离能被映射到量子计算机上,中间还有大量工作要做。
生成经典数据
在抵达量子计算机之前,需要执行一整套复杂的经典计算流程,生成用量子算法语言表达问题所需的数据。对化学家而言,这通常包括若干常见环节:
- 几何结构优化(geometry optimization)
- 自洽场计算(self-consistent field calculations)
- 活性空间选择(active space selection)
- 生成连接经典与量子算法的桥梁数据,例如构造活性空间哈密顿量,以及作为量子算法初始猜测的量子态经典近似
活性空间选择(active space selection) 是量子化学中降低计算规模的关键步骤。真实分子拥有大量电子轨道,但对化学反应和分子性质影响最大的往往只是其中少数几个「活跃」轨道——通常是能量接近前线轨道(HOMO/LUMO)的那些。活性空间方法将完整轨道空间划分为始终占据的冻结核心轨道、参与关联计算的活性轨道,以及始终为空的虚轨道,只对活性部分进行高精度处理,从而大幅压缩计算量。这一步骤的选择质量直接影响后续量子算法所需的量子比特数量和电路深度:活性空间越大,量子优势越突出,但资源需求也随之指数级上升。自洽场计算(SCF,常见实现为 Hartree-Fock 方法)则是为活性空间计算提供初始轨道和参考态的前置步骤,其输出的单粒子轨道是构造活性空间哈密顿量的基础。
转入量子算法语言
拿到这些经典数据后,就可以用量子算法的语言来表述问题。David 坦言这一环节「有意保持模糊」,因为从量子计算的物理模拟中提取有意义结果的方式有很多。
微软量子应用团队本身更偏爱 量子相位估计(Quantum Phase Estimation,QPE),认为这一类算法是在规模化、容错量子计算机上实现「量子实用性」最有希望的候选者。而其他近期算法大致遵循相同流程,包括选择费米子到量子比特的编码(fermion to qubit encoding)、针对状态制备的电路与量子比特算符的领域专有优化,以及把高层电路映射到量子硬件原生门集以供执行。
量子相位估计(Quantum Phase Estimation,QPE) 是一类核心量子算法,用于估算某个幺正算符的特征值对应的相位。在量子化学中,它被用来精确提取分子哈密顿量的基态能量——这正是经典计算机在分子规模增大后难以高效完成的任务。QPE 的基本思路是:将目标系统的时间演化算符反复作用于初始量子态,再通过量子傅里叶变换读出相位信息,从而推断出能量本征值。它对量子比特数量和电路深度要求较高,因此通常被视为需要容错量子硬件才能真正发挥优势的算法,而非当前含噪中等规模量子(NISQ)设备的首选。这也解释了为什么微软将 QPE 与「规模化、容错量子计算机」挂钩,而不是强调近期硬件上的应用。与之形成对比的是变分量子本征求解器(VQE),后者更适应当前含噪硬件,但精度和可扩展性存在上限。
回到标准量子软件工程
一旦得到所选算法的电路,流程就进入微软量子开发套件暴露的标准量子软件工程环节——调试、模拟,以及在量子硬件上执行电路。
模块化设计:解耦与标准化接口
QDK for Chemistry 最值得关注的,是它的设计哲学。上述工作流虽然被刻意简化成一个个独立模块,但这种拆分恰恰是核心思路:每个阶段都作为自定义点(customization point)暴露出来,彼此通过标准化的数据接口耦合。
这意味着,某个阶段(例如活性空间选择)内部如何实现,不必影响其他阶段的内部机制。各环节的最终输出会累积影响量子计算结果,但实现细节相互隔离。
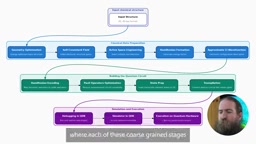
这种「关注点分离」(separation of concerns)的模式带来了对不同用户群体的覆盖能力:
- 高层用户:可以直接混搭经过良好测试的稳健组件来解决问题,无需深入软件兼容性和工程细节。
- 开发者:借助轻量级接口,专家可以专注于自己关心的问题,而不必操心软件栈中其他部分的实现细节。
微软希望借此培育一个围绕实用量子应用的创新社区。
费米子到量子比特编码(fermion-to-qubit encoding)是将电子结构问题从化学语言映射到量子计算机语言的桥梁。电子是费米子,满足泡利不相容原理,其量子态的数学描述使用二次量子化的产生湮灭算符表达。而量子计算机操作的是量子比特(qubit),需要将这些费米子算符转译为量子比特上的泡利算符串。常见的编码方案包括 Jordan-Wigner 变换(直接映射,局域性差但直观)和 Bravyi-Kitaev 变换(更紧凑的表示,门数量更少)。编码方案的选择会直接影响最终量子电路的门数和深度,进而影响在真实硬件上的错误率与运行成本。这正是 QDK for Chemistry 将编码策略作为独立自定义点暴露的原因之一——不同硬件架构和不同分子体系可能需要不同的最优编码方案。
对开发者的意义
从整体来看,QDK for Chemistry 代表的是一种务实的量子软件工程思路:不夸大量子计算的通用能力,而是把它嵌入到更大的经典科学工作流中,作为特定环节的加速器。模块化、标准化接口的设计,降低了跨领域协作的门槛,也为未来各组件的独立演进留出空间。
该项目已开源,代码托管在 github.com/QDK-chemistry,代码与文档链接均可在原视频下方找到。微软量子团队也预告了后续会由应用团队其他成员带来对各组件的深入讲解。
对于正在探索量子化学模拟、或关注量子-经典混合计算落地路径的研究者和开发者来说,这是一个值得跟进的开源框架。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。