为什么AI编程智能体不该自己测试代码?

新研究发现禁止AI编程智能体自写测试反而提升效率,核心原因是建造者与检查者必须分离。
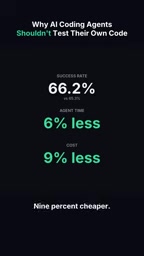
一项新研究发现,阻止AI编程智能体为自己生成测试用例,反而能提升任务成功率,同时带来约6%的速度提升和约9%的成本下降。原因在于:同一个智能体写代码和写测试时共享同一套需求理解,测试必然沿着代码的逻辑自我通过,形同虚设。解决方案不是取消测试,而是引入职责分离——由独立的测试智能体从用户视角出发,在真实浏览器中执行端到端流程验证,将失败结果反馈给编程智能体修复。文章介绍的Kane CLI工具正是这一思路的实现。这一结论对AI辅助开发工作流有重要启示:单个智能体的能力强弱不是关键,系统中是否存在真正独立的检查环节才是可靠性的核心。
一个反直觉的研究结论
当下的AI编程智能体——无论是Devin、Cursor还是Factory——都能写代码、跑测试、自动修复问题。但一项新研究抛出了一个与直觉相反的结论:阻止AI编程智能体为自己编写测试,反而能让它们表现更好。
研究给出的数据相当具体:当编程智能体不再自己生成测试时,任务成功率提升,整体速度快了约6%,成本也降低了约9%。听起来像是在开倒车——测试难道不是越多越好吗?但问题的关键不在测试本身,而在于谁来做这个测试。
问题出在哪:建造者不能同时当检查者
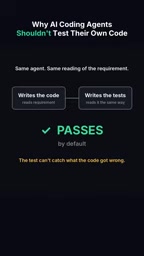
核心逻辑其实很朴素。编程智能体在写代码时,是基于它自己对需求的理解来实现的。当这同一个智能体再去写测试,它用的仍然是同一套对需求的解读。
结果就是:它写出的测试,几乎必然会通过它自己写的代码。因为两者源自同一个思维模型,测试并没有引入任何外部视角去质疑实现是否真的符合用户预期。
这意味着你多花了算力和时间去跑测试,却没有得到任何有价值的检验——测试默认通过,形同虚设。你为一场自我验证的表演付了钱。
自测的根本缺陷
这不是智能体能力不足的问题,而是结构性的利益冲突。在传统软件工程里,让开发者为自己的代码写单元测试当然有价值,但那是人类工程师——人会犯"理解偏差"的错,而测试恰恰是帮助发现这种偏差的手段之一。
但当AI智能体既是建造者又是检查者时,它的"理解偏差"会同时渗透进代码和测试两端。如果它误读了需求,它写的测试也会沿着同样的误读去验证,最终"顺利通过",掩盖了真正的问题。
结论不是跳过测试,而是别让建造者成为唯一的检查者。
这一问题在软件工程领域有一个对应的认知论根源:确认偏误(Confirmation Bias)。人类工程师写测试时,也容易不自觉地只验证"自己认为正确的路径",这正是为什么许多团队推行测试驱动开发(TDD)——先写测试、再写实现,强迫开发者在动手之前就明确"什么叫做正确"。但TDD对AI智能体同样失效:即便让智能体先写测试,它依然是用同一个语言模型在同一个上下文窗口中理解需求,无法真正割裂"出题者"与"答题者"的认知来源。这也是为什么解决方案必须在系统架构层面引入分离,而不能仅靠调整单个智能体的提示词顺序来解决。
一种解法:让独立的智能体去测真实应用
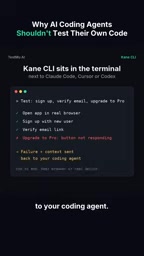
针对这个问题,视频中介绍了一个名为 Kane CLI 的工具。它的思路是把测试环节从编程智能体手中剥离出来,交给一个独立的测试智能体。
Kane CLI 直接运行在你的终端里。你用自然语言描述一个用户操作流程(user flow),它会在真实浏览器中实际执行这个流程,然后把失败的情况反馈给你的编程智能体去修复。
这不还是AI在写测试吗?
这是最自然的质疑:用另一个AI来测试,不还是"AI写测试"吗?
答案是肯定的——它确实是AI在做测试。但差别在于分工和视角:
- 编程智能体负责写代码,它关心的是实现逻辑;
- 测试智能体负责验证真实运行中的应用,它关心的是用户实际看到和体验到的东西。
两个智能体不共享同一套对代码的理解。测试智能体从"用户视角"出发,在真实浏览器里跑完整流程,验证的是最终呈现的结果,而不是代码内部逻辑是否自洽。这就引入了编程智能体缺失的那个外部检查视角。
这种"用户视角验证"在工程实践中对应的是端到端测试(End-to-End Testing,E2E),与单元测试、集成测试共同构成测试金字塔的顶层。E2E测试模拟真实用户在真实环境中的操作路径,验证的是整个系统从输入到输出的完整行为,而非某个函数或模块的内部逻辑。传统E2E工具(如Selenium、Playwright)需要工程师手动编写脚本来描述用户操作;Kane CLI的思路是用自然语言代替脚本编写,由测试智能体负责将自然语言转译为实际的浏览器操作序列。这使得非技术人员也能参与描述验收场景,同时保留了E2E测试"贴近真实用户体验"的核心优势。
对AI编程工作流的启示
随着编程智能体越来越深入开发流程,这个研究提出的问题值得团队认真思考。盲目地让一个智能体包揽"写代码—写测试—自我验证"的全链条,很可能只是制造了一种"看起来被测过"的假象。
更稳健的做法,是在工作流中引入职责分离:
- 代码生成与质量验证由不同的智能体承担;
- 测试尽量贴近真实用户环境(如真实浏览器中的端到端流程),而非仅停留在代码单元层面;
- 测试结果作为独立反馈回流给编程智能体,形成闭环修复。
这种架构既能避免"自我验证"的盲区,又能在成本和速度上获得意外收益——因为无效测试被剔除后,智能体不再在无意义的验证上浪费资源。
归根结底,AI辅助开发的可靠性,不取决于单个智能体有多强,而取决于整个系统是否存在真正独立的检查环节。感兴趣的开发者可以在 testmuai.com 上尝试相关工具。
相关推荐

Alexa Plus一年实测:智能家居之王,为何仍走不出家门?
The Verge播客实测Alexa Plus近一年:语音创建自动化场景体验出色,成为最强智能家居助手,但跨出家门做通用助理却屡屡碰壁。亚马逊500美元新平板欲补个人情境短板,苹果Siri AI也将入场,智能家居之争背后是技术成熟与隐私信任的深层张力。

智能体变慢或出错时,用Traces在Foundry中精准排查
智能体响应慢或输出错误时该从哪排查?本文详解 Microsoft Foundry 的 Traces 追踪功能,涵盖连接 Application Insights、读懂 span 层级、查看元数据与多种视图,帮助开发者高效定位 AI 智能体问题。
18亿美元全球承诺:为AI准备生物数据意味着什么
一项18亿美元的全球资金承诺瞄准AI-ready生物数据,旨在解决AI驱动生命科学中的数据瓶颈。本文解析这笔投资的意义、潜在影响与现实挑战。