豆包DeepSeek写论文初稿的致命问题及正确用法

AI写论文应作思路辅助而非内容生成,文献必须来自真实数据库。
豆包、DeepSeek等通用AI未接入知网数据库,直接生成论文会导致参考文献造假和AI检测率过高。正确做法是先从知网获取真实文献,再让AI辅助梳理大纲框架,最终由人工组织内容并通读内化,将AI定位为"思路辅助者"而非"内容生产者"。
核心问题:AI写论文的致命短板
很多同学在写毕业论文时,第一反应就是打开豆包或DeepSeek广告,让AI直接生成一篇初稿。看似高效,实则埋下了巨大隐患。
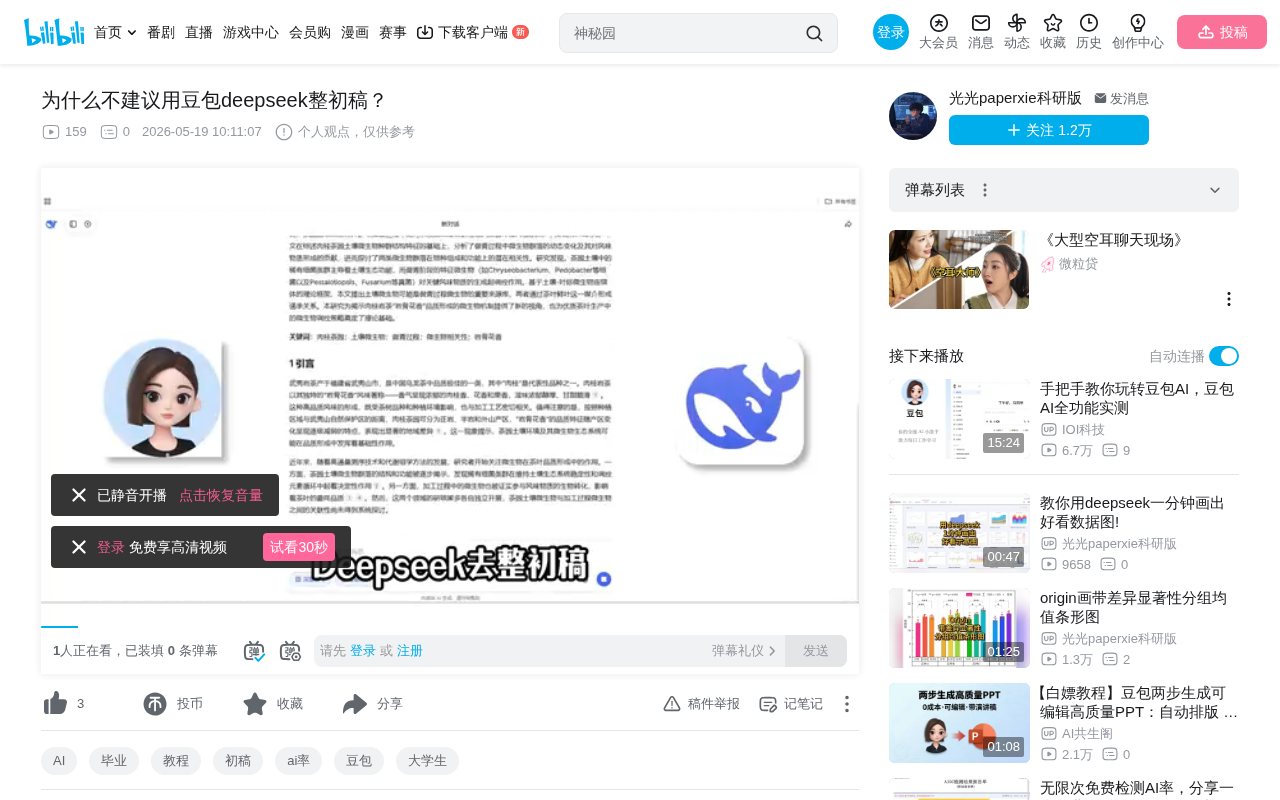
根据B站UP主的分析,核心原因在于:这些通用AI工具本身没有接入知网数据库。这意味着它们生成的参考文献大多是"自由发挥"——看起来格式规范,实际上可能根本不存在。你以为AI在搞学术,其实它在搞创作。
AI幻觉与参考文献造假的技术原理
豆包和DeepSeek等大语言模型之所以会编造参考文献,根本原因在于它们的工作原理是基于概率的文本生成,而非数据库检索。大语言模型(LLM)通过海量文本训练后,学会了"论文引用应该长什么样"的模式——包括作者姓名格式、期刊命名规律、年份分布等。当你要求它提供参考文献时,它实际上是在"续写"一个看起来合理的文本序列,而非从真实数据库中调取记录。这种现象在AI领域被称为"幻觉"(Hallucination),即模型以高置信度输出事实上不正确的信息。除非模型通过RAG(检索增强生成)技术实时连接到知网、Web of Science等学术数据库,否则它生成的任何具体文献信息都不可信。
常见误区:复制粘贴式整合
误区一:让AI凭空生成全文
直接让豆包或DeepSeek写完整论文,产出的内容有两个致命问题:
- 参考文献造假:AI会编造看似真实的论文标题、作者和期刊名,一旦导师或查重系统核实,后果严重
- AI痕迹明显:生成内容的行文模式高度统一,被AI检测工具识别的概率极高
误区二:先找文献再一股脑丢给AI
有些同学稍微进阶一点,先去知网找一堆文献,然后全部丢给AI让它整合。这种做法的问题在于,AI整合后的文本依然带有强烈的机器生成特征。结果查AI率的时候直接沉默——改了三天三夜,AI率纹丝不动。
更麻烦的是,微谱和格子达等检测工具还在不断升级算法,手动硬改的效果越来越差,效率低还容易把逻辑改崩。
AI检测工具的工作机制
微谱、格子达、以及国际上的GPTZero、Turnitin AI Detection等工具,其检测原理主要基于文本困惑度(Perplexity)和突发性(Burstiness)两个指标。困惑度衡量的是文本的可预测程度——AI生成的文本由于始终选择高概率词汇,困惑度普遍偏低,行文过于"流畅均匀"。突发性则衡量句子长度和复杂度的变化幅度——人类写作通常长短句交替、风格波动较大,而AI输出则趋于平稳。此外,这些工具还会分析词汇多样性、句式结构重复率、过渡词使用频率等特征。随着检测算法持续迭代训练,简单的同义词替换或句式调整已经越来越难以骗过系统,这也是为什么"手动硬改"效率越来越低的原因。
正确思路:知网+DeepSeek的高效配合
与其死磕人工降AI率,不如从源头上解决问题。以下是一个相对省事的工作流程,30分钟内可以整出一篇格式规范、AI率相对稳定的初稿框架。
第一步:从知网获取真实文献
- 在知网输入论文关键词
- 筛选近5年的文献(保证时效性)
- 点击小田字格,快速浏览摘要和关键词
- 挑选十几篇真正能用的文献
重点提醒:参考文献记得直接导出引用格式(GB/T 7714等),后面排版能省很多事。
知网文献检索的实操技巧
中国知网(CNKI)是国内最大的学术文献数据库,收录了超过8000种学术期刊、博硕士论文、会议论文等资源。在检索时,"近5年"的筛选标准不仅是为了保证时效性,更是因为很多学校的论文写作规范明确要求参考文献中近5年文献占比不低于50%。所谓"小田字格"是知网搜索结果页面的网格视图模式,可以在不逐篇打开的情况下快速浏览每篇文献的摘要、关键词和被引次数,极大提升筛选效率。GB/T 7714是中国国家标准《信息与文献 参考文献著录规则》,知网支持一键导出该格式的引用信息,可直接粘贴到论文参考文献列表中,避免手动录入时常见的格式错误。
第二步:让AI做大纲而非全文
把筛选好的文献内容和你的研究方向整理好,交给DeepSeek先做大纲。
这一步的关键是:别上来就让它直接生成全文,不然大概率又是"AI味拌饭"。让AI帮你梳理逻辑框架,明确每个章节写什么、用哪些文献支撑。大纲出来后,你会发现思路一下就顺了。
第三步:套入学校格式模板
目录、页眉页脚、参考文献格式——这些机械性的排版工作,能用工具处理就别自己熬夜调。把学校的格式要求直接套进去,让系统帮你解决格式问题。
第四步:通读与内化
最后也是最关键的一步:把内容自己通读一遍,确保你理解每一段在说什么。毕竟答辩的时候老师随便一问"这一段什么意思",你总不能表现得像第一次见到自己的论文。
总结:AI是工具不是替代品
正确使用AI写论文的核心逻辑是:
- 文献必须真实:从知网等正规数据库获取,不依赖AI编造
- AI负责框架:让它帮你理清思路和结构,而非生成最终文本
- 人工负责内容:基于真实文献,用自己的语言组织论述
- 格式交给工具:机械性排版工作不必手动完成
这个流程的本质是把AI从"内容生产者"降级为"思路辅助者",既利用了AI的效率优势,又规避了AI率过高和文献造假的风险。与其花三天降AI率,不如花30分钟把工作流理顺。
RAG技术与学术AI工具的发展方向
值得关注的是,当前学术写作领域正在兴起一类新型AI工具,它们通过RAG(Retrieval-Augmented Generation,检索增强生成)技术,将大语言模型与真实学术数据库连接。例如Consensus、Semantic Scholar、Elicit等工具,能够基于用户提问检索真实论文,再由AI总结归纳。这种架构的核心优势在于:生成内容有据可查,每个论点都能追溯到具体文献。国内也有类似产品开始接入知网、万方等数据库。未来,学术AI工具的发展方向必然是"检索先行、生成在后",而非当前通用模型的"凭记忆生成"模式。但即便如此,AI输出仍需人工审核,因为模型可能误读文献含义或断章取义。
核心要点
- 豆包和DeepSeek未接入知网数据库,生成的参考文献多为虚构,不适合直接写论文初稿
- 直接让AI生成全文或整合文献,AI检测率极高且难以通过手动修改降低
- 正确做法是先从知网获取真实文献,再让AI辅助生成大纲框架而非全文
- 参考文献应直接从知网导出标准引用格式,避免后期排版返工
- 最终内容必须自己通读内化,确保答辩时能够解释每一部分的含义
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
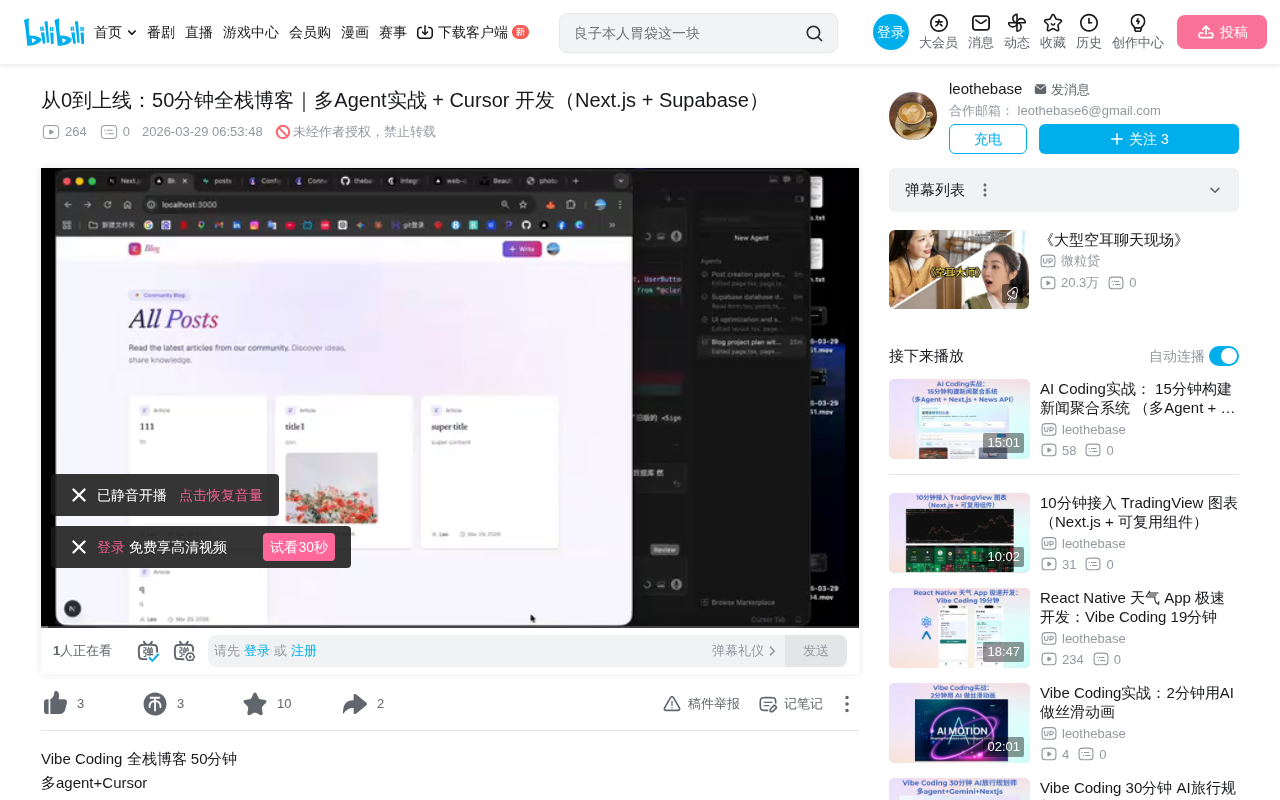
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。