未知自适应策略下的Bandit迁移学习:上下界新突破

研究未知自适应策略生成历史数据下的多臂老虎机迁移学习,提出KL-UCB-Transfer算法并刻画遗憾边界。
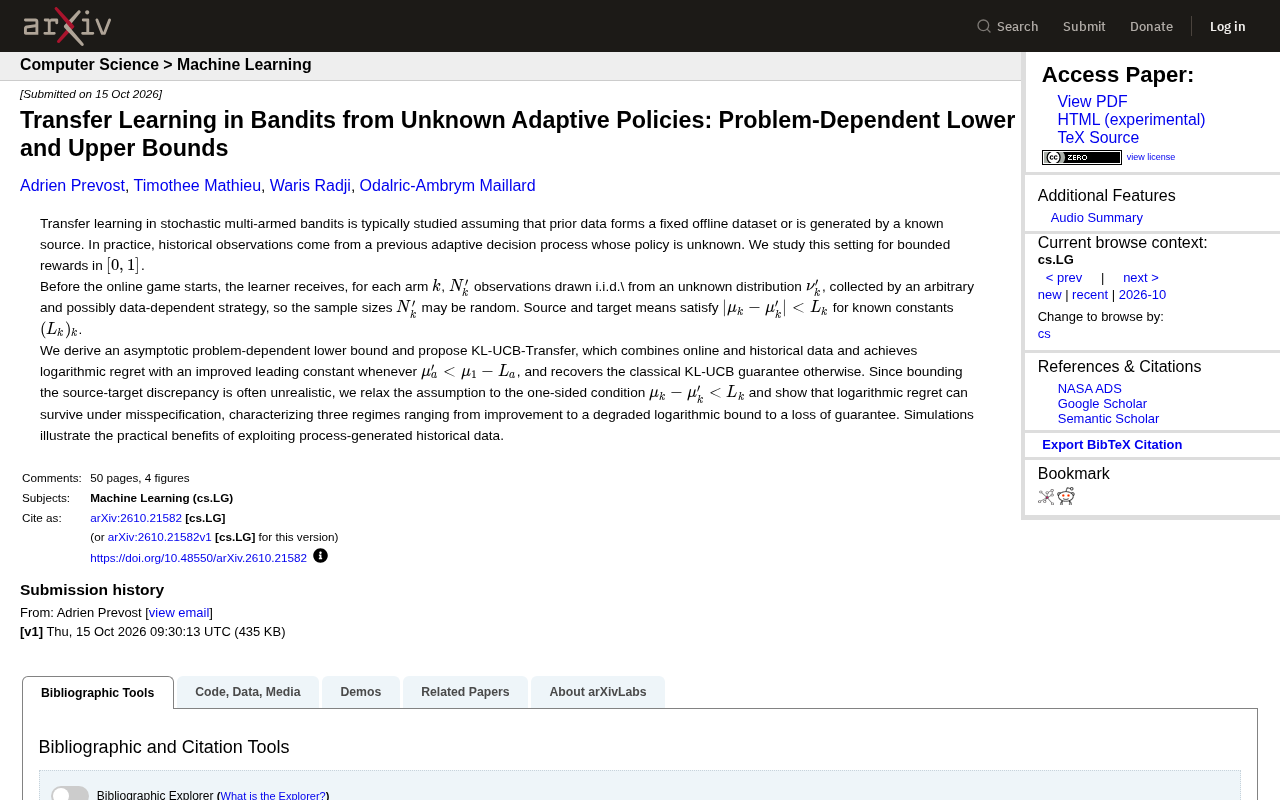
本文研究历史数据来自未知自适应策略的多臂老虎机迁移学习问题。传统迁移学习假设源策略已知或数据为固定离线数据集,而本文直面更现实的场景:历史观测由任意且可能数据依赖的策略收集,样本量随机。研究者提出KL-UCB-Transfer算法,融合在线数据与历史观测,在双边约束下实现对数级遗憾,并在次优臂满足μ'_a < μ_1 - L_a时获得更优领头常数,否则优雅退化为经典KL-UCB。进一步将约束放松为单边条件,揭示改进区域、退化对数区域和保证丧失区域三类截然不同的遗憾表现,为实践者判断历史数据可信度提供理论标尺。仿真验证了利用过程生成历史数据的实际收益。
多臂老虎机(Multi-Armed Bandit)中的迁移学习,长期以来建立在一个理想假设之上:历史数据要么是固定的离线数据集,要么来自一个已知的数据生成策略。但现实远比假设复杂——你手中的历史日志往往来自某个未知的、甚至依赖数据的自适应决策过程。当这个过程的策略未知时,迁移学习还能带来收益吗?
问题设定:当历史数据来自"黑箱"
这项研究聚焦于[0,1]有界奖励下的随机多臂老虎机。在学习者开始在线博弈之前,每个臂k会收到N'_k个观测值,这些数据独立同分布地来自一个未知分布ν'_k。关键在于:这些观测值是由一个任意且可能数据依赖的策略收集的,因此样本量N'_k本身也可能是随机的。
源均值与目标均值之间满足|μ_k - μ'_k| < L_k,其中L_k是已知常数。这个设定绕开了传统迁移学习对"已知源策略"的依赖,直接面对最棘手的场景——你只知道历史数据大致分布在哪里,但不知道它是怎么被收集的。
多臂老虎机中的遗憾(regret)是一个核心指标,用于衡量在线学习策略相对于始终选择最优臂的“先知策略”所累积的损失。具体而言,T轮博弈后的遗憾定义为最优臂期望奖励的T倍,减去实际策略获得的期望奖励总和。在迁移学习场景下,遗憾的定义需要同时考虑在线探索成本与历史数据的利用效率。
KL散度(Kullback-Leibler divergence)是衡量两个概率分布之间差异的非对称度量,在老虎机问题中扮演关键角色。对于伯努利分布,臂a的均值μ_a与其估计值之间的KL散度可精确刻画置信边界的紧致程度。KL-UCB正是基于这一度量构建置信上界,相比UCB1等基于Hoeffding不等式的算法,能在伯努利奖励下实现更紧的遗憾界。
在迁移学习设定中,历史数据由未知自适应策略收集,意味着样本量N'_k本身是随机变量,且可能与臂的奖励分布存在相关性。这打破了传统统计估计中“样本量固定且独立于数据”的假设,使得基于固定样本量的浓度不等式不再直接适用。研究者必须处理这种“策略依赖的样本量”带来的额外不确定性,这也是问题复杂性的根源之一。
KL-UCB-Transfer:融合在线与历史的算法设计
研究者提出了KL-UCB-Transfer算法,它将在线数据与历史观测结合起来,在经典KL-UCB框架上做了关键扩展。算法能够实现对数级遗憾,并且在μ'_a < μ_1 - L_a的条件下获得更优的领头常数——这意味着当历史数据中某个次优臂确实不如最优臂时,算法能够更高效地利用这一信息。
当上述条件不满足时,算法退化为经典KL-UCB的保证。这种"优雅降级"的设计思路,使得算法在历史数据有用时充分获益,在历史数据无用时也不会造成额外损失。
遗憾的领头常数(leading constant)指遗憾渐近表达式中对数项前面的系数,它决定了长期累积损失的量级。例如,经典KL-UCB的遗憾约为Σ_{a≠1} (μ_1-μ_a) log T / KL(μ_a, μ_1)。当历史数据提供了次优臂的有用信息时,算法可以更早地排除某些臂或更精确地估计其均值,从而降低这个系数。KL-UCB-Transfer在μ'_a < μ_1 - L_a条件下获得的更优领头常数,正是通过将历史观测纳入置信边界的构造,减少了对次优臂的在线探索需求。
“优雅降级”是算法鲁棒性设计中的常见理念:当辅助信息可靠时充分利用,当辅助信息不可靠或条件不满足时,算法性能不会比不使用辅助信息更差。在KL-UCB-Transfer中,当μ'_a < μ_1 - L_a不成立时,历史数据可能误导对臂均值的估计,此时算法自动退化为经典KL-UCB的遗憾保证,确保最坏情况下仍具有对数级遗憾。这种设计避免了负迁移的风险。
从双边到单边:更现实的假设放松
实际场景中,精确界定源与目标之间的差异往往不现实。研究者进一步将双边约束放松为单边条件μ_k - μ'_k < L_k,并分析了模型误设下的表现。
这一放松揭示了三类截然不同的区域:
- 改进区域:历史数据仍然带来遗憾的降低
- 退化对数区域:遗憾仍为对数级,但常数变差
- 保证丧失区域:对数级遗憾不再成立
这种精细的区域划分,为实践者判断"何时该信任历史数据"提供了理论标尺。
双边约束|μ_k - μ'_k| < L_k要求源均值与目标均值之间的差异在正负两个方向上都有界,即历史数据既不能高估也不能低估目标均值超过L_k。而单边条件μ_k - μ'_k < L_k只限制目标均值不能比源均值高出超过L_k,但允许目标均值远低于源均值。这一放松更符合实际:历史数据可能来自一个奖励普遍偏高的环境(例如更活跃的用户群体),迁移到目标环境时奖励会下降,但反向的剧烈上升则较少见。
模型误设(model misspecification)指真实数据生成过程与算法假设的模型不一致。在迁移学习中,误设通常表现为源与目标分布差异超出预设的L_k范围。研究者分析模型误设下的表现,是为了回答:当历史数据比预想更不可靠时,算法是否还能保持理论保证?三类区域的划分正是对这一问题的精细回答,其中“保证丧失区域”意味着对数级遗憾不再成立,算法可能遭受线性级遗憾,提示实践者需要谨慎评估历史数据的可信度。
核心贡献与启示
该工作首次在未知自适应策略生成历史数据的设定下,给出了问题依赖的渐近下界和匹配的上界算法。双边条件下的改进保证和单边条件下的三维区域刻画,共同构成了对迁移学习在bandit中适用边界的完整描述。仿真实验进一步验证了利用过程生成的历史数据所带来的实际收益。对于推荐系统、A/B测试等依赖历史交互日志的场景,这项研究提供了重要的理论指导。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。