WeightBench:大模型能否直接编程神经网络权重?

WEIGHTBENCH 以 42 项任务、五大赛道系统评测大模型直接读写神经网络参数的能力边界。
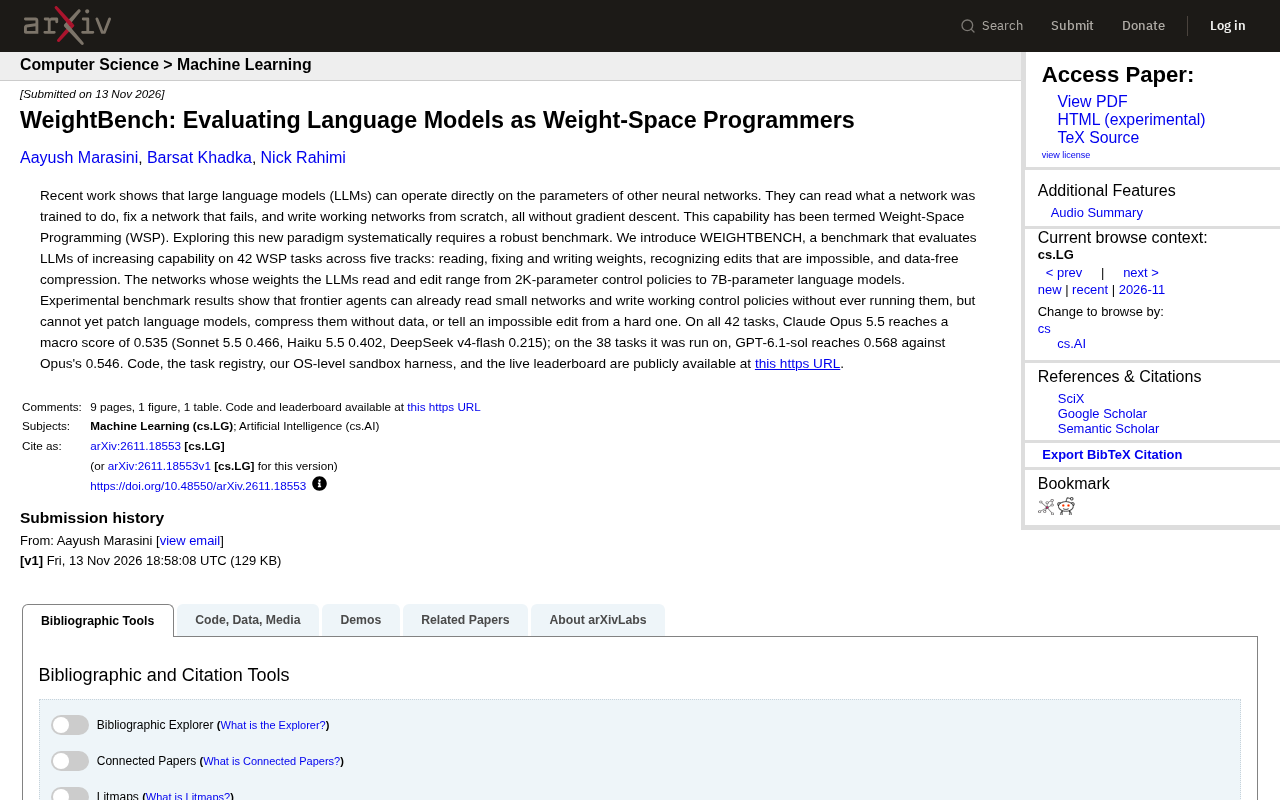
文章介绍权重空间编程(WSP)这一新范式:语言模型无需梯度下降,即可读取、修复乃至从零编写神经网络参数。为系统评估该能力,研究者推出 WEIGHTBENCH 基准,覆盖读取权重、修复权重、编写权重、识别不可能编辑、无数据压缩五大赛道,共 42 项任务,网络规模从 2K 参数控制策略到 7B 语言模型。结果显示,前沿模型已能读取小型网络并编写可工作的控制策略,但在修补语言模型、无数据压缩和区分"不可能"与"困难"编辑上明显不足。Claude Opus 5.5 宏平均 0.535,GPT-6.1-sol 在 38 项任务上得 0.568。基准的沙箱框架、任务注册表与排行榜均已开源。
大型语言模型正从文本生成迈向对神经网络参数的直接操作。近期研究将这种能力称为权重空间编程(Weight-Space Programming, WSP):模型无需梯度下降,就能读取网络训练目标、修复失效网络,甚至从零编写可工作的网络。为系统评估这一新范式,研究者推出了 WEIGHTBENCH 基准,覆盖 42 项 WSP 任务,横跨五个赛道:读取权重、修复权重、编写权重、识别不可能编辑以及无数据压缩。受测网络规模从 2K 参数的控制策略到 7B 参数的语言模型不等。
五大赛道:从读取到压缩
WEIGHTBENCH 将权重空间编程拆解为五个能力维度。读取权重要求模型理解网络被训练来做什么;修复权重针对已失效的网络进行参数级修正;编写权重则要求模型不运行网络、不依赖梯度下降,直接生成可工作的控制策略。识别不可能编辑考察模型能否区分“难以修复”与“根本不可能修复”的编辑请求;无数据压缩则测试模型在缺乏原始训练数据时对网络进行压缩的能力。这五类任务共同勾勒出 WSP 的能力边界。
权重空间指神经网络全部可训练参数构成的集合,可以把它想象成一个高维向量空间:每个点对应一组具体参数,也就对应网络的一种行为方式。传统训练通过梯度下降在这个空间里逐步移动,寻找使损失下降的位置;而权重空间编程则要求语言模型直接在该空间中"读写"——或从参数推断训练目标,或把参数改写到能完成新任务的位置。理解这一概念的关键在于区分"参数"与"激活":前者是网络静态存储的知识载体,后者是输入经过网络时动态产生的中间表示。WSP 操作的是前者而非后者,因此不依赖前向传播来产生训练信号。
宏平均(macro-average) 是基准评测中常用的聚合方式:先分别计算每个任务(或每个赛道)的得分,再对所有任务取不加权的算术平均。与之相对的是微平均,它按样本量加权,会让样本多的任务主导总分。WEIGHTBENCH 采用宏平均,意味着 42 项任务无论大小权重相同,一个小规模控制策略任务与一个 7B 语言模型任务对最终分数的贡献一致。这使得分数更能反映能力的广度而非深度,也解释了为何不同模型之间的分差看似不大,却对应着显著的能力差异。
前沿模型的表现与短板
实验结果显示,前沿智能体已能读取小型网络,并在不运行的情况下编写可工作的控制策略。但在修补语言模型、无数据压缩以及区分不可能编辑与困难编辑方面,模型仍力有不逮。据论文数据,在全部 42 项任务上,Claude Opus 5.5 的宏平均得分为 0.535,Sonnet 5.5 为 0.466,Haiku 5.5 为 0.402,DeepSeek广告 v4-flash 为 0.215。在 Opus 实际运行的 38 项任务上,GPT-6.1-sol 取得 0.568 的得分,略高于 Opus 的 0.546。
这些数字传递出两个信号。其一,权重空间编程并非遥不可及,小型控制策略的读写已进入可操作阶段。其二,面对大规模语言模型,直接操作权重仍是一个开放难题,模型在压缩和修复上的表现明显落后于读取和编写。
基准设计的挑战与意义
构建 WSP 基准并不容易。权重空间编程缺乏传统代码生成那样的中间表示,评估时必须依赖网络的实际行为或参数级指标。WEIGHTBENCH 提供了操作系统级沙箱测试框架,确保模型在受控环境中操作权重,避免对宿主系统造成影响。任务注册表和实时排行榜的公开,也为后续研究提供了可复现的基础。
这一基准的价值在于将分散的 WSP 能力纳入统一评测框架。此前的研究往往针对单一任务展示模型潜力,而 WEIGHTBENCH 通过多赛道设计,揭示了能力之间的不均衡:读取强于编写,编写强于修复,修复强于压缩。这种细粒度画像有助于研究者定位瓶颈,而非笼统地宣称模型“理解”了权重。
操作系统级沙箱是一种隔离执行环境,通过命名空间、cgroups 或虚拟化等技术,把被测程序的文件系统、网络和进程访问限制在受控范围内。在 WSP 评测中,模型需要直接读写神经网络参数文件,甚至可能执行加载权重的代码,一旦失控可能损坏宿主环境或逃逸到外部系统。沙箱确保这些操作只作用于隔离副本,并在任务结束后可完整回滚。与仅做输入输出过滤的"应用级"防护不同,操作系统级隔离在更底层拦截系统调用,因而能容纳任意格式的权重文件和任意框架的加载逻辑,这也是该基准可复现性的技术基础。
参数级指标指不依赖网络运行、直接比较权重张量本身的评估方式,例如参数差异的范数、逐层余弦相似度或特定通道的扰动幅度。它与行为级指标(在测试输入上看输出是否正确)互为补充:行为级指标更贴近实际用途,但对大规模模型成本高且可能被"表面修复"蒙混;参数级指标廉价且可定位,却未必与功能恢复相关。WEIGHTBENCH 同时采用两类指标,正是为了在缺乏中间表示的情况下,仍能对 WSP 结果做出可解释的判断。
权重空间编程的下一步
从更广的视角看,WSP 代表了一种与主流微调范式不同的思路。传统方法通过数据驱动梯度更新来改变网络行为,而权重空间编程尝试让语言模型直接充当“权重程序员”,以推理替代优化。若这一能力成熟,模型调试、网络压缩和零样本策略生成都可能受益。但当前结果提醒我们,模型在识别自身能力边界方面仍有欠缺——分不清“做不到”与“很难做”,恰恰是自动化权重操作走向实用的关键障碍。
WEIGHTBENCH 的代码、任务注册表、沙箱框架和排行榜均已公开,这为社区提供了共同推进 WSP 研究的起点。随着模型能力提升,基准本身也需要演进,以覆盖更大规模网络和更复杂的编辑场景。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。