文本+参考音频生成AI音效:现状与可行方案

AI音频生成中「文本+参考音频」双重条件控制仍是前沿缺口,组合式流水线是当下最务实的应对方案。
本文围绕 Hacker News 上一则关于「能否用文本描述结合参考音频样本生成音效」的提问展开分析。文章梳理了音频生成的两大范式:纯文本到音频已初具商业和开源成果,而「文本+参考音频」的双重条件控制——类似图像领域的 ControlNet——仍是尚未被主流模型完整覆盖的能力。作者指出,音频生成整体滞后于视觉领域,根本原因在于高质量标注数据极度稀缺、声音语言描述贫乏,以及时序信号对长时程一致性和保真度的严苛要求。对于有实际需求的创作者,文章建议采用「先文本生成基础素材,再用参考音频做风格对齐」的分步组合工作流,同时保持对开源社区进展的持续关注。
一个被低估的AI生成需求
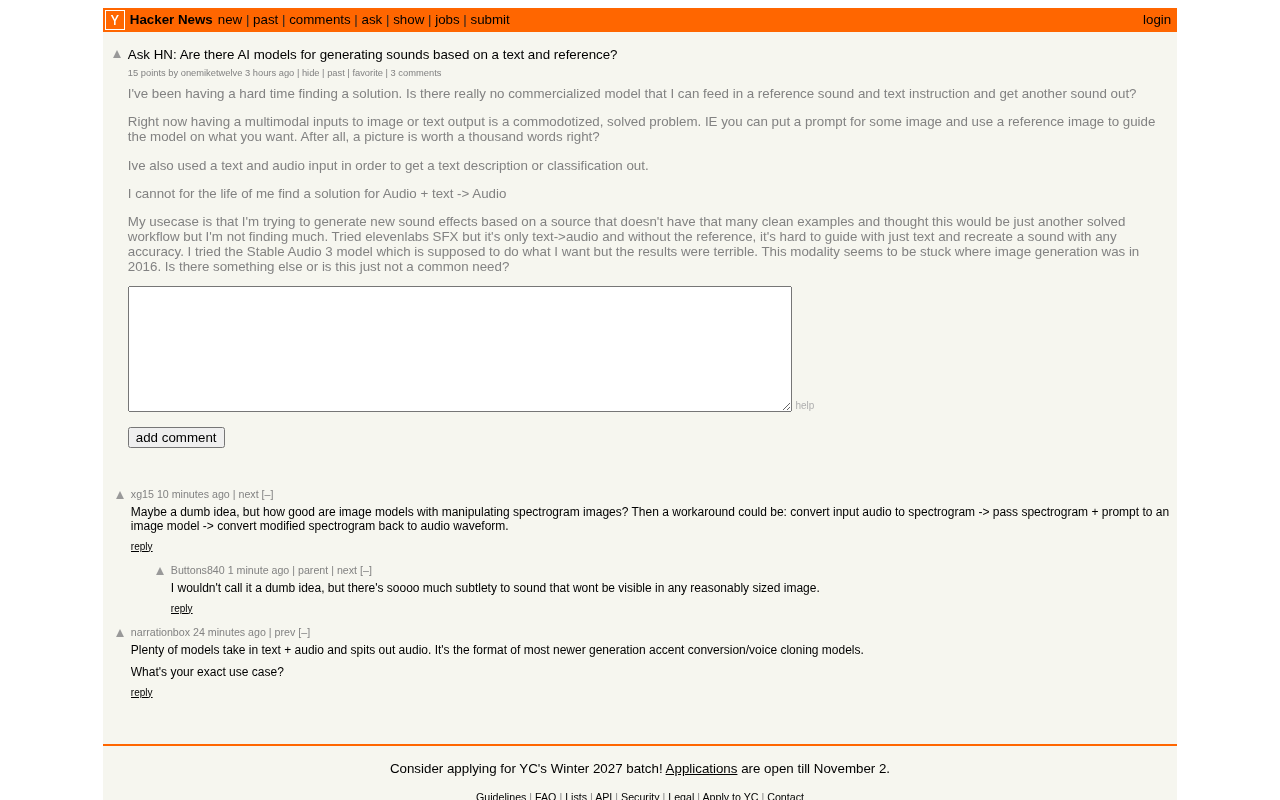
Hacker News 上一则 Ask HN 提问引出了许多开发者和创作者关心的话题:是否存在能够根据文本描述结合参考音频样本来生成声音的AI模型?这个问题看似小众,实际上触及了生成式AI在音频领域的一个关键缺口。
相比图像和文本生成的爆发式发展,音效(Sound Effects)与音频生成一直是相对低调的赛道。但随着游戏开发、短视频制作、独立创作者群体的扩大,对于「用一句话描述就能得到想要的音效」这类工具的需求正在快速增长。该帖子获得了15个点赞,评论虽少,却反映出这是一个仍在探索中的真实痛点。
文本到音频生成的技术路线
理解这个问题,需要先厘清音频生成的几种主要范式。
文本到音频(Text-to-Audio)
这是目前最成熟的方向,用户输入一段文字描述(如「雨点打在金属屋顶上」「远处的雷声」),模型输出对应的音效片段。这类模型通常基于扩散模型(Diffusion)或自回归架构,在大规模「音频-文本」配对数据集上训练而成。它的优势是交互直观,但生成结果的可控性往往有限,难以精确匹配创作者脑海中的具体声音。
目前该方向的代表性模型包括 Meta 的 AudioGen、Google 的 AudioLM 和 AudioPaLM,以及 Stability AI 推出的 Stable Audio。其中扩散模型路线(如基于 Latent Diffusion 的架构)将音频压缩到潜空间后进行去噪生成,可以在保持较高质量的同时缩短推理时间;自回归路线(如 AudioLM)则将音频离散化为 token 序列,逐步预测下一个音频单元,更擅长生成具有语义连贯性的长片段。训练数据方面,AudioSet(YouTube 上超过 200 万段标注音频片段)是最常用的基准数据集,但其标签粒度较粗,导致生成模型在细粒度语义理解上仍有明显局限。
参考音频引导(Audio Reference / Conditioning)
提问者真正感兴趣的是在文本之外叠加参考音频。这种做法类似于图像生成中的 ControlNet 或图生图(img2img)——用一段已有声音作为「风格或内容锚点」,让模型在保持某些特征的前提下,依据文本进行变体或扩展。例如,提供一段鸟鸣录音,再用文本要求「让它听起来更空旷、带回声」。
这种「文本+参考」的双重条件控制,恰恰是当前多数开源音频模型尚未完整覆盖的能力。它要求模型既能解析语义,又能从参考样本中提取音色、节奏、空间感等低层特征。
在图像领域,ControlNet 通过向扩散模型注入额外的结构化条件(如边缘图、姿态骨架),实现对生成结果空间布局的精确控制,而无需重新训练基础模型。音频领域的类似思路被称为「音频条件化」(Audio Conditioning),技术实现上通常借助预训练音频编码器(如 CLAP、EnCodec)将参考音频压缩为嵌入向量,再以交叉注意力或 AdaLN 等机制注入生成网络。难点在于,音频的「风格」本身难以被清晰解耦——音色、混响、节奏、频谱包络往往相互缠绕,单纯的嵌入向量很难完整捕捉创作者希望迁移的具体维度,这也是当前模型可控性不足的根本原因之一。
可供尝试的现有工具
尽管「文本+参考」的组合方案还不够成熟,社区中已有一些可以部分满足需求的方向:
- 文本到音效模型:目前已有若干开源与商业模型支持从文字描述生成环境音、音效片段,适合快速原型制作。
- 音频风格迁移 / 变体生成:部分模型支持以参考音频为条件进行声音转换,可用于音色迁移或声音修饰。
- 音乐生成模型:虽然偏向旋律与乐曲,但其中的条件控制机制对音效生成也有借鉴意义。
对于希望同时使用文本和参考音频的开发者,一个务实的做法是组合流水线:先用文本到音频模型生成基础素材,再通过音频处理或风格迁移模型用参考样本进行二次调整。
为什么这个领域仍在早期
音频生成相比视觉领域发展滞后,有几个结构性原因。
高质量的「音频-文本」标注数据远比图像稀缺,描述声音本身就比描述画面困难——人类对声音的语言表达相对贫乏。此外,音频是时序信号,长时程一致性和细节保真度的要求极高,微小的瑕疵在听觉上会被放大。
参考音频条件化更是增加了难度:模型需要在「忠于参考」和「响应文本」之间取得平衡,这类似于多模态对齐问题,目前尚无普遍认可的最优架构。
从数据规模上看,主流图文配对数据集(如 LAION-5B)已达到数十亿量级,而同等规模的「音频-自然语言描述」配对数据集至今仍未出现。人类语言在描述声音时天然匮乏:颜色、形状有丰富的词汇体系,而声音质感(如「湿润的低频轰鸣」「带金属感的摩擦」)往往只能借助通感和比喻,这给自动标注和模型学习都带来了额外困难。在信号处理层面,音频以波形或频谱图的形式存在,采样率通常在 16kHz 至 44.1kHz 之间,即使是 5 秒的片段也包含数万乃至数十万个数据点,建模长时程依赖关系的计算成本远高于同等时长的视频帧序列。
给创作者的实用建议
如果你当下就需要落地方案,可以从以下思路入手:
- 明确需求优先级:如果只需大致匹配文本描述,现成的文本到音效工具已足够;若必须贴合特定参考音,则需要接受更多手工后期。
- 分步处理:将「生成」和「风格对齐」拆成两个环节,用不同工具协作,往往比期待单一模型一步到位更现实。
- 关注开源社区进展:这一领域更新很快,持续跟踪 Hacker News、GitHub 上的新项目,可能很快就会出现专门支持双重条件的模型。
结语
这则简短的 Ask HN 提问,折射出生成式AI在音频领域尚待填补的空白。文本到音频已初具雏形,但「文本+参考音频」的精细化控制仍是前沿课题。对于创作者而言,现阶段最稳妥的策略是用组合式工作流弥补单一模型的不足,同时保持对社区进展的关注——这个赛道的突破,或许就在不远的将来。
相关推荐

Codex提示词被公开后,智能体的护城河还剩什么?
OpenAI的Codex系统提示词被公开,7100行规则暴露了智能体的运行逻辑。本文解析Harness框架、长任务可靠性、模型定价与开源替代,探讨提示词公开后AI智能体的护城河与估值之争。

Claude Haiku 5.5发布,谷歌AI水印检测工具全球开放
Anthropic发布速度最快、成本最低的Claude Haiku 5.5,谷歌SynthID水印检测工具全球开放,OpenAI推出GPT-6与Intelligent UI,欧盟收紧AI监管。本文梳理10月8日AI行业重点进展。

OpenAI推出GPT-6:Intelligent UI让回答从文字变成可交互界面
OpenAI发布GPT-6,面向全体ChatGPT用户推出Intelligent UI智能界面能力,让回答从纯文字变成可点、可用的交互界面。本文解析三类核心用法、组件库+编译器技术、响应速度提升与安全升级。