文本越短越难测?AI生成文本检测的长度校准与弃权机制

研究揭示短文本AI检测阈值失效风险,提出分箱校准稳定误报率并引入弃权机制。
本文系统研究了AI生成文本检测器在短文本(10-200 token)上的可靠性问题。作者首先给出闭式解,精确描述长文本阈值迁移到短文本时误报率的漂移规律,并以Binoculars在10 token时误报率飙升至29%为例验证。随后提出分箱校准方案,利用保形p值在每个长度区间单独校准阈值,在三个检测器、三个语料库和两个生成器上,将10-200 token每个组合的平均误报率稳定在5.0%名义值。然而实验发现没有任何检测器达到80%真阳性率,最佳者Binoculars在200 token时仅59%,促使弃权规则在多数区间触发。研究结论强调,部署AI文本检测系统需按长度测量性能曲线、匹配阈值并诚实弃权,而非假设长文本调参可迁移。
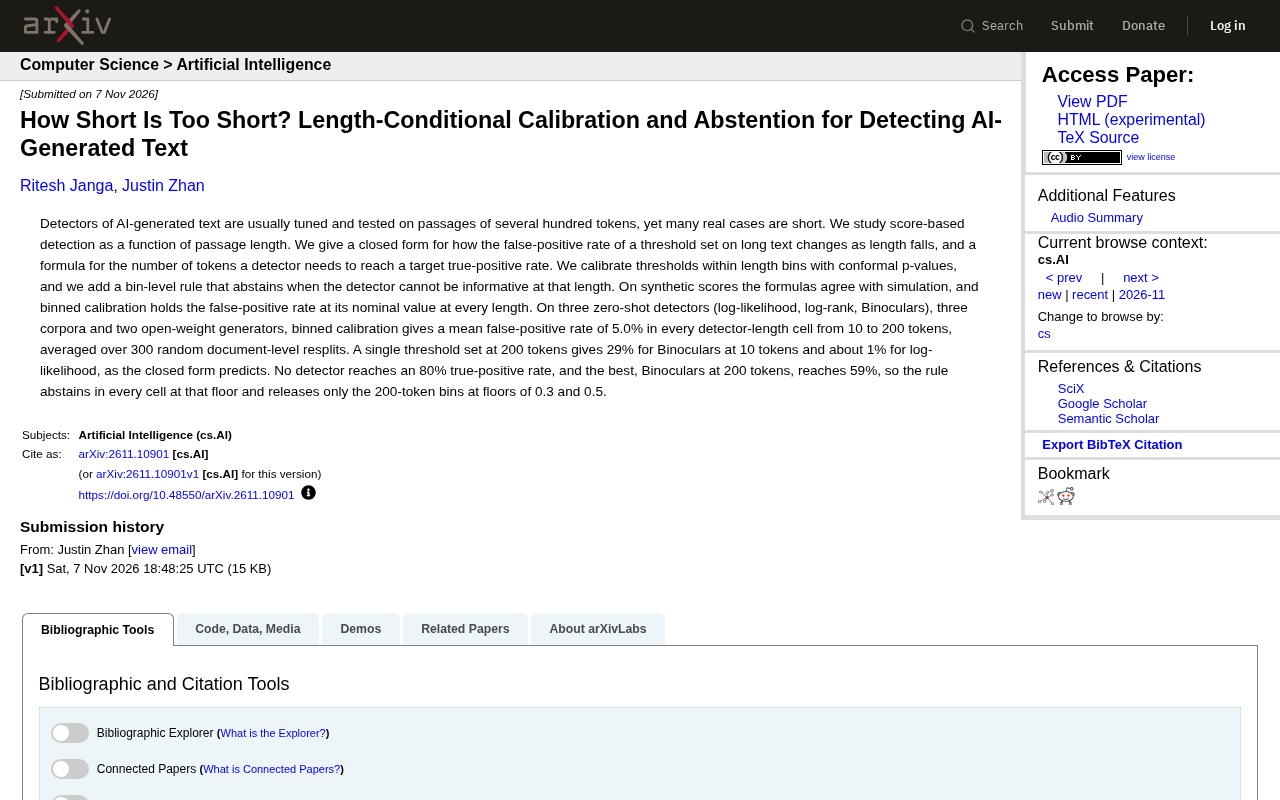
AI生成文本检测器通常用几百个token的段落来训练和测试,但现实中的待检测文本往往很短——一条社交媒体评论、一段代码注释、一句产品评价,可能只有几十个甚至十几个token。当文本长度急剧缩短,检测器的可靠性会发生什么变化?一篇题为《How Short Is Too Short? Length-Conditional Calibration and Abstention for Detecting AI-Generated Text》的研究,系统性地回答了这个问题,并提出了基于长度的校准与弃权方案。
短文本检测的隐藏风险:阈值失效
这项研究的出发点是一个被普遍忽视的工程现实:检测器的判定阈值通常是在长文本上设定的。当同一套阈值被直接套用到短文本上时,误报率(false-positive rate)会如何漂移?
作者给出了一个闭式解(closed form),精确描述了这个漂移过程:在长文本上设定的阈值,随着文本长度下降,误报率会以可预测的方式变化。同时,研究还给出了另一个公式——检测器需要多少token才能达到目标真阳性率(true-positive rate)。这两个公式构成了全文的理论骨架。
实验数据印证了公式的预测。以Binoculars检测器为例,在200 token长度上设定的单一阈值,当文本缩短到10 token时,误报率飙升至29%;而log-likelihood检测器在同一条件下的误报率约为1%。这说明不同检测器对长度变化的敏感度差异巨大,一刀切的阈值策略在短文本场景下极不可靠。
分箱校准:让误报率在每个长度上都稳定
针对上述问题,研究团队提出了分箱校准(binned calibration)方案:将文本按长度划分区间,在每个区间内用保形p值(conformal p-values)单独校准阈值。
效果相当显著。在三个零样本检测器(log-likelihood、log-rank、Binoculars)、三个语料库和两个开放权重生成器上,经过300次随机文档级重划分的平均结果显示:从10 token到200 token的每一个检测器-长度组合中,分箱校准都将平均误报率稳定在5.0%。
这个5.0%正是名义值(nominal value)——也就是说,无论文本多短,校准后的误报率都维持在设定水平,不再随长度漂移。对比之下,单一阈值方案的表现则如闭式解所预测的那样分化明显。
保形p值(conformal p-values) 是保形预测(conformal prediction)框架的核心产物。其基本思想是:利用一个留出的校准集,为每个新样本计算一个p值,该p值衡量“当前样本的检测得分”在参考分布中的分位水平。如果p值小于预设的显著性水平α(如0.05),则拒绝“该文本为人类撰写”的原假设,判定为AI生成。保形p值的优势在于无需假设得分分布的具体形式,仅依赖可交换性(exchangeability)即可在有限样本下保证误报率不超过α。在分箱校准中,作者对每个长度区间分别构建校准集并计算保形p值,从而使误报率控制具备长度条件性——这正是“分箱”与“保形”结合的关键。
弃权机制:承认检测器“不知道”
校准解决了误报率漂移,但另一个问题浮出水面:短文本上检测器可能根本没有足够信息做出判断。
研究引入了一个分箱级别的弃权规则(abstention rule):当检测器在某个长度区间内无法提供有效信息时,系统直接弃权,而不是强行给出一个不可靠的判定。
这个设计的触发条件很直观。实验中,没有任何检测器达到80%的真阳性率;表现最好的Binoculars在200 token时也只达到59%。因此,在80%真阳性率的要求下,弃权规则在每一个长度区间都触发了弃权——包括最长的200 token区间。只有当门槛放宽到0.3和0.5时,系统才释放200 token区间的判定结果。
换句话说,短文本检测的真实困境不是“误报率偏高”,而是“检测器在短文本上普遍缺乏足够的判别力”。弃权机制的价值在于把这个困境显式化,而不是用虚假的置信度掩盖它。
真阳性率(true-positive rate, TPR) 与误报率相对,指在所有实际为AI生成的文本中,检测器正确判为AI生成的比例,又称召回率(recall)。本文的弃权规则以TPR为触发条件:若在某个长度区间内,检测器在给定阈值下无法达到预设的TPR下限(如80%),则系统对该区间内所有样本弃权。这一设计将“检测器能力不足”转化为可操作的工程决策——弃权不是失败,而是对判别力上限的诚实声明。值得注意的是,TPR与误报率存在权衡:降低阈值可提高TPR但会推高误报率,因此在短文本上同时满足二者往往不可行,弃权成为唯一不产生虚假置信度的选择。
对实际部署的启示
这项研究的方法论意义大于其具体数字。它提示我们,任何AI文本检测系统的部署都需要回答三个层次的问题:
第一,阈值是否与文本长度匹配? 分箱校准的成本并不高,但能显著稳定误报率。对于需要在多种长度场景下运行的检测系统,这是必要的工程步骤。
第二,检测器在当前长度下是否具备足够判别力? 真阳性率上限的分析表明,短文本场景下检测器的能力天花板可能远低于预期。部署前应当明确各长度区间的性能边界。
第三,系统是否应该学会说“不知道”? 弃权机制提供了一种诚实的工程姿态:与其在信息不足时强行输出判定,不如把不确定性交给下游流程处理。这在内容审核、学术诚信审查等高风险场景中尤为重要。
研究的实验设置覆盖了三种检测器、三个语料库和两个生成器,交叉验证的广度为其结论提供了一定支撑。不过,59%的真阳性率上限也提醒我们:短文本AI检测仍是一个远未解决的问题,校准和弃权只是让系统在能力边界内更可靠地运行,而非突破边界本身。
对于构建检测管线的工程师而言,这项研究给出的最实用建议或许是:先测量你的检测器在不同长度上的表现曲线,再决定阈值和弃权策略——不要假设长文本上的调参结果能直接迁移到短文本。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。