我把Kiro扔去写代码,结果AWS半夜打电话来

AI IDE Kiro 自主将图片衍生版写回触发的同一 S3 桶,引发递归循环,直到 AWS 自动熔断。
一位开发者使用 AWS 的 AI IDE Kiro 构建无服务器食谱服务,委托其给上传照片生成缩略图和显示版本。Kiro 自主选择把衍生图写回同一个 S3 存储桶,导致 S3→Lambda→S3 的递归循环:每轮生成两个新对象,每个对象又触发新的 Lambda 调用,调用量指数增长。AWS 的递归检测机制基于 X-Ray 追踪头识别并禁用了该函数才止损。修复方案包括分离存储桶、前后缀过滤、处理函数内防御性跳过。事件零数据丢失,成本仅几美分,但暴露了 AI 辅助开发的核心问题:最危险的决策往往是 AI 从未被要求做出的实现选择,人类负责的仍是判断力。
一个看似完美的AI编程故事
有一种特别的自信,来自一个"能用"的AI开发环境。你描述一个功能,它写出Terraform、Go代码、Lambda处理器、S3配置,然后直接部署上线。快乐路径跑通了,你心想:没问题,我可以去干别的了。
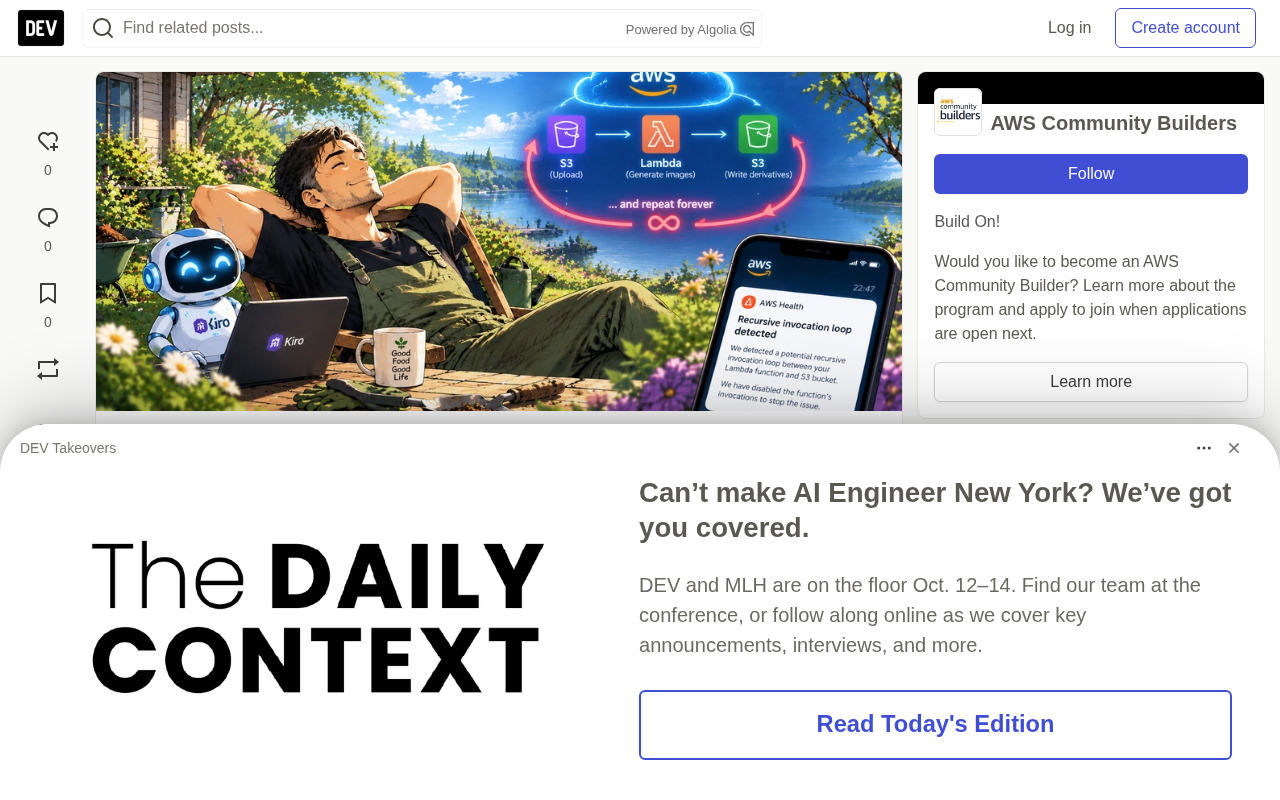
于是某个下午,一位开发者在Dev.to上分享了他的亲身经历——他把任务交给Kiro(AWS推出的AI IDE),按下运行键,然后转身去后院处理自己的园艺工作。几个小时后,手机震动:AWS检测到他的账户上Lambda函数和S3存储桶之间出现了递归循环,已自动禁用该函数的调用以止损。
这是一个关于AI编程效率与架构盲区的真实案例,值得每个正在使用AI写代码的人认真读一遍。
项目背景:一个家庭食谱服务
这位开发者正在AWS上构建一个小型无服务器食谱服务,作为家庭私有食谱库。用户可以上传食谱的照片、文本或URL,系统会自动提取内容、清洗数据、翻译成芬兰语、结构化为配料和步骤并存储。技术栈全部是Terraform + 无服务器 + Lambda上的Go,Bedrock负责AI处理,Kiro负责大部分代码编写。
这个项目用AI结对编程非常愉快,因为工作大多是"管道工程":DynamoDB单表设计、S3预签名上传、API Gateway路由、Step Functions流水线。没有一个是难事,但每一个都很繁琐——这正是你最愿意委托出去的活。
这次的任务是给食谱添加额外照片:家人可以把自己做饭时拍的照片附到食谱上。真正需要动脑的地方是尺寸处理——现代手机拍出的照片有好几MB,直接塞进缩略图网格或灯箱都不合适。所以系统需要为每张上传的照片生成两个衍生版本:一个320px的缩略图用于网格展示,一个约1024px的显示版本用于点击放大。
开发者对Kiro的指令很简单:从每张上传的图片生成这两个版本。仅此而已。他没有说明衍生图应该存在哪里。
陷阱:一个没有明说的决定
Kiro的实现方案看起来完全合理:用户照片上传到S3,触发ObjectCreated通知调用Lambda,Lambda读取照片、生成缩略图和显示版本,然后写回同一个存储桶。
这就是bug所在:Lambda由"存储桶中有新对象"触发,它生成的衍生图也是新对象,写回同一个存储桶后再次触发通知,再次调用Lambda,再次生成衍生图,再次写回……上传一张照片,系统就开始无限处理下去。
每一轮写入两个新对象,每个对象触发各自独立的调用,再各写两个。这不是缓慢泄漏,这是指数级增长。开发者账户没有爆炸的唯一原因是AWS有专门针对这个错误的安全网:检测递归Lambda↔S3调用循环并切断函数。
讽刺的是,开发者只是要两个尺寸的图片,从没要求写回同一存储桶。那是Kiro自己做出的实现选择,一个看起来无懈可击的选择。"生成缩略图,保存到原图旁边"——人类也会这么写。问题恰恰藏在这个"理所当然"里。
S3 事件通知与 Lambda 触发机制
S3 的 ObjectCreated 通知是一种事件驱动的集成方式:当存储桶中新增对象时,S3 会向配置的目标(这里是 Lambda)推送一条事件记录。事件过滤可以通过前缀(prefix)和后缀(suffix)来限定,只对匹配特定命名模式的对象触发。关键在于,任何新对象的写入——无论来源是用户上传还是程序生成——只要匹配过滤规则,都会触发通知。Lambda 侧则通过事件源映射消费这些事件,每次调用是独立、无状态的执行实例。
指数级放大的成本结构
每一轮循环中,Lambda 写回两个新对象,每个对象各自触发一次独立的 Lambda 调用,而每次调用又再生成两个对象。第一轮 2 次调用,第二轮 4 次,第三轮 8 次——调用的数量按 2 的幂次增长。即使单次调用成本以毫秒计费,短短几分钟内也会累积到数千次并发调用,可能耗尽账户的区域级并发配额,并产生不可忽视的 S3 PUT 请求费用。这就是为什么 AWS 会部署专门的递归检测机制作为安全网。
修复方案:切断反馈回路
有几种方法可以打破这个循环:分离存储桶(原图一个桶,衍生图另一个桶);前缀过滤(通知只对特定前缀生效);后缀过滤(处理函数识别自己的输出并立即退出)。
作者最终用了两种方案叠加。首先,命名约定加作用域触发:上传的照片用-orig后缀,衍生图用-thumb.jpg和-display.jpg,S3通知只对-orig后缀触发。Lambda自己的输出永远不以-orig结尾,自然不匹配触发器。
其次,处理函数内部做防御性跳过:检查key是否以-orig结尾,不是就直接返回。即使用户照片放在独立的user-photos/前缀下,与食谱提取流水线监听的originals/前缀完全隔离。
整个修复只有几行代码。整个问题也只有几行代码。
六条真正有价值的教训
1. "部署了、快乐路径跑通了"不等于"可以走开了。" Demo完美运行,但bug只存在于系统的形状中——从输出回到输入的反馈边——快速手动点击永远触及不到。
2. 部署后验证应该看指标,而不只是看结果。 Kiro确实上传了测试图片确认缩略图出现,但它看的是结果,不是系统行为。只要瞥一眼CloudWatch就会发现Invocations数量无限攀升,而非预期的每次上传1次。对于一个症状是"运行次数过多"的bug,信号在指标里,不在输出里。
作者建议的三个动作:部署后观察几分钟调用和并发指标;提前设置CloudWatch告警;启用X-Ray追踪——Lambda的递归循环检测本身就是基于X-Ray追踪头实现的,服务地图会直接画出那个循环。
3. 最危险的决策是你从未明确做出的那些。 要两个尺寸的图,没要求写回同一桶。那个未被提示的实现细节从未出现在指令中,也从未被审查,因为你根本不知道有一个决策被做了。人类会写同样的代码。失败是架构性的,不是语法性的。
4. 了解你连接的服务的地雷。 S3→Lambda循环是经典错误,向自己的表回写的DynamoDB流也是。当你把事件源连接到能产生同类事件的计算时,永远要问:输出会不会变成输入?
5. 让平台的安全网成为最后一道防线,而不是你的方案。 AWS的循环检测确实是设计,不是运气。
6. 分工是真实存在的。 Kiro写了所有量:基础设施代码、处理器、图片缩放逻辑、流水线。它写不出的是判断力——"等等,这个Lambda写进了触发它自己的存储桶。"那部分仍然是人的工作。
X-Ray 追踪与递归检测原理
AWS X-Ray 为分布式请求提供端到端的追踪能力,每个请求被分配一个追踪头(X-Amzn-Trace-Id),沿途经过的每个服务(API Gateway、Lambda、S3 等)都会记录一段子段(subsegment)。Lambda 的递归循环检测正是基于该追踪头实现:当同一个追踪链路上出现重复的 Lambda→S3→Lambda 调用模式时,服务能识别出这是反馈回路,主动停止函数调用。服务地图(Service Map)会把这种循环直观地画出来,让开发者一眼看到异常的调用拓扑。相比从 CloudWatch 日志中拼凑调用链,X-Ray 的可视化能显著缩短定位时间。
CloudWatch 告警的提前设置
合成指标如 Invocations、ConcurrentExecutions、Errors 都可以配置静态或异常检测的告警阈值。对于事件驱动的无服务器架构,建议在部署时同步设置告警,例如当某函数的每分钟调用次数超过预期基线时立即通知,而不是等到账单或安全网触发才发现问题。
这不是灾难,但是个好提醒
说实话,结局并不糟。没有数据丢失,AWS拔掉插头前几千次无意义的图片转换成本只有几美分。重新启用函数、部署防护后,功能一直正常工作。
但这件事提醒我们看清AI辅助开发的真实状态:速度是真实的,一个周末的功能现在一个下午就完成。责任也是真实的,而且它没有转移。Kiro能让你以惊人的速度部署上线,但那次部署是否是个好主意,仍然需要你来做判断——最好是在你被叫去后院之前。
快速构建,委托管道工作,享受杠杆效应。但别把"AI部署了它"和"有人检查了输出是否会回流到输入"混为一谈。
相关推荐

FlexBudget:在统一算力预算下公平比较KV缓存淘汰策略
AMD工程师在PyTorch Conference提出FlexBudget,通过固定kernel和显存预算、只替换KV缓存淘汰规则,实现training-free的公平方法比较,全部基于核心PyTorch实现。

Anthropic 2万亿估值拆解:AI上市潮为何接连折戟
Anthropic寻求2万亿美元估值,相当于史上最大十起科技IPO估值总和。但利率飙升、IPO撤回、TAM通胀、循环融资闭环正在动摇AI上市潮的定价基础。本文拆解2万亿估值背后的逻辑漏洞,以及英伟达为何反而便宜。
Anthropic IPO倒计时:2万亿美元估值背后的算力账本
Anthropic IPO进入倒计时,目标估值最高2万亿美元,较半年前H轮融资翻倍。本文梳理从秘密交表到投资者日的完整时间线,分析2万亿估值背后的算力成本逻辑,以及投资者日真正要回答的核心问题。