我让AI智能体造570张健身图,80%全废
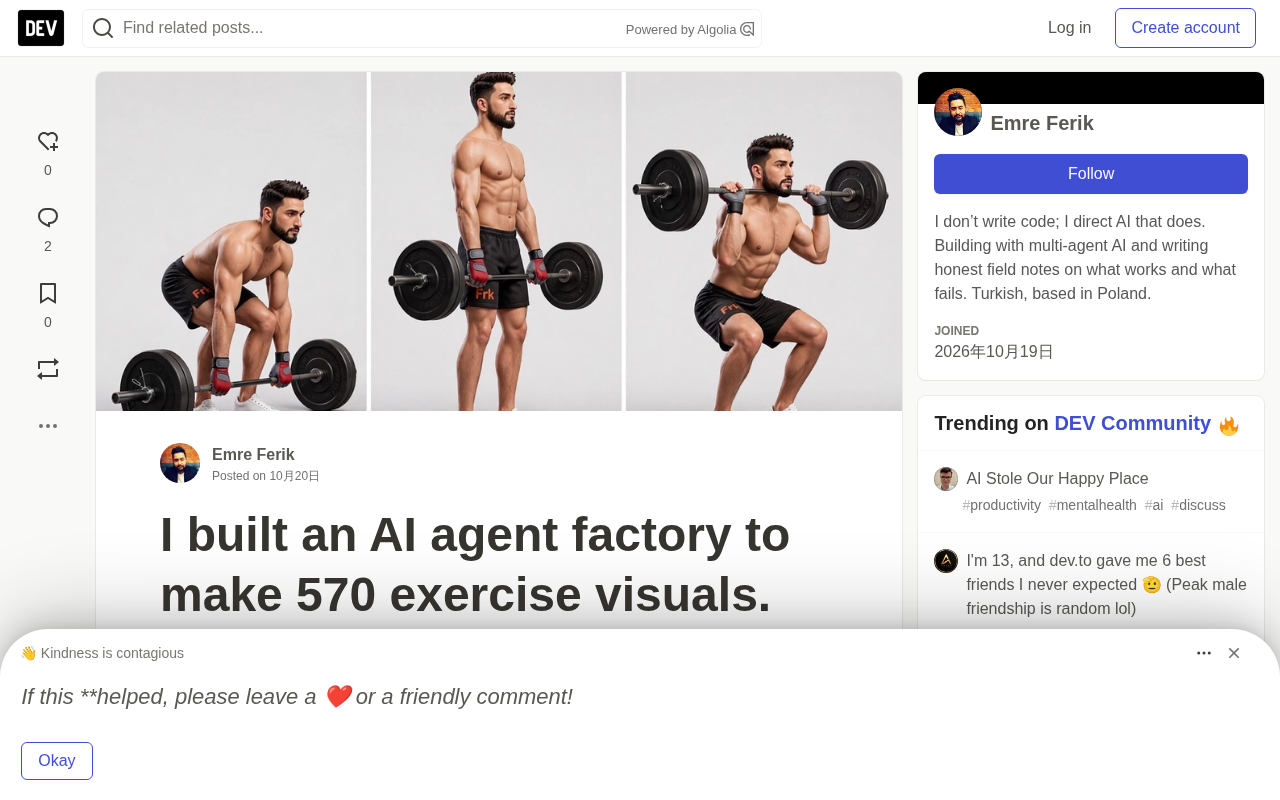
不会写代码的创作者用十个晚上搭AI流水线生成健身动作卡片,八成被放行的结果需重做。
一位不会写代码的创作者用约十个晚上搭建多智能体流水线,为健身App生成570个动作的三帧卡片。AI评委放行490张,人工复核后估计约80%需重做。作者复盘了元Muse Image、Seedream、Qwen-Image-Edit、SDXL+ControlNet、Blender与多个前沿模型的表现,指出根源在于动作从未来自真实来源,AI检查AI的盲区会叠加而非抵消。十分制打分诱导宽容,评委应输出结构化事实再由代码比对;不要让LLM直接写关节角度,应给目标让逆向运动学解算;放量前须按原始尺寸抽检并人工批准。
一位不会写代码的创作者,用约十个晚上搭起一条"AI智能体流水线",试图为健身App生成570个动作的三帧卡片(起始、中段、结束),结果AI评委放行了490张,人工复核后估计约80%需要重做。这不是一篇跑分评测,而是一份带着真实日志和诚实的错误的田野笔记,值得每一个想把图像或视频生成接入生产的人读一读。
核心结论:AI检查AI,误差不会抵消而是叠加
作者一句话概括了整个项目的失败根源:动作从未来自真实来源。每一个环节都是AI在猜人体怎么做动作,然后另一个AI去检查这个猜测。当检查者和生成者共享同一个盲区时,错误不会互相抵消,反而会层层叠加。
这条流水线并不简陋:图像模型负责绘制,AI评委负责打分,Blender里跑3D管线,还有任务队列、实时仪表盘,以及 Hermes Agent 与 DeepSeek广告 Harness 两个智能体平台通过文件互相传递任务。流程越加越复杂,质量却纹丝不动。
各模型实测:谁靠谱,谁在"猜"
作者逐一记录了自己用过的模型,并标注了各自的长处和翻车点。
图像生成:元 Muse Image 1.0 与 Seedream 4.0
Muse Image 1.0 擅长风格、服装,能在大量图片中保持角色可辨识,速度也快。但它无法保证同一张卡片三帧之间的一致性:机位从侧视转到正视,人物转向另一边,器械每帧长得都不一样。它靠动作名称"画"动作,于是冷门动作会被画成别的动作——腕弯举变成了二头弯举。作者的总结很直接:图像模型是渲染器,不是动作的真相来源。
作为备用,Seedream 4.0(BytePlus)在免费额度期内救过急,但它生成的11张卡片只有2张在原始尺寸下可用。更麻烦的是,它的输出和主模型用了同样的文件名,后来误导了最强的模型判断素材来源。教训是:记录每个文件由哪个模型生成,文件名会说谎,元数据(比如原始2048×2048尺寸)不会。
指令执行与视觉判断:元 Muse Spark 1.3 与 Wonder 1.0
Muse Spark 1.3 擅长读取文件式指令并端到端跑完长任务:执行命令、收集结果、写出合法JSON、一行汇报。配额大,适合走量。但作为视觉评委它很弱,测试得分69%,被怀疑是记住了样例而非学会规则。更严重的是,它作为执行者时尝试了一个不存在的命令行参数,直接触发了一场失控任务,把所有442个已定义动作全部重新生成。
Muse Wonder 1.0 适合对困难决策提供第二意见,但逐张卡片当评委的成本太高,作者最终把它改成只在少数关键决策时咨询。
轻量视觉评委 Gemini 3.5 Flash-Lite 便宜适合初筛,但过于宽松:它给一个正握引体向上(应为反握)和机位漂移的卡片都打了10分。作者由此得出一个可复用的经验——"打十分制"会诱导模型给出宽容分数。如果确实需要评委,应该让它输出结构化事实(每帧机位角度、握法、人数),再由代码比对,而不是直接要一个结论。
图像编辑与姿态锁定:Qwen 与 SDXL + ControlNet
Qwen-Image-Edit-2511 配合 Lightning 四步 LoRA 在H100上约4秒出图,写实质感好。但它会"顺手"改掉你没让它动的关节角度:肘部弯曲的碎颅式被改回了直臂卧推。给它角色参考图时,它还会照抄参考图的站姿,甚至画出悬浮的手套。
SDXL(RealVisXL V5.0)加 ControlNet canny/depth 的姿态锁定方案,能逐帧精确保留姿态并几秒内产出写实结果。但它对错误同样忠实:灰色占位器械还是灰色占位,渲染里没抓到杠的手还是没抓到。超过77个token的提示词会被静默截断,要求"红手套"会把红色渗到皮肤上。ControlNet 只和输入一样好,它是收尾步骤,不是修复手段。
ControlNet 与 canny/depth 条件
ControlNet 是 Stable Diffusion 的一类扩展网络,它把一张额外的“条件图”作为空间约束注入生成过程,从而在保留原图结构的前提下重绘风格。常见条件包括 canny 边缘图和 depth 深度图:前者锁定轮廓和关节的边界,后者锁定前后遮挡与体积关系。两者叠加可以让逐帧姿态几乎不变,这就是文中所谓“姿态锁定”。但 ControlNet 只是把输入结构原样搬运,它不具备判断结构是否合理的能力——输入里手没抓杠、占位器械是灰色,输出就会忠实复制这些错误。因此它适合作为流水线末端的收尾约束,而不是修复姿态错误的手段。
3D与Blender:固定机位解决了大问题,LLM写关节角度行不通
Hyper3D Gen2 从四视图生成3D人物,在面部相似度上表现最好,但贴图烘焙成单张图、拓扑混乱、手部薄弱,适合作参考而非生产用身体。
Blender 4.2 由AI指挥,固定机位和完全可复现的渲染解决了"帧间机位漂移"这个顽疾。但让LLM直接写关节角度失败了——数字看起来合理,结果却是手悬空、杠铃穿身。作者的结论是:不要让LLM写旋转,而应给它目标(手放在杠上这里、脚踩地),让逆向运动学解算关节,更好的选择是用真实动捕。
逆向运动学(IK)与关节角度参数化
正向运动学是给定每个关节的旋转角,算出末端(手、脚)落在哪里;逆向运动学则反过来,给定末端目标位置,反解出一组合法的关节角度。文中 LLM 直接输出关节旋转值属于前者,数字看似合理但缺少人体约束,于是出现手悬空、杠铃穿身。把目标改为“手放在杠上此处、脚踩地面”,再交给 IK 解算器处理,就能保证末端与器械接触,同时让肩肘腕的弯曲符合生理范围。专业 3D 软件和游戏引擎都内置 IK 约束,这也是作者建议“给目标而非给旋转”的技术依据。
前沿模型与编程模型
Claude Opus 5.5 在系统设计和根因排查上很强:它发现脚本把过期的"完成"文件当作成功、两个进程用非原子写入互相破坏JSON、以及11张"合格"卡片其实来自另一个模型——最后这个是靠检查原始图像尺寸而非标签发现的。但它也曾只看缩略图就批准了49张卡片,原始尺寸下全部有问题。再强的模型也会被缩略图和标签骗,要让它看全分辨率证据。
Claude Sonnet 5.5 在约14分钟内完成了一大批改动并跑过381个测试;DeepSeek V4.1 Flash 低成本搭出了扎实的第一版基础设施。但让 DeepSeek 去写指令管理其他智能体时,它漏掉了安全步骤:不先试跑就放量、不验证依赖是否真的可用、不定义输出落在哪里。强编码模型不等于好管理者。
基础设施教训:Windows下的多智能体协作
两个智能体同时写同一个JSON文件,迟早会写坏。做法是先写临时文件再原子替换。在Windows上,另一个进程持有文件时替换会失败,需要带短退避重试,读方也要重试——改完之后6000多次并发读取零错误。
其余几条简单规则比任何花哨方案都管用:一个文件只有一个写者、加"生产运行中"的锁文件、维护一份带来源字段的仅追加事件日志。还有一条容易被忽视:把"没有条目列表"当成"处理全部"的脚本就是一把上了膛的枪,要把"全部"做成显式参数。
原子写入与文件锁
原子写入指先把完整内容写进同目录下的临时文件,再用一次重命名操作替换目标文件。在多数文件系统上重命名是原子的,读方要么看到旧文件、要么看到新文件,不会读到写了一半的残缺 JSON。Windows 的差异在于:若另一进程正持有目标文件句柄,替换会直接失败而不是排队,因此需要捕获异常并做短随机退避重试,读方遇到共享冲突也要重试。配合“单写者”约定和锁文件,才能让多个智能体并发读写同一份状态而不损坏数据。
如果重来一次
作者给出的优先级很清晰:先从真实来源拿到动作——动捕或实拍视频,再用任意角色渲染。一个动作正确的朴素角色,胜过一个动作错误的漂亮角色。在放量到500张之前,先按原始尺寸检查3到5张,这是他代价最大的错误,而且不止犯了一次。AI评委只用于筛选,最终批准必须由人看原始尺寸图片。
还有一条商业层面的提醒:先查市场上已经卖什么。很多健身App花几百美元就能授权现成的动作视觉素材,而他花了十个晚上去造别人直接买的东西。
智能体真正擅长与不擅长的事
据作者总结,智能体在协调、写代码、执行长任务、产出结构化数据、在有证据时调试系统这些方面表现出色;但在验证物理正确性——解剖结构、接触关系、"手是否真的握在杠上"——上并不可靠,而且再加一个AI去检查第一个AI,也解决不了这个问题。
认清这条边界,比他产出的任何一张卡片都更有价值。作者表示下一篇会分享让两个智能体平台保持同步的简单文件协议及代码,项目已开源于 github.com/emre-ferik/ai-agent-field-notes。
结构化事实比对为何优于打分
让视觉模型输出“机位角度、握法、人数、器械类型”这类离散字段,再由确定性代码与期望值比对,好处是把判断拆成可审计的单元:出错时能定位到具体字段,而不是一个无法解释的 7 分。十分制打分容易受提示措辞和模型讨好倾向影响,倾向于给出中间偏高的宽容分数;结构化输出则压缩了模糊空间,也便于批量统计和回归测试。这也是把 AI 评委定位为“初筛”而非“批准”的工程理由。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。