WorkBuddy安装与配置保姆级教程:避开C盘坑

WorkBuddy 零基础安装与四项关键设置指南,避坑提速。
本文基于 B 站 UP 主「潘哥」的实操教程,梳理 WorkBuddy 自动化智能体从下载安装到常规配置的关键步骤。安装阶段需特别注意修改默认的 C 盘安装路径,避免软件体积与任务产物占满系统盘。登录后进入系统设置,应迁移默认工作空间存储路径、关闭「体验优化计划」以阻止数据被用于模型训练,并按需调节字体大小。个性化配置中建议选择「高效务实」或「直言不讳」语气,减少讨好式表达带来的 token 消耗,并通过自定义指令固定回答风格与任务执行规则。最后开启「生成对话记忆」,让工具逐步积累用户偏好。整套配置几分钟即可完成,却直接影响后续使用的系统整洁度与模型响应质量。
WorkBuddy 是一款国内可直接下载使用的自动化智能体工具,安装门槛低,但初次配置有几个容易踩坑的细节。本文基于 B 站 UP 主「潘哥」的实操教程,梳理从下载、安装到常规设置的关键步骤,帮助零基础用户把工具调校到顺手状态。
下载与安装:选对版本,绕开系统盘
WorkBuddy广告 官网提供多平台安装包,Windows、Mac、鸿蒙电脑版以及安卓、苹果手机端均可按需选择。安装过程本身没有难点,一路「下一步」即可完成。
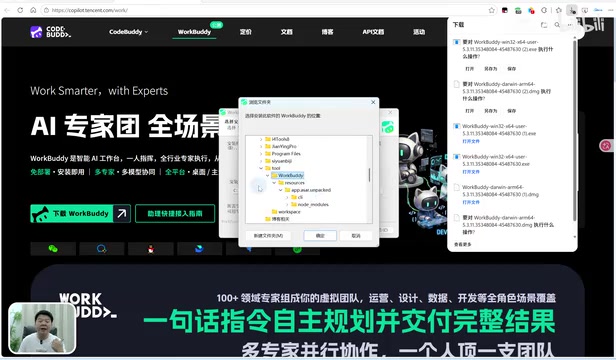
真正需要注意的是安装目录。安装程序默认将软件装在 C 盘,且占用空间较大。C 盘作为系统盘,空间通常更紧张,软件体积加上后续任务产出的文件持续堆积,容易拖慢系统响应。教程中的做法是在 D 盘或 F 盘提前建一个 Tool 目录,安装时点击「浏览」把路径改过去,再点确定继续。
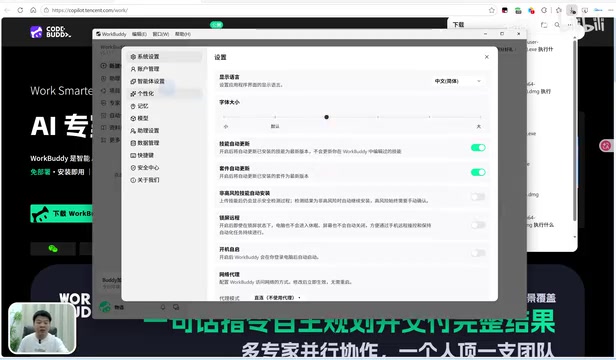
安装完成后首次打开会出现登录窗口,按指引完成登录即可。登录后左下角能看到账号信息,新用户通常还有积分领取入口,点击领取就行。教程还提到,WorkBuddy 内置的混元 HY3 模型目前免费可用,适合上手阶段直接调用。
三项系统设置:存储路径、数据开关、体验优化
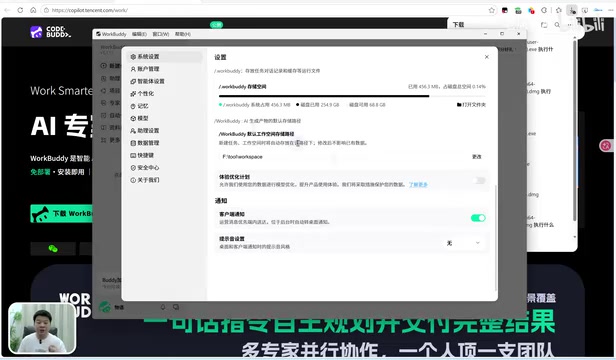
登录后点开账号旁的「设置」,进入系统设置区域。这里最该动的是「默认工作空间存储路径」。默认路径同样指向 C 盘,而 WorkBuddy 执行任务后产生的文件、图片、视频等产物都会存放在该目录下。工程量越大,C 盘越容易被填满。教程建议点「更改」,把路径指向自己规划好的工作空间目录,例如 F 盘 Tool 下的 WorkBase 文件夹。修改后不影响已有数据,只是新建工作空间会自动存到新路径。
第二个开关是「体验优化计划」。开启状态意味着允许官方使用你的数据做模型优化,相当于把使用数据提交上去用于训练。教程给出的建议是直接关掉,避免数据外流。
第三个是字体大小调节。设置里拖动滑块即可放大界面文字,但教程作者认为没必要调得太大,保持默认或适度放大即可。
个性化配置:让模型少说废话
点开「个性化」设置,核心是调整基础语风和语调。大模型默认倾向于用讨好式语言回复,动辄「好问题」「您说得对」,这些客套话同样消耗 token。教程建议在预设风格中选择「高效务实」或「直言不讳」,前者追求最少文字承载最大信息量,后者则直接减少讨好性表达。相对而言,默认风格最为啰嗦,不建议保留。
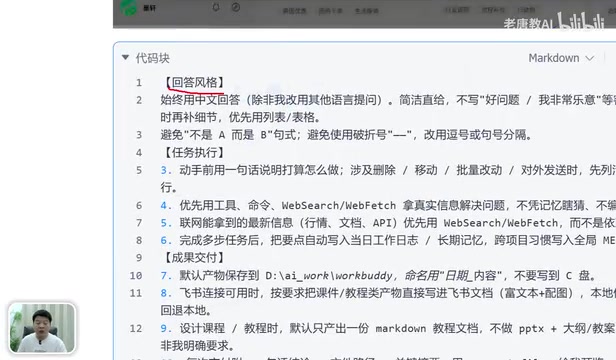
另一个值得配置的是「自定义指令」。AI 工具用久了容易出现回答偏离预期规则的情况,自定义指令就是提前把规则和偏好写死。教程提供了一个可复用的模板,主要包含两部分:一是回答风格约束,例如禁止「不写好问题我非常乐意」这类客套开场,避免「不是 A 而是 B」的句式;二是任务执行规则,用户可随需求替换具体条目。把模板粘贴进自定义指令框,点确认保存即可生效。
Token 与讨好式表达的成本关系
Token 是大模型处理文本的基本计量单位,一个汉字通常对应 1~2 个 token,英文单词则按子词切分计算。模型在生成回复时按 token 逐一预测,每个 token 都计入 API 调用成本与响应时延。因此「好问题」「您说得对」「我非常乐意为您服务」这类礼貌开场并非零成本,它们在语义上不承载有效信息,却实实在在占用上下文窗口和计费额度。当用户把大模型嵌入自动化流程、频繁调用时,这类冗余表达的累积开销不容忽视。文章推荐的「高效务实」与「直言不讳」预设,本质是通过风格约束压缩输出长度、提高单位 token 的信息密度,属于性价比很高的一次性调优动作。
开启记忆功能,让工具越用越顺
最后一步是「记忆」设置。AI 默认没有对话记忆,需要在记忆选项里手动打开「生成对话记忆」,让它自动整理上下文并留存记录。开启后,WorkBuddy 会逐步积累对你的偏好和习惯的理解,后续交互的顺畅度会明显提升。
整套配置可以归纳为四件事:安装时改掉默认 C 盘路径、系统设置里迁移工作空间存储目录、关闭体验优化计划、个性化中选定高效务实的语气并写入自定义指令、记忆里打开对话记忆。这几步花不了几分钟,但直接决定了后续使用中系统盘的整洁度和模型的响应质量。
教程本身聚焦安装与常规设置,画布搭建、接口联动、场景调试等实战内容留待后续课程展开。对零基础用户来说,先把这套基础配置做扎实,是后续落地 AI 自动化的前提。
为什么大模型默认「没有记忆」
大模型的推理是无状态的:每次请求都是一次独立的上下文拼装,模型本身并不保存上一轮对话。用户感觉到的「记得刚才说过什么」,实际是客户端把历史消息一并塞进上下文窗口重新发送的结果。窗口长度有限,对话一长就会被截断,记忆随之丢失。所谓「对话记忆」功能,是在模型之外维护一份持久化的摘要存储——系统定期把历史交互压缩成结构化要点,下次请求时再检索注入。这样既绕开了窗口长度限制,又避免每次都重传全部历史。需要注意的是,记忆内容由系统自动提炼,用户应留意其准确性,必要时手动清理或修正,以免过时偏好长期影响输出。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。