WorkBuddy实测:AI Agent如何让大模型从"给方案"变"干实事"

同一提示词下,豆包只给方案,WorkBuddy执行到底,揭示AI Agent与传统大模型的分水岭。
文章以B站UP主珊瑶老师的演示为切入,对比了普通大模型与AI Agent在批量Word转PDF任务中的表现差异。豆包能迅速生成完整Python脚本却无法操作用户本地文件,扮演的是"顾问"角色;WorkBuddy则在获得用户授权后自动扫描目录、调用工具,7分钟完成4个文档的转换归档,仅消耗6.55积分。作者指出这一差异源于产品定位与技术架构的不同——Agent在推理之上增加了规划、工具调用与执行闭环。同时文章也提醒,WorkBuddy并非万能,简单任务用它足够,复杂工作流仍需更高级的Agent产品,任务复杂度与工具能力的匹配才是选择的关键。
从"顾问"到"执行者":一个批量转换任务揭示的差距
B站UP主珊瑶老师在一期《WorkBuddy广告》课程中,用一个日常办公场景对比了普通大模型产品和AI Agent工具的本质差异。任务本身并不复杂:将本地某目录下的所有Word文档批量转换为PDF,并统一归档到同一个文件夹。
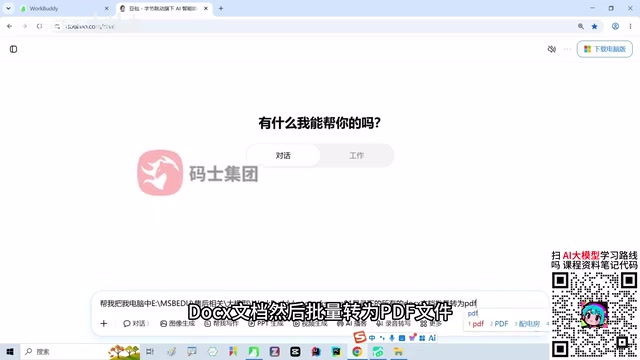
她先把这个需求提给了豆包。豆包的反应很迅速——流式输出了一套完整的Python解决方案,包括依赖安装步骤、完整代码、新建文件的指引,逻辑清晰、步骤明确。但问题在于:豆包的目录下文件纹丝未动,转换工作一步都没执行。
这不是豆包的能力缺陷,而是产品定位使然。普通大模型产品具备理解和推理能力,能分析问题、生成方案,却没有操作本地文件系统的权限。它像一位坐在你旁边的顾问——知道怎么做,也能告诉你每一步该怎么走,但最终动手的人还是你自己。
AI Agent(智能体) 是理解本文差异的关键概念。传统大语言模型(如豆包、ChatGPT)本质上是"文本进、文本出"的推理引擎,其能力边界止于生成内容;而AI Agent则是在大模型的基础上,额外封装了规划、工具调用、记忆和执行四个环节,使其能够与环境交互并完成任务闭环。具体来说,Agent会先拆解用户意图形成执行步骤,再调用文件系统、命令行、浏览器等外部工具逐步落地,遇到报错还能重新规划。本文中豆包给出Python脚本却不执行,正是因为它只是"模型"而非"Agent";WorkBuddy能自动扫描目录、调用转换工具并归档,因为它具备Agent的完整执行链路。理解这一层区别,才能明白为何同样的提示词在两款产品中会产生截然不同的结果。
AI Agent的核心突破:理解之外,还要"动手"
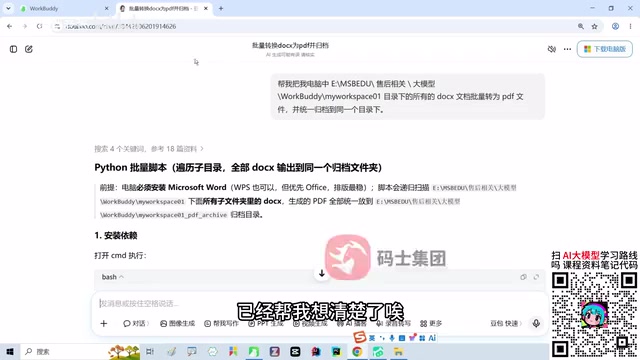
同样的提示词复制到WorkBuddy中,情况完全不同。界面与Codex等工具大同小异,输入需求后点击发送,WorkBuddy开始自动扫描目标目录下的文件。整个过程不需要用户手动检查环境或执行命令,它自行完成了文件识别、环境判断、批量转换和归档操作。
据珊瑶老师演示,四个Word文档在约七分钟内全部转换为PDF并归档到指定文件夹,转换后的文件与原文档内容一致,预览正常。整个任务消耗6.55积分,而WorkBuddy在用户首次登录时赠送2000积分,折算下来完成这类批量操作的成本几乎可以忽略。
更值得关注的是执行过程中的自愈能力。WorkBuddy遇到环境缺失时会尝试安装依赖,步骤失败后重新捕获异常并调整策略。从回答问题到执行任务,从给出建议到交付结果——这才是AI Agent与传统大模型产品的分水岭。
授权与积分:WorkBuddy的运行机制
WorkBuddy能够操作本地文件的前提是用户授予了默认权限。在获得授权后,它可以访问指定目录、查找DOC/DOCX文件、调用系统工具完成格式转换。这与纯云端的大模型服务有本质区别——Agent运行在用户的本地环境中,直接操作文件和命令行。
积分消耗方面,不同任务的复杂度对应不同的积分支出。演示中的批量转换任务消耗6.55积分,而UP主提到推荐新用户注册可获得650积分奖励,这解释了为什么朋友圈中出现大量WorkBuddy的推荐转发。
本地权限授权是Agent类工具能否"动手"的技术前提。像豆包这类纯云端服务运行在厂商的服务器上,物理上无法访问用户硬盘;而WorkBuddy以客户端形式运行在用户电脑中,可以像普通程序一样申请文件读写、进程调用等系统权限。用户在首次使用时授予默认权限,相当于给Agent发放了一张"操作通行证",之后它才能访问指定目录、查找DOC/DOCX文件并调用系统转换组件。需要强调的是,这种授权也带来了安全考量:Agent获得的权限范围直接决定了它能触碰哪些数据,因此业界普遍建议对敏感目录做显式排除。权限模型与积分模型共同构成了Agent产品的运行边界——前者决定"能不能做",后者决定"值不值得做"。
并非万能:AI Agent的适用边界
珊瑶老师在课程中明确指出了一个容易被忽略的事实:WorkBuddy不是唯一的AI Agent产品,也不是所有场景的最优解。
如果你的工作场景相对简单——文件格式转换、批量重命名、简单的归档整理——WorkBuddy这类工具足以应对,且学习成本低。但当工作流涉及更复杂的多步骤协作、跨系统操作或专业领域逻辑时,可能需要考虑更高级的AI Agent产品。
这种分层认知很重要。市面上对WorkBuddy的评价呈现两极分化:有人认为它是效率神器,有人认为它解决不了复杂问题。两种说法都对,关键在于任务复杂度与工具能力的匹配。
UP主在视频中引用了朋友圈的观察:"推荐给另一个人,另一个人用了之后会给你650积分",侧面反映出WorkBuddy的使用率已经在快速攀升。
任务复杂度分层是评价Agent产品时容易被忽视的维度。业界通常把自动化任务分为三层:第一层是单步确定性操作(格式转换、批量重命名),规则明确、容错率高,通用型Agent即可胜任;第二层是多步骤编排(跨应用数据同步、条件分支处理),需要Agent具备较强的规划与异常恢复能力;第三层是跨系统、跨领域的复杂工作流(如企业级RPA、研发流水线),往往需要专门的编排平台或定制Agent。WorkBuddy在演示中表现优异,属于第一层到第二层之间的定位。这也解释了为何市场评价两极分化——用简单任务衡量它的人觉得是神器,用复杂任务衡量它的人觉得不够用。判断一个Agent是否适合你,关键不是看它"强不强",而是看你的任务落在哪一层。
AI Agent的本质:从"回答问题"到"交付结果"
回到那个批量转换的场景。豆包给出了一份Python脚本,WorkBuddy直接产出了四个PDF文件。前者考验的是用户的执行力,后者考验的是Agent的任务理解与工具调用能力。
这个差异看起来不大,但放到日常工作中会被不断放大。每次遇到类似任务,普通大模型用户都需要经历"理解方案→手动配置→执行脚本→检查结果"的循环,而Agent用户只需描述需求、授权、等待结果。省下来的不只是时间,还有认知负担。
WorkBuddy能做的事远不止格式转换。据演示中的描述,它连接了本地文件系统、命令行和各种工具,理论上可以处理任何需要"理解需求+操作电脑"的任务组合。这才是AI Agent真正让人兴奋的地方——它不只是更聪明的聊天机器人,而是一个能实际动手的数字助手。
当然,从"能做事"到"能做好复杂的事",中间还有很长的路。WorkBuddy代表的方向是确定的:大模型正在从信息输出端走向任务执行端,而2026年可能正是这个转变加速的一年。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。