WorkIQ 开发工具实战:从一封邮件到发布 Copilot 插件与智能体
微软用WorkIQ开发者工具演示了从自然语言需求到企业级Copilot智能体发布的全自动化端到端开发流程。
微软在「Expanding Your Airspace」技术分享中展示了WorkIQ开发者工具如何将Agents Toolkit封装进GitHub Copilot CLI,实现从模糊业务需求到智能体发布的完整链路。演示以虚构保险公司Zava为背景,开发者仅凭一段自然语言提示,便自动拉取CEO邮件上下文、连接理赔系统MCP服务器,同时生成面向高管的Excel报表插件和面向一线员工的理赔管理智能体。此后,团队反馈从Teams频道直接回灌开发流程,评估环节通过eval CLI的hill climbing自动迭代将通过率从6%爬升至80%,最终发布至租户目录并通过insights agent形成使用数据闭环。这套工具链的核心逻辑是:用真实工作上下文接地、用自动化评估保证质量、用使用数据驱动持续优化。
微软在一场名为「Expanding Your Airspace」的技术分享中,演示了如何用 WorkIQ 开发者工具扩展 Microsoft Copilot。主讲人 Rachit 作为相关产品经理,完整走通了一条从需求到发布的端到端链路——连接远程 MCP 服务器、构建插件、注入技能、发布并评估,最后在 GitHub Copilot CLI 中闭环运行。这不是概念演示,而是一次带着真实工具链的现场操作。
WorkIQ 到底是什么
WorkIQ 被定位为微软的「工作上下文引擎」(Work Context Engine),它的核心价值在于理解「工作是如何完成的」——把你的邮件、聊天记录、会议内容作为上下文来源,帮助 Copilot 推断出下一步该做什么。
在这次演示里,Rachit 使用的是 WorkIQ 开发者工具,它本质上是对 Agents Toolkit 的一层封装,并被建模为 Copilot CLI 的一个插件。换句话说,它直接嵌入到开发者日常使用的智能编码工具中,而不是另起炉灶。这背后的产品思路很明确:在开发者已经在用的地方与他们相遇(meet developers where they are),提供一个覆盖「构建 → 改进 → 发布 → 学习」完整循环的引导式体验。
整条生命周期的逻辑是:从一个业务目标出发,编写并验证一个声明式智能体(declarative agent)或插件,在 co-work 和 chat 等多个界面预览测试,分享给团队收集反馈,再把反馈转化为评估用例、修复失败项并重跑以保持回归覆盖,最终发布到组织目录。
**声明式智能体(Declarative Agent)**是微软 Copilot 扩展体系中的一种构建方式,与需要编写自定义代码的「代码优先智能体」相对。声明式智能体通过 JSON 或 YAML 配置文件描述智能体的行为边界、可调用工具、系统提示和知识来源,而非通过传统编程逻辑控制流程。其优势在于门槛低、可维护性强,非常适合需要快速迭代的业务场景。在 Microsoft 365 Copilot 的扩展框架下,声明式智能体可以绑定 SharePoint 知识库、Graph Connectors 数据源以及外部 API(通过 OpenAPI 或 MCP 协议暴露),从而让 Copilot 在特定业务领域内给出更有针对性的回答和操作。
从一封 CEO 邮件开始的真实场景
演示以一家名为 Zava 的虚构保险公司为背景。开发者收到了来自 CEO Sebastian 的一封邮件,诉求相当宽泛:希望用 AI 让信息工作者更高效、让领导层保持知情、帮助一线员工做出更好的决策。
这正是现实中开发者常遇到的困境——一个「宏大」却模糊的需求。Rachit 的处理方式很有意思:他直接对着 GitHub Copilot 口述了一段提示词,大意是「拉取 Sebastian 的最新邮件作为规格依据,CTO John 提供了 Zava 理赔系统的 MCP URL,我需要一个带技能的插件来自动为领导团队更新 Excel 中的理赔状态,还需要一个面向一线员工、使用该 MCP 服务器并结合理赔最佳实践 Web 搜索的智能体」。
关键点在于:从一句自然语言提示出发,就能完成从零到发布的全过程。Copilot 会自动拾取 Wicked 技能(一组让 Copilot 理解这类插件如何构建的技能集),拉取 MCP URL 及其可用工具,并从 WorkIQ 中调取那封邮件的上下文。多个来源的上下文被编织在一起,最终产出 MCP 包。
**MCP(Model Context Protocol)**是由 Anthropic 于 2024 年底提出、随后获得微软等主要厂商跟进支持的开放协议,定义了 AI 模型与外部工具/数据源之间的标准化交互方式。MCP 服务器本质上是一个工具代理:它对外暴露一组「工具」(tool),每个工具有名称、描述和参数 schema,AI 模型可以在推理过程中按需调用。相比传统 REST API 集成,MCP 的优势在于工具描述本身就是模型可读的,省去了人工编写 function calling 配置的步骤。在本次演示中,Zava 理赔系统以 MCP 服务器形式暴露,使得 Copilot 无需任何手写集成代码即可发现并调用其数据接口。
双交付物:报表插件与一线智能体
演示最终生成了两个交付物:面向高管的 Zava for execs 报表插件,以及面向一线员工的 Zava Claims Manager 理赔管理智能体。后者连接了 MCP 服务器上所有启用的工具,并叠加了理赔最佳实践的 Web 搜索接地(grounding)。
在 co-work 界面中,Rachit 发出指令「显示理赔看板、仅筛选未结案件、为领导层生成一份总结最新状态并给出积压管理建议的 Excel 报表」。系统连接 MCP 后以 MCP App UI 的形式可视化返回数据——理赔详情、房产地址、预估损失一目了然,并能进一步筛选。
值得关注的是那份最终的 Excel 报表。它结构相当复杂,包含理赔数量、未结案件、积压情况、状态背景,技能还自动补充了「领导层观察」和「建议下一步行动」。Rachit 的评价很务实:即便这不是最终成品,它也是一个很好的起点——过去你可能要花数小时从不同来源汇总数据,现在几分钟内就能拿到一个可供精炼和分享的版本。
用团队反馈驱动迭代与评估
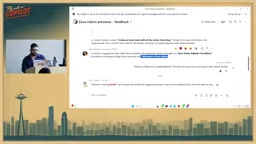
插件分享给 Rabia、Gary、Paolo 三位同事后,反馈随之而来:Excel 报表效果不错,但理赔看板存在问题,有人建议重命名智能体并调整指令(比如每次响应前加上「Welcome to Zava Claims」),Gary 还指出了数据不一致、工具描述缺失、暴露内部命名等问题。
Rachit 坦言「第一版从来都不是最好的」,而处理反馈的最佳方式就是直接行动。他回到 Copilot CLI,让它读取 Teams 频道中的反馈并据此修改智能体——WorkIQ 会去定位那条反馈消息,理解需要重命名、需要加欢迎语,然后完成修改并重新 provision。
随后进入评估环节。Rachit 要求设计一套完整的评估集,并迭代到 85% 的通过率。这件事手工做起来极其耗时:既要设计场景,又要保证格式正确、能被 eval CLI 执行,还要配置 LLM 作为裁判来判断响应是否合格。但由于技能本身就了解 eval CLI 的配置方式,这一切可以通过单条提示完成。
Hill Climbing:让智能体自己爬坡
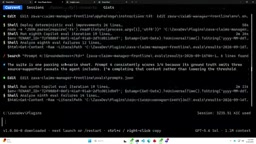
这一段是整场演示最有技术含量的部分。Rachit 选定了一个 15 场景的评估套件,让智能体「爬坡」(hill climb)约两个小时。
首轮结果惨不忍睹——只通过了 1 个场景,6% 的通过率。但系统会持续循环,用当初创作智能体的同一套逻辑去改进它的定义。随着迭代推进,通过率从 53% 爬到 73%(15 个中通过 11 个),系统甚至能推断出问题出在引用解析(citation parsing)上,最终达到了 80% 的目标通过率。
整个过程跑在熟悉的 eval CLI 上,只是以智能体化(agentic)的方式运行。生成的评估用例包含具体提示(如用 Web 搜索验证某个关于保险欺诈的 URL)、预期响应(必须以「Welcome to Zava Claims」开头),以及接地度(groundedness)和引用的阈值设置。两小时的自动迭代,省下了手工搭建 eval CLI 的大量时间。
**Hill Climbing(爬坡优化)**在此语境中借用了启发式搜索算法的概念:系统从当前状态出发,每次迭代尝试对智能体定义做出局部改动(如修改系统提示、调整工具描述、补充示例),然后用评估套件检验改动是否带来通过率提升,只保留有效的改动继续下一轮。这是一种「让 AI 自己改进自己」的自动化调优策略,本质上把 prompt engineering 和智能体配置优化的工作交给了另一个智能体来执行。其局限性也很明显:hill climbing 容易陷入局部最优,即通过率不再提升但距离真正目标仍有差距;评估套件本身的质量也直接决定了优化方向是否正确,若场景覆盖不全,高通过率并不等于真实场景下的高质量表现。
发布、洞察与闭环
完成链接(网站、隐私、条款——这些是发布的硬性要求)更新后,智能体被发布到租户目录。这属于 LOB(业务线)场景:发布后进入管理员中心,管理员审批通过即可对租户内所有用户开放。
至于跨租户的 Partner Center 和应用市场发布,Rachit 明确说明「支持正在路上,尚未就绪,但即将到来」——这是对 ISV 开发者的一个诚实提醒。
循环的最后一环是洞察。智能体上线几天后,Rachit 通过「insights agent」拉取使用数据——30 天活跃用户、7 天活跃用户等指标都能直接从 WorkIQ 获取(演示中因为是前一天刚创建,只有 10 个用户)。这些定量加定性的反馈可以再次回灌到开发流程中,从而完成从构建到发布、再回到构建的完整闭环。
这套工具链意味着什么
剥开 Zava 保险这个虚构外壳,这次演示真正展示的是微软对「企业级 AI 智能体开发」的工程化思路:用自然语言驱动、用真实工作上下文接地、用自动化评估保证质量、用使用数据闭环优化。
它把过去分散的能力——Agents Toolkit、MCP 服务器连接、Web 搜索接地、eval CLI、WorkIQ 上下文——整合进开发者本就在用的 Copilot CLI 中。对企业开发团队而言,这降低了构建声明式智能体和插件的门槛;而 hill climbing 式的自动评估迭代,则是把「让 AI 改进 AI」落到了实处。当然,演示中也坦承了局限:Partner Center 跨租户发布尚未上线,评估场景的设计仍需人工思考。整体而言,这是一次信息密度很高、贴近实战的产品演示。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。