WRDO:用加权拒绝方向优化突破大模型安全对齐

WRDO 用学习到的加权聚合替代均值差单一方向,更精细地操纵大模型拒绝行为。
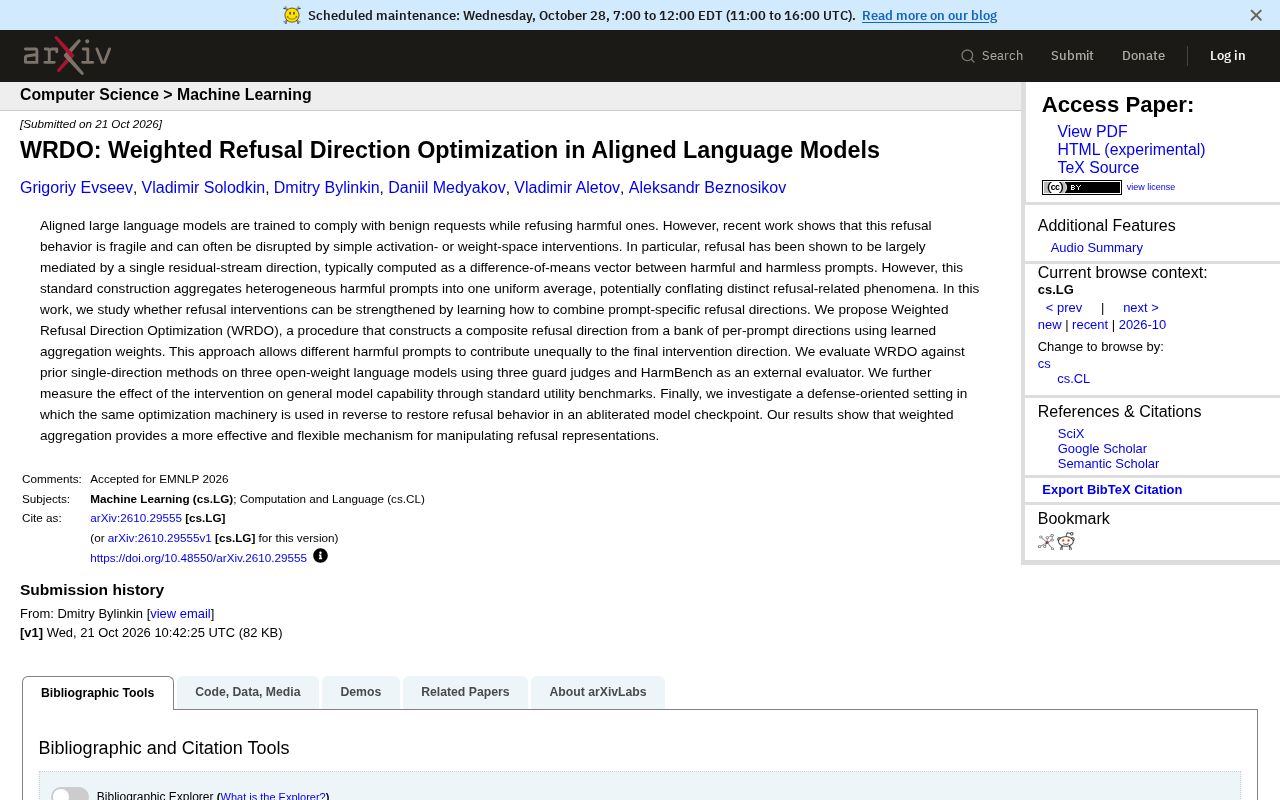
WRDO(Weighted Refusal Direction Optimization)针对大语言模型拒绝行为由残差流单一方向介导这一共识,指出传统均值差向量将异构有害提示等权平均、抹平类别间机制差异的缺陷。该方法构建逐提示拒绝方向库,通过学习到的聚合权重加权求和,形成复合干预方向,使不同有害提示对最终方向产生不等贡献。在三个开放权重模型上,以三个防护评判器和 HarmBench 外部评估器验证,加权聚合在攻击成功率和模型效用保持上均优于单一方向方法。同一优化机制还可反向使用,在 abliterated 检查点上恢复拒绝行为,兼具红队测试与对齐修复的双向潜力。
引言:对齐模型的“拒绝”为何如此脆弱
对齐后的大型语言模型被训练成既能满足良性请求,又能拒绝有害请求。但近期研究揭示了一个令人不安的事实:这种拒绝行为出奇地脆弱。简单的激活空间或权重空间干预就足以破坏模型的拒答能力,甚至让本应拒绝的有害请求获得回应。
背后的机制已有共识:拒绝行为很大程度上由残差流中的单一方向介导,通常用有害提示与无害提示之间的“均值差向量”来计算。这个发现既揭示了模型内部拒绝表示的简洁性,也暴露了其脆弱性——只要沿着这个方向做干预,就能削弱或增强拒绝。
然而,标准做法将所有异构的有害提示聚合为一个均匀的平均向量,这可能将不同的拒绝相关现象混为一谈。WRDO(Weighted Refusal Direction Optimization)正是针对这一缺陷提出的改进方案。
残差流(residual stream) 是 Transformer 架构中的一个核心概念。每一层的输出都会与输入相加(残差连接),形成一条贯穿整个网络的信息主干道。研究表明,模型的高层语义特征——包括拒绝意图——往往在这条残差流中表现为线性可分的方向。所谓“激活空间干预”,就是在前向传播过程中,向残差流注入一个特定方向的向量,从而系统性地增强或抑制某种行为(如拒绝)。这种干预无需修改权重,只需在推理时操作激活值,因此实现简单、效果直接,也正是拒绝行为显得“脆弱”的技术根源之一。
从单一方向到加权聚合:WRDO 的核心思路
WRDO 的基本出发点是:不同有害提示对拒绝行为的贡献不应被同等对待。与其用一个平均向量代表所有有害提示,不如学习一组聚合权重,将每个提示特定的拒绝方向组合成一个复合方向。
具体而言,该方法构建一个包含逐提示拒绝方向的“方向库”,然后通过学习的聚合权重,将这些方向加权求和,得到最终的干预方向。这允许不同有害提示对最终干预方向产生不等的贡献,从而更精细地操纵拒绝表示。
这一设计在思路上并不复杂,但它直指均值差向量的关键局限:平均化会抹平异质性。当有害提示涵盖暴力、欺诈、隐私侵犯等不同类别时,它们的拒绝表示可能受不同机制驱动,强行取平均会稀释甚至扭曲干预效果。
均值差向量(mean-difference vector) 是拒绝方向研究中最常用的构造方式:分别收集模型对一组有害提示和一组无害提示的残差流激活,计算两类激活的均值,再将两者相减,得到一个指向“拒绝”的方向。该方法的假设是:拒绝行为在该方向上具有最大可分性。然而,均值差本质上是一种线性判别,它默认所有有害提示共享同一拒绝机制。当提示在语义类别上高度异质时,这一假设会失效——不同类别的拒绝信号可能分布在不同的子方向上,简单相减会将这些信号混合甚至抵消。WRDO 用加权聚合替代等权平均,正是为了保留这种子方向结构。
实验设计与评估维度
论文在三个开放权重语言模型上对比了 WRDO 与先前的单一方向方法,评估体系兼顾攻击效果与模型能力保持:
- 三个防护评判器(guard judges):作为内部评估工具,从多个角度判断拒绝是否被成功绕过。
- HarmBench 作为外部评估器:提供独立的攻击成功率度量,避免自评偏差。
- 标准效用基准:测量干预对模型通用能力的影响,确保攻击不是以严重损害模型可用性为代价。
这种“攻击有效性 + 能力保持 + 外部交叉验证”的组合,使结论比单一指标更具说服力。
HarmBench 是一个标准化的对抗性攻击评测框架,提供统一的攻击提示集、目标模型接口和成功判定规则,广泛用于衡量越狱攻击的有效性。它通常包含多类有害行为(如网络犯罪、化学武器、虚假信息等),并要求攻击方法在给定查询预算下最大化攻击成功率。与模型内部的防护评判器不同,HarmBench 的判定规则和提示集对被测方法保持独立,因此能作为外部交叉验证,降低“自评偏差”的风险。在本研究中,HarmBench 的攻击成功率与三个防护评判器的结论相互印证,增强了“加权聚合优于单一方向”这一结论的可信度。
一个方法,两个方向:攻防一体的优化框架
WRDO 有意思的地方在于它的可逆性。同一套优化机制不仅可以正向使用——削弱拒绝、提升攻击成功率,还可以反向使用:在一个已被“abliterated”(拒绝行为被移除)的模型检查点上,恢复其拒绝行为。
这使 WRDO 超越了单纯的越狱工具定位,成为一种双向的拒绝表示操纵机制。对安全研究而言,这意味着同一个优化框架既能用于红队测试,也能用于对齐修复,具备防御导向的应用潜力。
实验结果支持这一判断:加权聚合提供了一种更有效也更灵活的拒绝表示操纵机制,优于固定的单一方向干预。
Abliteration 是近期社区实践中出现的一类技术:通过权重正交化或激活消融,系统性地移除模型的拒绝行为,得到一个“无拒绝”检查点。常见的做法是计算拒绝方向后,将与该方向相关的权重投影掉,使模型不再沿该方向产生拒绝信号。Abliterated 模型通常仍保留语言能力,但对有害请求几乎不设防。WRDO 的反向使用正是在这类检查点上进行的:既然拒绝行为已被移除,就可以用同一套加权聚合优化来重新注入拒绝方向,恢复模型的安全行为。这使 WRDO 不仅是攻击工具,也成为研究对齐可修复性的实验平台。
安全启示:拒绝表示的精细化操纵意味着什么
WRDO 的价值不只在方法层面,更在于它传递的安全信号。如果拒绝行为可以被一组学习到的权重精细调控,那么对齐的稳健性评估就不能只依赖“是否存在一个拒绝方向”这样的粗粒度判断。
对模型开发者来说,这意味着需要关注拒绝表示在不同有害类别间的异质性,单一平均向量的防御假设可能过于乐观。对安全评估者来说,WRDO 提供了一种更强的攻击基线,也提供了修复被破坏对齐的可行路径。
论文没有给出跨模型规模的普适性结论,三个开放权重模型的实验范围也有限,但“加权优于单一方向”这一核心发现,为后续的拒绝表示研究提供了一个清晰的方向:从平均走向加权,从单一走向组合。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。