吴恩达谈Agentic AI:拨开炒作看真正有价值的智能体开发
吴恩达新课揭示:Agentic AI真正的价值在于评估驱动的工程纪律,而非营销炒作。
吴恩达在其Agentic AI课程导论中区分了炒作与真实价值:虽然"智能体"一词被营销滥用,但真正有价值的智能体应用正在客服、深度研究、法律文书、医疗诊断等领域快速落地,且某些项目离开智能体工作流根本无法完成。课程的核心洞察在于:优秀智能体开发者与普通开发者之间最大的差距,不在于使用了多复杂的框架,而在于能否建立以evals(评估)和error analysis(错误分析)为核心的规范化、数据驱动的开发流程。这种"以评估驱动迭代"的工程方法论,是从"会调用大模型"跨越到"能构建可靠智能体系统"的关键。
Agentic AI:从热词到真实价值
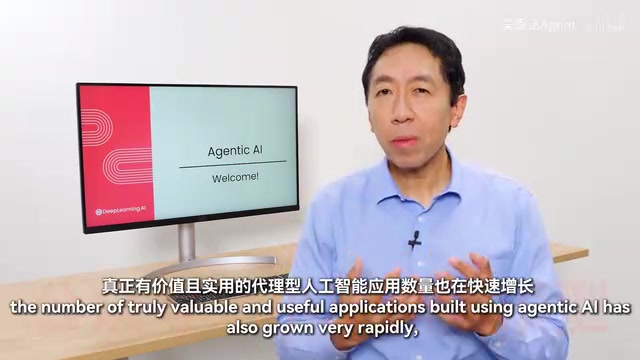
吴恩达在其全新的 Agentic AI 课程开篇坦言,当他最初提出 "agentic"(智能体化)这个词来描述人们构建大模型应用的一种重要且快速增长的趋势时,并没有预料到它会被大批营销人员当成"贴纸",贴到几乎所有产品上。结果就是围绕 Agentic AI 的炒作急剧膨胀。
不过好消息是,如果抛开这些营销噪音,真正有价值、真正有用的智能体应用数量也在快速增长——尽管增速可能没有炒作那么夸张。这条判断为整门课程定下了基调:不谈虚火,只讲能落地的东西。
智能体工作流正在解决哪些真实问题
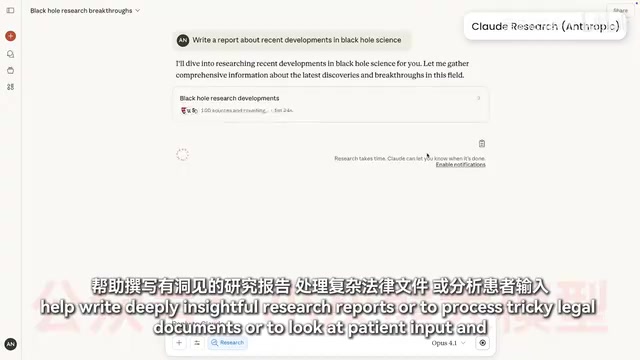
吴恩达列举了当下 agentic workflow(智能体工作流)已经在承担的实际任务:构建客户支持智能体、进行深度研究(deep research)以撰写有洞察力的研究报告、处理复杂的法律文书,以及分析患者输入并给出可能的医疗诊断建议。
他特别强调,在他带领的很多团队中,有大量项目如果没有智能体工作流根本无法完成。这句话的分量在于:智能体不再只是"锦上添花"的功能,而是某些应用得以存在的前提条件。这也是为什么他把"知道如何用智能体工作流构建应用"称为当今 AI 领域最重要、最有价值的技能之一。
智能体工作流(Agentic Workflow) 是指让大语言模型以循环、多步骤的方式运作,而非一次性生成输出。典型模式包括:让模型先生成计划再逐步执行、调用外部工具(搜索、代码解释器、数据库查询等)获取实时信息、多个专职子智能体协作分工,以及通过自我反思(reflection)对输出进行修订。相较于单轮提问-回答,这种架构能够处理需要分解、验证和迭代的复杂任务,但也引入了更高的延迟、成本和错误传播风险,这正是评估能力变得不可或缺的根本原因。
高手与普通开发者的核心差距:评估与错误分析
课程中最值得关注的观点,是吴恩达对"什么样的人才真正擅长构建智能体工作流"的回答。
他观察到,那些真正懂得构建 agentic workflow 的人,与效果较差的开发者之间最大的区别,在于是否能够推动一个"有纪律的开发流程"(disciplined development process),并且这个流程要专门聚焦于 evals(评估) 和 error analysis(错误分析)。
为什么 evals 和错误分析如此关键
智能体系统往往涉及多步推理、工具调用与外部交互,任何一环出错都可能导致最终结果偏离预期。与传统软件不同,智能体的行为具有一定的不确定性,仅靠"跑一遍看结果"很难判断系统好坏。
评估(evals)提供了一套可量化、可复现的方式来衡量智能体表现;而错误分析则帮助开发者定位问题究竟出在提示词、工具设计、规划逻辑还是模型本身。吴恩达认为,正是这种系统化、数据驱动的调试能力,把优秀的智能体开发者和其他人区分开来。这一理念其实延续了他一贯倡导的"以评估驱动迭代"的机器学习工程方法论。
Evals(评估) 在大模型工程中通常指一套测试集和评分机制,用于系统地衡量模型或智能体在特定任务上的表现。与传统单元测试不同,evals 需要应对输出的开放性——同一个问题可能有多种"正确"回答,因此评分函数本身往往也需要精心设计,甚至借助另一个 LLM 来打分(即"LLM-as-judge"模式)。错误分析(error analysis) 则是机器学习工程中的经典方法:随机抽取一批失败案例,手动审查并归类错误根因,从而决定优先修复哪个子问题。这两项能力组合在一起,构成了一个可持续迭代的"度量—分析—改进"闭环,是将智能体从原型推向生产可靠性的必要工程基础。
这项技能为什么值得学
吴恩达把掌握智能体工作流开发定位为"当今 AI 领域最重要的技能之一",并直言这会带来更多机会——无论是求职机会,还是自己动手构建出色软件的机会。
对于希望入门大模型应用开发的学习者来说,这门课程给出的路径很清晰:不要被炒作牵着走,把精力放在真正能创造价值的应用场景上;同时建立起以评估和错误分析为核心的工程纪律。这两点合在一起,构成了从"会调用大模型"到"能构建可靠智能体系统"的关键跨越。
小结
这段课程导论虽然篇幅不长,但清晰传达了三个核心信息:Agentic AI 的炒作与真实价值需要区分看待;智能体工作流已经在客服、深度研究、法律、医疗等领域产生不可替代的作用;而决定开发者水平高低的关键,是能否建立以 evals 和 error analysis 为核心的规范化开发流程。对于想在大模型时代提升竞争力的开发者,这是一条务实且高回报的学习方向。
相关推荐
Claude Code v2.1.276 发布:修复代理网关 400 报错回归问题
Claude Code v2.1.276 发布,修复了 v2.1.275 中通过代理或网关访问时每次请求都返回 400 报错(Input tag 'advisor_20260301')的回归问题,代理接入用户建议尽快升级。
Netflix微服务神话:一场被全行业误解的架构迁移
Netflix从2008年三天宕机到全面上云并重建微服务的真实历程,与大众记忆存在明显偏差。本文还原其上云真正动机、微服务解决的"部署冲突"问题,以及为何全行业盲目复制其架构却抄错了对象——从Segment、Shopify到Prime Video的案例揭示架构选择的本质。
Java 27 深度解析:默认变更如何悄悄改变生产环境
Java 27 仅 9 个 JEP 却改动了多项默认配置:紧凑对象头默认开启、G1 成无条件默认回收器、Flight Recorder 敏感信息脱敏、TLS 1.3 内建抗量子加密。深度解析这些变化如何影响生产环境。