五个Qwen3.8-27B模型组团追平Fable 5?GVS5H测试框架引热议
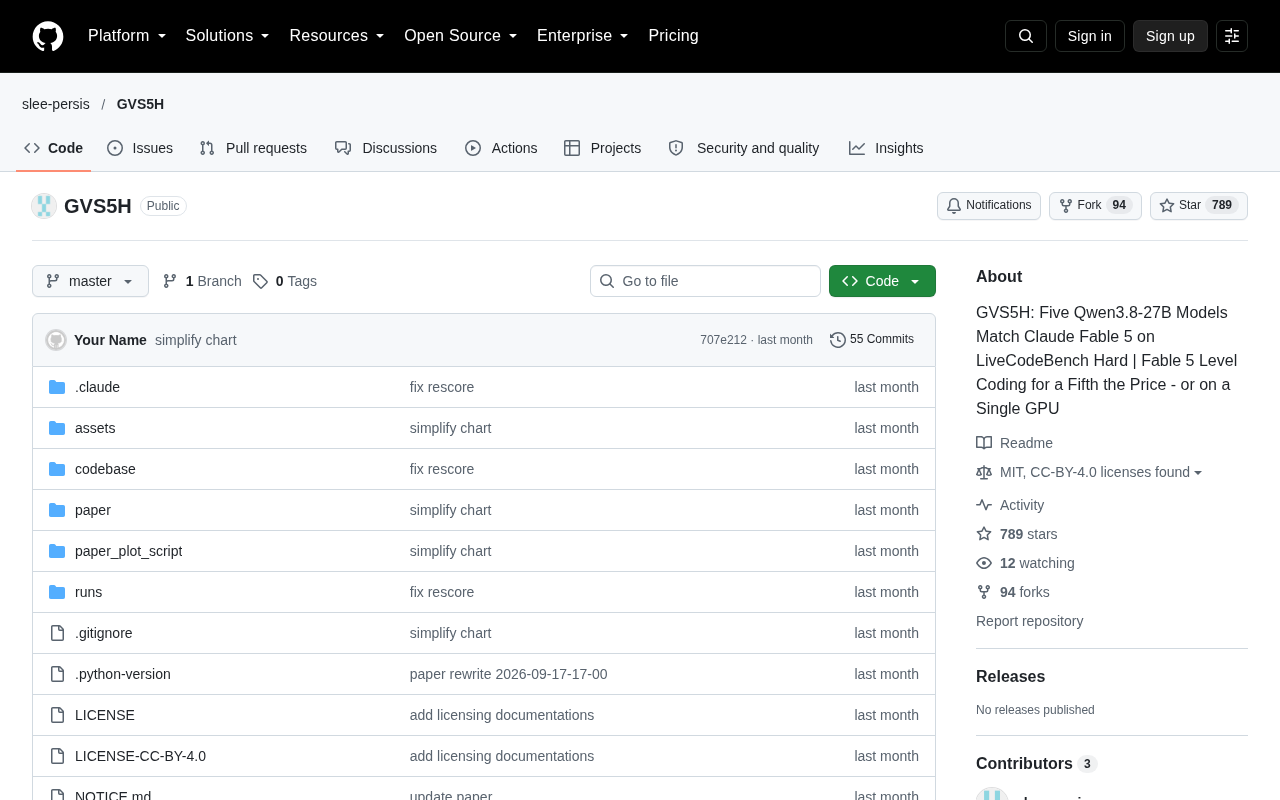
一条缺乏细节的爆料引出开源小模型集成能力与评测可信度的双重追问。
文章以 Hacker News 上一条简短爆料为切口,讨论「五个 Qwen3.8-27B 模型借助 GVS5H Harness 追平 Fable 5」这一说法背后的技术问题。作者指出,标题最合理的解读是多模型集成或多智能体协作,该思路在工程上可行且成本低于调用闭源旗舰模型,但对系统性错误无效。更关键的缺口在于对比基准 Fable 5 身份不明、评测框架 GVS5H Harness 配置未公开,导致结论无法复现。社区分歧集中在证据质量与技术方向两个层面,二者并不矛盾。文章最后给出对开发者的三点启示,并强调在细节公开前应将该结论视为待验证假设。
引言:一条简短爆料背后的模型能力之争
Hacker News上出现了一条信息量极简却引发讨论的帖子:「五个Qwen3.8-27B模型借助GVS5H Harness追平Fable 5」。帖子只拿到60个点赞和15条评论,但这条标题里密集堆叠的名词——Qwen3.8-27B、Fable 5、GVS5H Harness——恰好戳中了当前AI社区最敏感的两个话题:开源小模型的能力上限,以及评测基准本身是否可信。
由于原帖没有给出任何技术细节,本文不打算复述一个无法验证的结论,而是把这条爆料当作切口,拆解它背后值得关注的三个问题:多模型协同是否真能弥补单体模型差距、GVS5H这类评测工具有多可靠、以及社区为何对"追平"叙事又爱又疑。
五个模型顶一个:集成思路的合理性
从字面看,「五个Qwen3.8-27B模型追平Fable 5」最直接的解读是某种集成(ensemble)或多智能体协作策略:让多个参数量约27B的Qwen3.8实例分别产出结果,再通过投票、路由或辩论机制融合成最终答案。
这个思路在工程上并不新鲜。27B级别的模型在单卡或双卡消费级硬件上即可运行,五个实例并行推理的成本仍远低于调用一个闭源旗舰模型。如果通过多数投票能把正确率推到接近更强模型的水准,那对预算受限的团队来说是一条现实路径。代价同样明显:推理开销成倍增长、延迟上升、融合逻辑本身需要调优,而且集成对"知识型"问题的增益通常大于"推理型"问题——如果五个模型犯的是同一个系统性错误,投票也无济于事。
需要说明的是,原帖没有披露具体的融合方式,因此这只能视为对标题最合理的一种技术推测,而非已确认的事实。
多智能体辩论(Multi-Agent Debate) 是集成策略中较有代表性的一种:让多个模型实例就同一问题各自给出答案与推理过程,再相互审阅、反驳,经过若干轮后收敛到共识答案。与简单的多数投票相比,辩论机制的好处是能暴露单个模型的推理漏洞,但代价是 token 消耗随轮数呈平方级增长。另一种常见做法是 路由(routing):训练一个小型分类器判断问题类型,只把难题分发给多个实例,简单题仍由单模型处理,以控制平均成本。此外还有 自洽性采样(self-consistency),即对同一模型多次采样不同推理路径后投票,它不需要多个独立模型,但收益上限受限于单模型的能力边界。理解这些机制的差异,有助于判断「五个模型」究竟带来的是多样性增益还是单纯的算力堆叠。
Fable 5是什么:对比基准的模糊地带
「Fable 5」这个名字在主流公开榜单中并不常见,原帖也未加说明。它可能指某个特定版本的闭源模型、某个内部代号,或者社区自建的参考模型。对比对象不清晰,是这类爆款标题最典型的信息缺口。
这恰恰暴露了当前模型评测的一个普遍困境:"追平某某模型"的表述极具传播力,但只有在双方使用完全相同的提示词、相同的评分标准、相同的任务集时才成立。一旦评测方自行选择对比样本,结论的可迁移性就要打折扣。读者在转发这类结论前,至少应该追问一句:追平的是哪些任务?在什么条件下测的?
GVS5H Harness:评测工具的可信度问题
标题中的第三个关键词「GVS5H Harness」同样缺乏公开资料。从命名结构看,它是一个评测框架或测试台(harness),负责把模型接入统一的任务流程并输出可比较的分数。
评测框架在AI工程中的角色常被低估。同一个模型在不同harness下跑出的分数可能相差甚远,差异来源包括提示词模板、few-shot示例数量、答案抽取规则、以及是否允许工具调用。这意味着「使用GVS5H Harness」这个限定条件不是可有可无的脚注,而是结论成立的前提。如果该harness的配置未公开,外部就无法复现,也就不具备科学意义上的证据力。
Harness 与 Benchmark 的区别值得厘清:benchmark 指的是任务集与评分标准(如 MMLU、GSM8K),而 harness 是执行这些任务的软件框架,负责加载题目、构造提示词、调用模型 API、解析输出并判定对错。同一 benchmark 在不同 harness 下分数不同,主要源于几个可调参数:提示词是零样本还是少样本、是否要求模型输出思维链、答案抽取用正则还是让裁判模型打分、温度与最大 token 数如何设置、以及超时或解析失败时是否重试。因此严谨的评测报告应当公开 harness 名称、版本号与完整配置文件,否则「在某 harness 上得分 X」只是一句无法复核的孤证。
社区的两种声音
从15条评论的讨论氛围(以及Hacker News一贯的风格)推断,反馈大致分为两派。一派持谨慎怀疑:缺乏细节、缺乏复现步骤、对比对象不明,这类帖子更像是吸引眼球的标题党。另一派则认为方向本身值得关注——小参数模型通过组合策略逼近大模型能力,是降低AI应用门槛的关键路径,哪怕当前证据薄弱,也值得投入验证。
两种声音并不矛盾。怀疑针对的是证据质量,兴趣针对的是技术方向。健康的社区讨论应当同时容纳这两者:既不因结论未证实就否定方向,也不因方向诱人就放松验证标准。
Hacker News 的投票与评论机制本身会影响讨论形态:帖子早期获得的点赞数决定了它能否进入首页,而评论区的排序又倾向于高争议性的回复,因此「60 点赞、15 评论」这样的小样本往往放大的是最尖锐的对立观点,而非最具代表性的共识。这也解释了为何此类缺乏细节的爆料容易形成两极评价——读者在信息不足时只能依据对信息源的整体信任度做判断,而非依据证据本身。
对开发者的实际启示
抛开这条爆料本身的可信度,它至少提示了三件可以落地的事。其一,27B级别的开源模型已经进入"可组合使用"的实用区间,团队在做成本优化时可以把集成方案纳入候选,而不是只盯着单模型升级。其二,任何评测结论都必须绑定具体harness配置,内部做模型选型时应自建可复现的评测流水线,而不是直接采信外部榜单。其三,面对"追平"类消息,养成追问任务集与评分配置的习惯,比记住结论更有价值。
结语
这条Hacker News帖子的信息量确实单薄,但它浓缩了当下AI社区的核心张力:开源模型能力快速逼近、评测方法却尚未跟上,两者之间的落差正是争议的温床。在GVS5H Harness的配置和对比基准的细节公开之前,"五个Qwen3.8-27B追平Fable 5"应当被当作一个待验证的假设,而非既定事实。
相关推荐

Claude Code 新手避坑指南:桌面版上手与6个关键设置
Claude Code 桌面版上手教程:讲解付费门槛、Opus 规划与 Sonnet 施工的模型分工、工作区文件夹选择、审批规则、claude.md 常驻规则、compact 会话压缩等新手最易踩坑的六个设置,并附四个实战项目演示。
Anthropic安全限制引众怒:开发者逆向电视被拒,社区分享绕行技巧
Anthropic安全限制阻止用户逆向工程电视,引发Reddit社区热议。开发者分享绕过技巧,讨论AI安全与开源的博弈,以及用户转向中国模型的趋势。

Reddit 神帖:想快乐活过此生,必须避开的几个陷阱
Reddit 热帖引发对快乐生活的集体思考:社区共识指出需避开社交媒体比较、消耗型关系与消费主义陷阱,同时呈现职业选择与经济安全的分歧。本文提炼讨论精华,并延伸至科技从业者的避坑启示。